02.8.2
異常検知②
value から np.sin(v) + np.cos(v) で作った 2 列目 value2 を足し、2 次元になった時系列に ADTK の OutlierDetector(中身は scikit-learn の LocalOutlierFactor)・RegressionAD(LinearRegression で value2 を予測し残差を見る)・PcaAD(k=2) の 3 つを当てます。読み終えると、多次元の異常検知では「1 列の値が大きい」ではなく「列どうしの関係がいつもと違う」を異常とみなすこと、そして PcaAD の k を列数と同じにすると再構成誤差が 0 になって何も検出できなくなることが分かります。- 異常検知① (ADTK) の概念を先に学ぶと理解がスムーズです
直感 #
体温 38 ℃ は単独では発熱ですが、「運動直後」という 2 列目があれば正常です。多次元の異常検知はこの発想で、value と value2 を別々に見るのではなく、2 つの組み合わせがいつもの関係から外れた点を探します。OutlierDetector は 2 次元平面で周りより密度が低い点を、RegressionAD は value から予測した value2 と実際の差が大きい点を、PcaAD は主成分で表しきれない点を、それぞれ異常と呼びます。同じ値でも時間帯や他の列との関係で意味が変わるケースを、検出器の組み合わせで表現できます。
何が起きているか(ステップで見る) #
コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。下の図は同じ章の Isolation Forest が 2 次元平面の外れ値を孤立させる様子で、このページの OutlierDetector も value と value2 の 2 次元平面で「周りに仲間が少ない点」を探します。
見るポイント:少ない回数で孤立する点ほど異常。外れ値(赤)は 1 回の分割で 1 点になるが、密集した点(青)は 8 回切っても 5 点が残る。LocalOutlierFactor は分割の代わりに近傍 20 点の密度を比べて、同じ「孤立した点」を見つける。
詳細な解説 #
Anomaly Detection Toolkit (ADTK) を使い、今度は複数次元のデータに異常検知を適用します。次のコードは 異常検知① と同じ CSV を今度は DataFrame として読み込み、value から 2 列目を作ります。
| |
| value | value2 | |
|---|---|---|
| timestamp | ||
| 2014-04-01 00:00:00 | 18.090486 | 0.037230 |
| 2014-04-01 00:05:00 | 20.359843 | 1.058643 |
| 2014-04-01 00:10:00 | 21.105470 | 0.141581 |
| 2014-04-01 00:15:00 | 21.151585 | 0.076564 |
| 2014-04-01 00:20:00 | 18.137141 | 0.103122 |
| ... | ... | ... |
| 2014-04-14 23:35:00 | 18.269290 | 0.288071 |
| 2014-04-14 23:40:00 | 19.087351 | 1.207420 |
| 2014-04-14 23:45:00 | 19.594689 | 1.413067 |
| 2014-04-14 23:50:00 | 19.767817 | 1.401750 |
| 2014-04-14 23:55:00 | 20.479156 | 0.939501 |
4032 rows × 2 columns
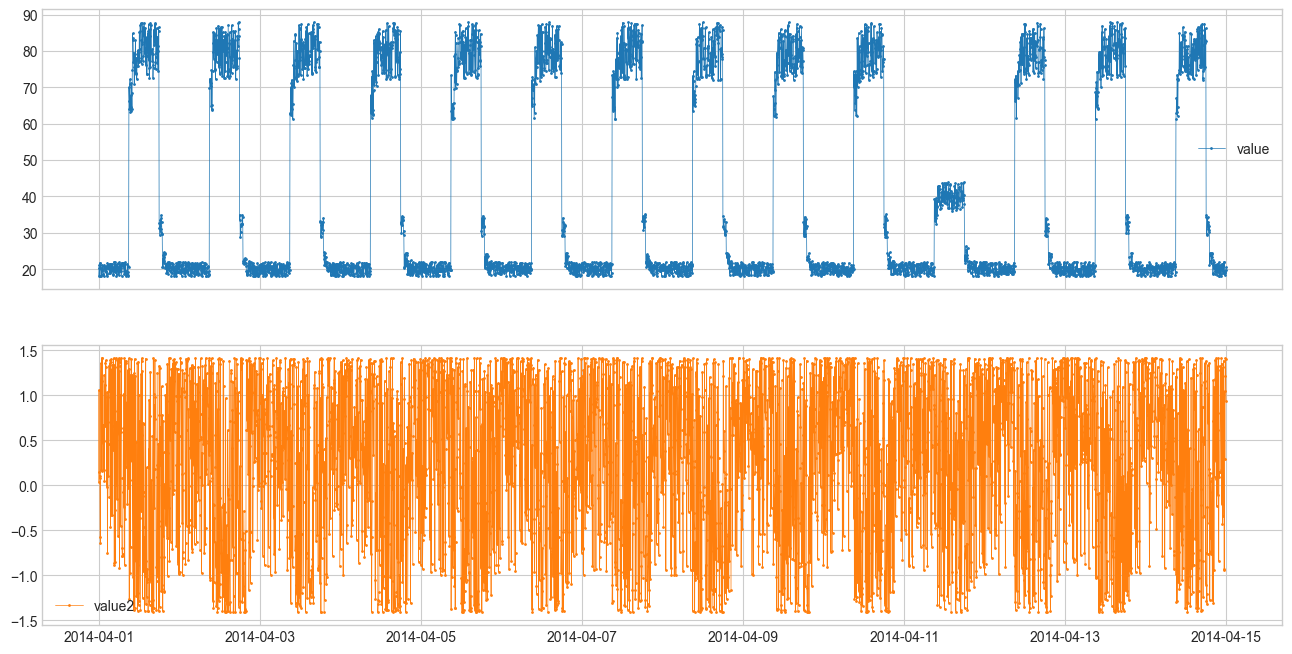
2 列を重ねて描くと、value が毎日 20 から 80 台へ上がって戻る周期を持つのに対し、value2 は 0 付近で細かく振動する帯になります。
| |
異常検知手法の比較 #
多次元データ向けの検出器として、OutlierDetector・RegressionAD・PcaAD の 3 つを同じ DataFrame に当てます。他の検出器は ADTK の Detector 一覧を参照してください。
| |
実行結果の読み方 #
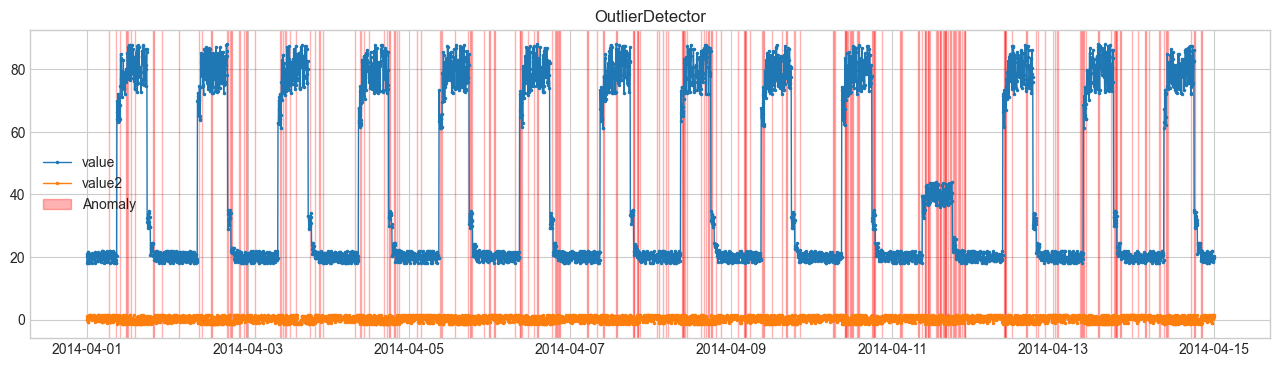
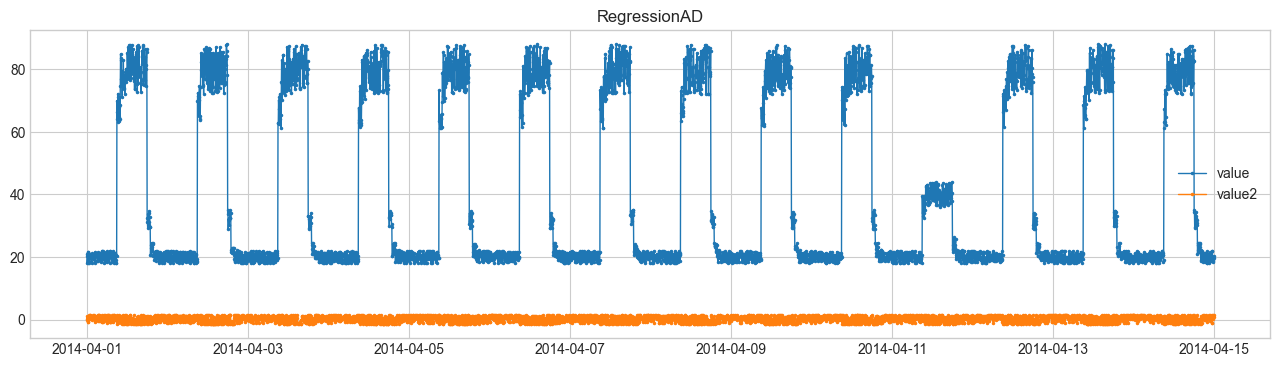
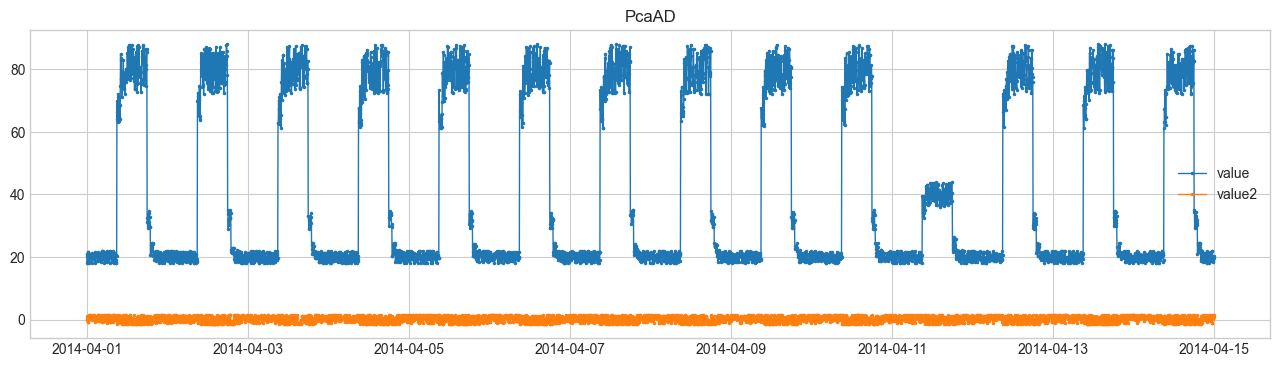
OutlierDetector(LOF)の図では、毎日の立ち上がりと立ち下がりの瞬間、そして 4 月 11 日の低い山のまわりに赤い帯が集中します。value が急に変わる時刻は 2 次元平面で周りに仲間が少ないため、密度比が大きくなるからです。RegressionAD と PcaAD の図には赤い帯がありません。前者は value2 が value の非線形関数なので線形回帰の残差が常に大きく「特に外れた点」を選べず、後者は k=2 で 2 列の情報を全部保持するため再構成誤差が 0 だからです。検出器が何も出さないとき、「異常がない」のではなく「検出器の前提が合っていない」可能性を先に疑う例として覚えておいてください。
まとめ #
多次元の異常検知では「どの列が大きいか」ではなく「列どうしの関係がいつもと違うか」を異常と定義します。ADTK の OutlierDetector(LocalOutlierFactor(contamination=0.05)) は 2 次元平面の密度で孤立点を拾い、このデータでは毎日の切り替わりと 4 月 11 日の低い山を赤くしました。RegressionAD は target の列を他の列から予測できることが前提で、PcaAD は k を列数より小さくしないと再構成誤差が 0 になるため、どちらもこの 2 列ではほぼ 0 件でした。実データでは、列のスケールを StandardScaler で揃え、contamination や c、k を変えて赤い帯の数が業務で確認できる件数に収まるように調整します。
- 異常検知① — 前編
- Isolation Forest — ツリーベースの異常検知