K_DM Book
用語集
対象者 標準
対象者別の入口 →

対象者の設定はこのブラウザの中にだけ保存されます。

言語 JA

【ベンチマーク】極端な不均衡データの分類

中級

02.2.11

【ベンチマーク】極端な不均衡データの分類

最終更新 2026-03-06 読了時間 6 分
まとめ
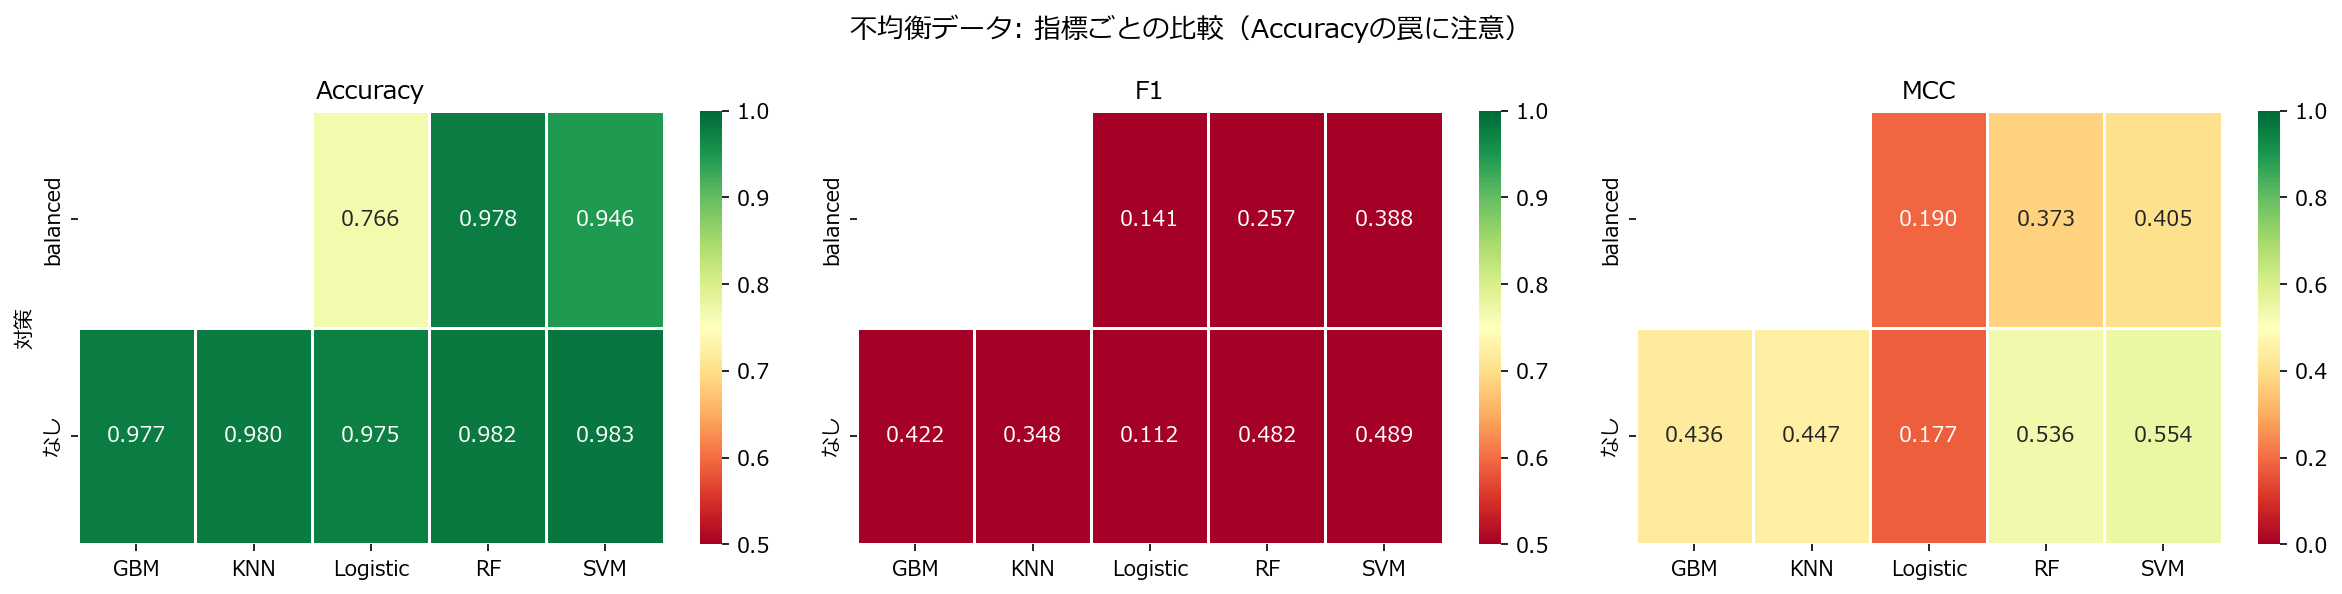
少数クラスが全体の 2 %(5000 件中 100 件)しかない不均衡データで、5 つの分類器 × 対策あり・なしを 5 分割交差検証で比べます。Accuracy はどのモデルも 0.97〜0.99 に張り付いて差が見えませんが、F1 と MCC(Matthews 相関係数)で見ると、少数クラスをほぼ見逃すモデルと検出できるモデルの差がはっきり出ます。class_weight="balanced" を指定するだけで LogisticRegression と RandomForestClassifier の少数クラス検出が大きく改善し、追加パッケージなしで SMOTE と同等以上の効果を得られることが多いと分かります。読み終えると、「Accuracy 98 %」という数字を見た瞬間にクラス比率と混同行列を確認する習慣がつきます。

不正検知・故障予測・希少疾患の診断など、「見つけたいクラスが圧倒的に少ない」問題は実務で頻出する。多数クラスを全部正解すればAccuracy 98%が出るため、Accuracyだけでは判断を誤る。ここでは不均衡データに特化した対策と評価指標の選び方を検証する。


1. データの特徴 #

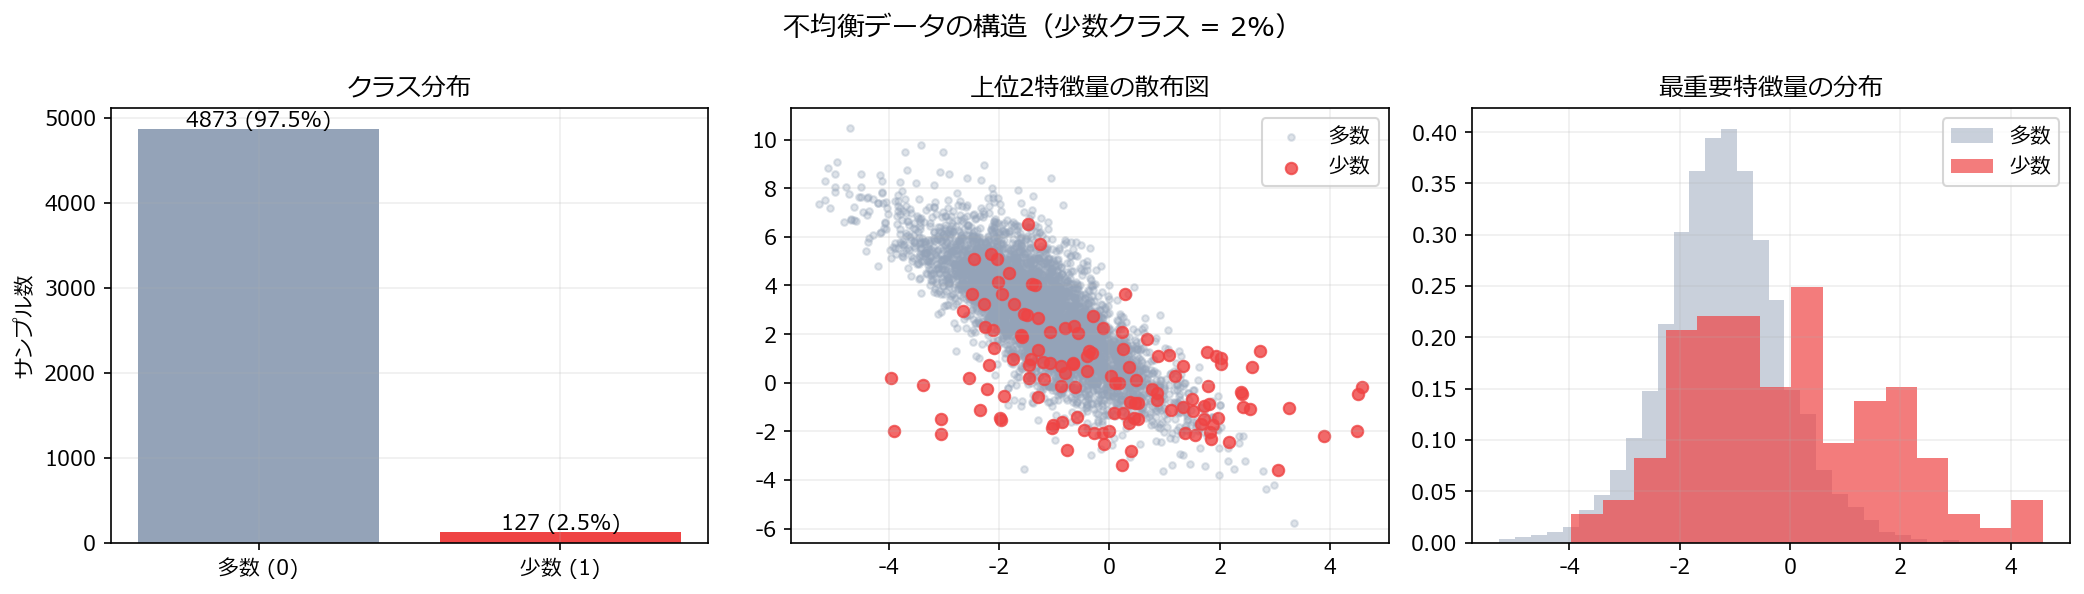
n=5000 の 2 クラス分類で、多数クラスが 98 %、少数クラスが 2 %(100 サンプル)です。特徴量は 10 個で、うち 5 個がクラスを分ける情報を持ちます。「全部を多数クラスと答える」だけで Accuracy が 0.98 になるので、焦点は 100 件の少数クラスをどれだけ正しく検出できるかに置きます。

何が起きているか(ステップで見る) #

コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。

見るポイント:新しい点は少数点どうしを結ぶ線分上に作る。コピーではないので境界が少し滑らかになる。

2. 合成データの生成 #

次のコードは make_classification の weights=[0.98, 0.02] で不均衡データを作り、クラス数の棒グラフ、上位 2 特徴量の散布図、最重要特徴量の分布の 3 枚で「少数クラスがどこに埋もれているか」を見ます。

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification

X, y = make_classification(
    n_samples=5000, n_features=10, n_informative=5,
    n_redundant=2, n_classes=2, weights=[0.98, 0.02],
    flip_y=0.01, random_state=42, class_sep=1.2,
)

fig, axes = plt.subplots(1, 3, figsize=(14, 4))

# クラス分布
counts = np.bincount(y)
axes[0].bar(["多数 (0)", "少数 (1)"], counts, color=["#94a3b8", "#ef4444"])
for i, c in enumerate(counts):
    axes[0].text(i, c + 30, f"{c} ({c/len(y)*100:.1f}%)", ha="center", fontsize=10)
axes[0].set_title("クラス分布")
axes[0].set_ylabel("サンプル数")
axes[0].grid(alpha=0.2)

# 上位2特徴量で散布図
from sklearn.feature_selection import f_classif
f_scores, _ = f_classif(X, y)
top2 = np.argsort(f_scores)[-2:]
axes[1].scatter(X[y == 0, top2[0]], X[y == 0, top2[1]], c="#94a3b8", alpha=0.3, s=10, label="多数")
axes[1].scatter(X[y == 1, top2[0]], X[y == 1, top2[1]], c="#ef4444", alpha=0.8, s=30, label="少数")
axes[1].set_title("上位2特徴量の散布図")
axes[1].legend()
axes[1].grid(alpha=0.2)

# 特徴量0の分布比較
axes[2].hist(X[y == 0, top2[0]], bins=30, alpha=0.5, color="#94a3b8", label="多数", density=True)
axes[2].hist(X[y == 1, top2[0]], bins=15, alpha=0.7, color="#ef4444", label="少数", density=True)
axes[2].set_title("最重要特徴量の分布")
axes[2].legend()
axes[2].grid(alpha=0.2)

fig.suptitle("不均衡データの構造(少数クラス = 2%)", fontsize=13)
fig.tight_layout()
plt.show()

不均衡データの構造

3. 比較するパイプライン #

対策分類器
なし(デフォルト)Logistic, SVM, KNN, RandomForest, GradientBoosting
class_weight=“balanced”Logistic, SVM, RandomForest
ランダムオーバーサンプリングLogistic, SVM, KNN, RandomForest, GradientBoosting
ランダムアンダーサンプリングLogistic, SVM, KNN, RandomForest, GradientBoosting

4. 実験と結果 #

次のコードは、対策なしの 5 モデルと class_weight="balanced" の 3 モデルを同じ 5 分割で交差検証し、Accuracy・F1・MCC の 3 枚のヒートマップに並べます。3 枚を横に並べることで、「Accuracy では差がないのに F1 と MCC では差が出る」ことを一目で比べられます。

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
from sklearn.model_selection import cross_val_score, StratifiedKFold
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline
from sklearn.linear_model import LogisticRegression
from sklearn.svm import SVC
from sklearn.neighbors import KNeighborsClassifier
from sklearn.ensemble import RandomForestClassifier, GradientBoostingClassifier
from sklearn.metrics import make_scorer, f1_score, average_precision_score, matthews_corrcoef
import seaborn as sns

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)

def random_oversample(X_train, y_train, random_state=42):
    """少数クラスを多数クラスと同数になるまで複製する。"""
    rng = np.random.default_rng(random_state)
    minority = X_train[y_train == 1]
    minority_y = y_train[y_train == 1]
    n_to_add = (y_train == 0).sum() - len(minority)
    if n_to_add <= 0:
        return X_train, y_train
    idx = rng.choice(len(minority), size=n_to_add, replace=True)
    X_aug = np.vstack([X_train, minority[idx]])
    y_aug = np.concatenate([y_train, minority_y[idx]])
    return X_aug, y_aug

classifiers_default = {
    "Logistic": LogisticRegression(max_iter=1000, random_state=42),
    "SVM": SVC(random_state=42),
    "KNN": KNeighborsClassifier(),
    "RF": RandomForestClassifier(n_estimators=100, random_state=42),
    "GBM": GradientBoostingClassifier(n_estimators=100, random_state=42),
}
classifiers_balanced = {
    "Logistic": LogisticRegression(class_weight="balanced", max_iter=1000, random_state=42),
    "SVM": SVC(class_weight="balanced", random_state=42),
    "RF": RandomForestClassifier(class_weight="balanced", n_estimators=100, random_state=42),
}

f1_scorer = make_scorer(f1_score, pos_label=1)
mcc_scorer = make_scorer(matthews_corrcoef)

results = []

# デフォルト
for name, clf in classifiers_default.items():
    pipe = Pipeline([("scaler", StandardScaler()), ("clf", clf)])
    f1 = cross_val_score(pipe, X, y, cv=cv, scoring=f1_scorer).mean()
    mcc = cross_val_score(pipe, X, y, cv=cv, scoring=mcc_scorer).mean()
    acc = cross_val_score(pipe, X, y, cv=cv, scoring="accuracy").mean()
    results.append({"対策": "なし", "分類器": name, "F1": f1, "MCC": mcc, "Accuracy": acc})

# class_weight="balanced"
for name, clf in classifiers_balanced.items():
    pipe = Pipeline([("scaler", StandardScaler()), ("clf", clf)])
    f1 = cross_val_score(pipe, X, y, cv=cv, scoring=f1_scorer).mean()
    mcc = cross_val_score(pipe, X, y, cv=cv, scoring=mcc_scorer).mean()
    acc = cross_val_score(pipe, X, y, cv=cv, scoring="accuracy").mean()
    results.append({"対策": "balanced", "分類器": name, "F1": f1, "MCC": mcc, "Accuracy": acc})

df = pd.DataFrame(results)

# ヒートマップ: F1 vs MCC vs Accuracy
fig, axes = plt.subplots(1, 3, figsize=(16, 4))
for i, metric in enumerate(["Accuracy", "F1", "MCC"]):
    pivot = df.pivot_table(index="対策", columns="分類器", values=metric)
    cmap = "RdYlGn" if metric != "Accuracy" else "RdYlGn"
    sns.heatmap(pivot, annot=True, fmt=".3f", cmap=cmap,
                linewidths=0.5, ax=axes[i],
                vmin=0 if metric == "MCC" else 0.5,
                vmax=1.0)
    axes[i].set_title(f"{metric}")
    axes[i].set_xlabel("")
    if i > 0:
        axes[i].set_ylabel("")

fig.suptitle("不均衡データ: 指標ごとの比較(Accuracyの罠に注意)", fontsize=13)
fig.tight_layout()
plt.show()

指標別ヒートマップ

読み方のポイント #

Accuracy は全モデルで 0.97〜0.99 に張り付いており、モデル間の差がほとんど見えません。F1 や MCC で見ると、class_weight="balanced" を指定しただけで LogisticRegression と RandomForestClassifier の少数クラス検出が大幅に改善します。KNeighborsClassifier は不均衡に弱く、近傍 5 点のほとんどが多数クラスで占められるため、少数クラスの票が多数決で埋もれます。


5. 誤差パターン分析 #

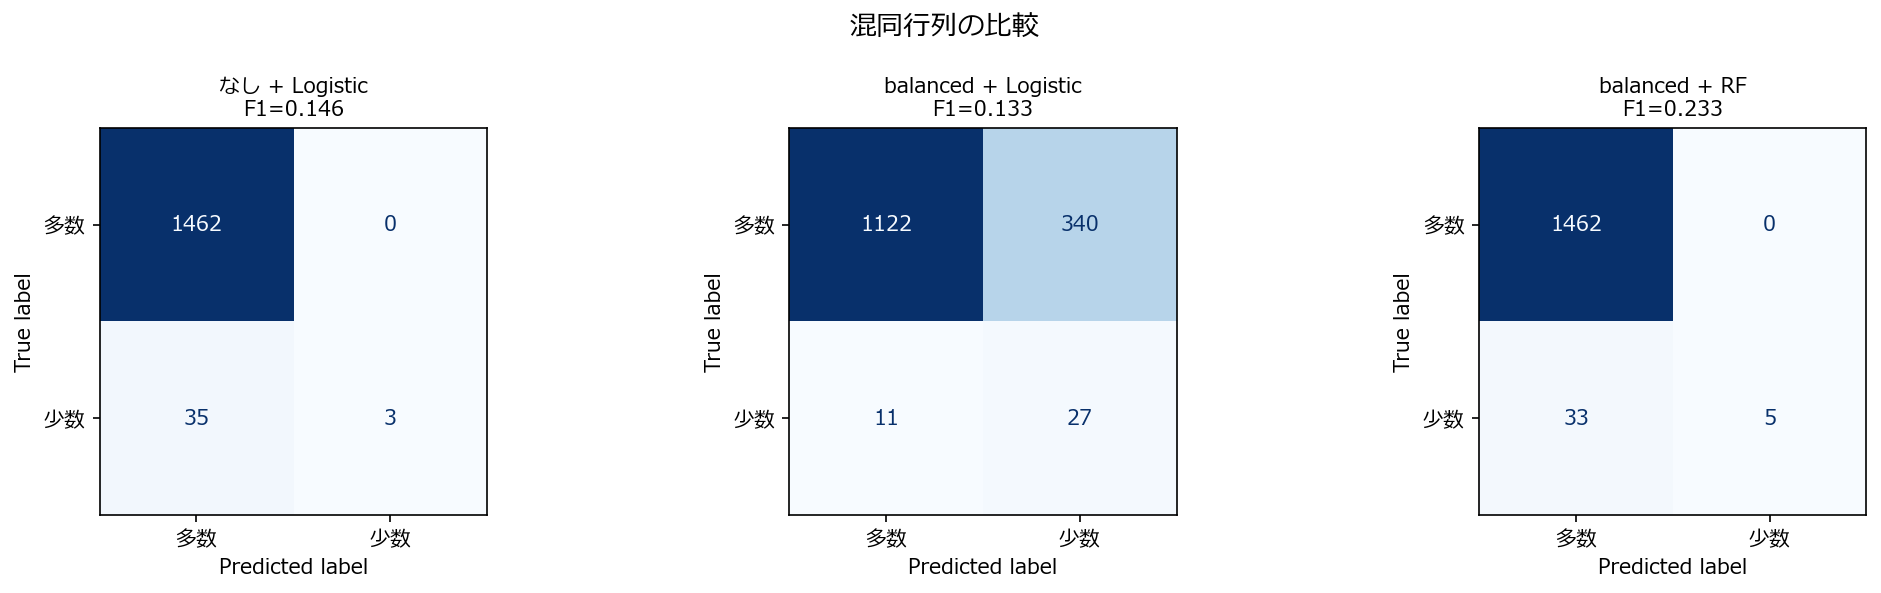
対策なしの Logistic、balanced の Logistic、balanced の RandomForest を同じ 70/30 分割で学習し、混同行列で「少数クラス 30 件のうち何件を見つけられたか」を比べます。

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
from sklearn.model_selection import train_test_split
from sklearn.metrics import confusion_matrix, ConfusionMatrixDisplay, precision_recall_curve

X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, stratify=y, random_state=42)

configs = [
    ("なし + Logistic", LogisticRegression(max_iter=1000, random_state=42)),
    ("balanced + Logistic", LogisticRegression(class_weight="balanced", max_iter=1000, random_state=42)),
    ("balanced + RF", RandomForestClassifier(class_weight="balanced", n_estimators=100, random_state=42)),
]

fig, axes = plt.subplots(1, 3, figsize=(14, 4))
scaler = StandardScaler()
X_tr_s = scaler.fit_transform(X_tr)
X_te_s = scaler.transform(X_te)

for i, (name, clf) in enumerate(configs):
    clf.fit(X_tr_s, y_tr)
    y_pred = clf.predict(X_te_s)
    cm = confusion_matrix(y_te, y_pred)
    ConfusionMatrixDisplay(cm, display_labels=["多数", "少数"]).plot(
        ax=axes[i], cmap="Blues", colorbar=False)
    f1 = f1_score(y_te, y_pred)
    axes[i].set_title(f"{name}\nF1={f1:.3f}", fontsize=10)

fig.suptitle("混同行列の比較", fontsize=13)
fig.tight_layout()
plt.show()

混同行列の比較

デフォルトの Logistic は少数クラスをほぼ見逃す(False Negative 多)。class_weight="balanced" を指定すると少数クラスの再現率が上がり、多少の False Positive と引き換えに F1 が大幅に改善する。


6. よくある失敗パターン #

最初の失敗は、Accuracy だけで評価することです。多数クラスを全部正解するだけで 98 % に到達するため、モデルの実力が見えません。F1、PR-AUC、MCC を必ず確認してください。二つ目は、テストデータもリサンプリングすることです。オーバーサンプリングは学習データにのみ適用し、テストデータの分布を 98 対 2 のまま残さないと、本番で出会う比率と違う条件で評価することになり結果が歪みます。

まとめ #

少数クラスが 2 % のデータでは、Accuracy は全モデルで 0.98 前後に張り付き、F1 と MCC だけがモデルの差を映しました。class_weight="balanced" は少数クラス 1 件の損失を約 49 倍に重くするだけの指定ですが、LogisticRegression と RandomForestClassifier の少数クラス検出を大きく改善し、追加パッケージなしで SMOTE と同等以上の効果を出すことが多いです。KNeighborsClassifier は近傍の多数決が多数クラスに流されるため不均衡に弱く、class_weight も持ちません。評価では StratifiedKFold と stratify=y で少数クラスを均等に配り、リサンプリングは学習データだけに適用してください。