02.2.1 高校生向け
ロジスティック回帰(高校生向け)
こんな場面を想像してみよう #
クラスの友だち 30 人について、1 日の 勉強時間 と 睡眠時間、そして先週の小テストに 合格したか(1)しなかったか(0) を表にしました。横軸に勉強時間、縦軸に睡眠時間をとって 30 個の点を打つと、合格した人は右上、しなかった人は左下に多く集まるでしょう。
ここで「勉強 3 時間、睡眠 7 時間の人は合格しそう?」と聞かれたら、「はい/いいえ」だけでなく「合格する確率は 60 % くらい」と答えたくなりませんか。この「確率で答える分類」がロジスティック回帰です。
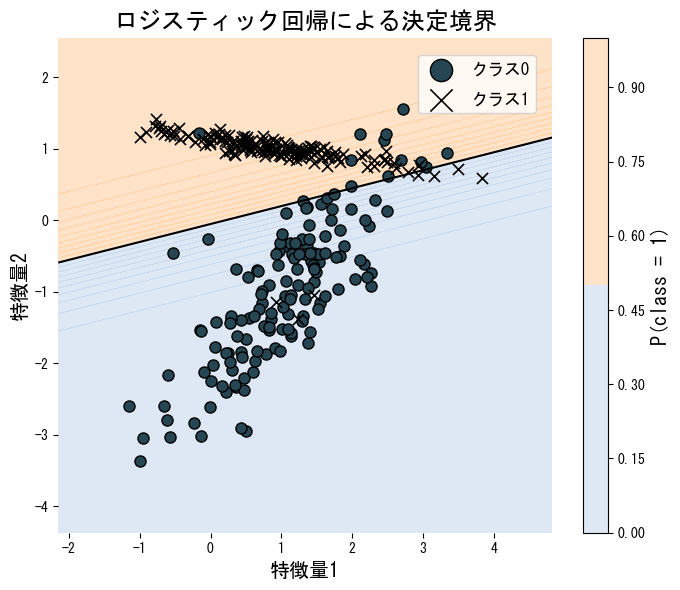
上の図では、黒い直線が「確率ちょうど 0.5」の線です。線の上側ほどクラス 1 の確率が高く(オレンジ)、下側ほど低く(青)なります。色の濃さが確率、黒い線が境界です。
仕組み:点数をつけて、確率に変えて、0.5 で切る #
まず一次式で点数をつけます。勉強時間を \(x_1\)、睡眠時間を \(x_2\) として、\(z = a x_1 + b x_2 + c\) を計算します。線形回帰と同じ形です。次に点数を確率に変えます。\(z\) は −10 にも +10 にもなりえますが、確率は 0〜1 でなければいけません。そこで S 字カーブ \(p = \dfrac{1}{1 + e^{-z}}\) に通します(\(e\) は 2.718… という定数)。覚えておくのは「\(z = 0\) なら \(p = 0.5\)、\(z\) が大きいほど 1 に近づき、小さいほど 0 に近づく」ということだけです。
そのうえで 0.5 を境に分類します。\(p \ge 0.5\) なら合格と予測。\(p = 0.5\) は \(z = 0\)、つまり \(a x_1 + b x_2 + c = 0\) のときなので、境界は図の上で直線になります。最後に係数を学習します。合格した人の \(p\) はなるべく 1 に、不合格の人の \(p\) はなるべく 0 に近づくように、\(a, b, c\) を少しずつ動かします。\(a, b\) を変えると図の直線が回転し、\(c\) を変えると平行移動します。外れている点を減らす向きに直線を動かし、\(a, b, c\) が動かなくなったら完成です。
動かして見てみよう #
下の図で「再生」を押すと、説明した手順が 1 つずつ進みます。手順ごとの説明は図の下に出ます。
電卓感覚で計算してみる #
係数を \(a = 1.2,\ b = 0.8,\ c = -9\) と仮に決めて、何人かの確率を計算してみます。
| |
勉強 2 時間・睡眠 6 時間なら \(z = -1.8\) で確率 0.14、勉強 5 時間・睡眠 7 時間なら \(z = 2.6\) で確率 0.93。境界線 \(1.2 x_1 + 0.8 x_2 - 9 = 0\) からの「遠さ」が、そのまま確信の強さになっていることが分かります。
気をつけたいこと #
最初の課題は「境界が直線だけ」だということです。三日月形や輪になったデータは直線 1 本では分けられません。そういうときは k近傍法や決定木を使うか、\(x_1^2\) のような項を特徴量に足します。二つ目は、0.5 という境目は目的で変えてよいこと。「見落としを減らしたい」なら 0.3 で合格と予測する、というように、しきい値は後から動かせます。三つ目は「係数の大きさは単位しだい」だということです。勉強時間を「分」で入れると \(a\) は 60 分の 1 になるので、係数を比べる前に特徴量の単位(スケール)をそろえましょう。四つ目は合わせすぎへの注意で、係数を極端に大きくすると、学習データにぴったり合っても新しい人では外れやすくなります(情報IIの過学習)。係数を大きくしすぎない仕組み(正則化)が scikit-learn の標準設定では入っています。
やってみよう #
まず、上のコードの \(a, b, c\) を変えて、境界線 \(a x_1 + b x_2 + c = 0\) を方眼紙に引いてみよう。\(c\) を変えると線はどう動くか、\(a\) と \(b\) の比を変えるとどうなるかを見比べよう。次に、「はい/いいえ」ではなく「確率で答えてほしい」場面を身の回りから 2 つ探してみよう(例:降水確率、試合に勝つ見込み)。最後に、直線 1 本ではどうしても分けられない点の配置を 1 つ描いてみよう(ヒント:赤を中心に、青をそのまわりの輪に)。
つぎに読む #
係数を求める計算(最尤推定・勾配法)や正則化の数式、scikit-learn での実装は 標準版のロジスティック回帰 で扱っています。点数をつける前半部分は 高校生向けの線形回帰 と同じ考え方です。曲がった境界を作れる方法として 高校生向けの k近傍法 も読むと、直線との違いが 1 枚の図で分かります。