02.2.5
サポートベクターマシン (SVM)
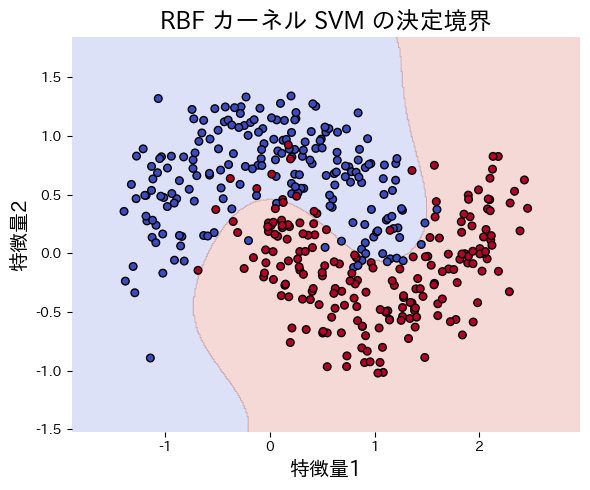
SVC(kernel="rbf", C=5.0, gamma=0.5) が三日月形のデータを分ける様子を下で確かめます。SVM の境界 \(\mathbf{w}^\top \mathbf{x} + b = 0\) はロジスティック回帰と同じ直線の式なので、先に ロジスティック回帰 で係数の読み方を押さえておくと、違いが「直線をどの基準で選ぶか」にあると分かります。
直感 #
2 色の点を分ける直線は無数に引けます。パーセプトロンは「間違いが 0 になった最初の線」で止まり、ロジスティック回帰は「全点の確率が最もよく合う線」を選びます。SVM は、どちらの色の点からも最も遠い線、つまり道幅(マージン)が最大になるように線を引きます。道幅を決めているのは道の縁に触れている数点だけで、これをサポートベクターと呼びます。縁から離れた点は、100 個消しても境界に影響しません。この性質のおかげで、多少のノイズ点が増えても境界が揺れにくく、汎化性能が高くなります。
何が起きているか(ステップで見る) #
コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。
見るポイント:境界を決めるのはマージンに乗った数点だけ。他の点が動いても境界は変わらない。
式で書くと何を最小にしているか #
マージンの幅は \(2 / \lVert \mathbf{w} \rVert\) なので、「マージンを最大にする」は「\(\lVert \mathbf{w} \rVert\) を最小にする」と同じです。線形に分離可能な場合は次の最適化問題を解き、\(\mathbf{w}\) と \(b\) を求めます。
$$ \min_{\mathbf{w}, b} \ \frac{1}{2} \lVert \mathbf{w} \rVert_2^2 \quad \text{s.t.} \quad y_i(\mathbf{w}^\top \mathbf{x}_i + b) \ge 1. $$制約 \(y_i(\mathbf{w}^\top \mathbf{x}_i + b) \ge 1\) は「全部の点がマージンの外側にある」という条件です。実際のデータでは完全に分離できないことが多いため、はみ出しを許す量 \(\xi_i \ge 0\)(スラック変数)を導入したソフトマージン SVM を用います。
$$ \min_{\mathbf{w}, b, \boldsymbol{\xi}} \ \frac{1}{2} \lVert \mathbf{w} \rVert_2^2 + C \sum_{i=1}^{n} \xi_i \quad \text{s.t.} \quad y_i(\mathbf{w}^\top \mathbf{x}_i + b) \ge 1 - \xi_i. $$\(C\) が大きいとはみ出し 1 つ 1 つに重い罰が付くので誤分類を嫌ってマージンが狭くなり、\(C\) が小さいとはみ出しを許してマージンを広くとります。内積 \(\mathbf{x}_i^\top \mathbf{x}_j\) をカーネル \(K(\mathbf{x}_i, \mathbf{x}_j)\) に置き換えれば、非線形な決定境界も表現できます。
アルゴリズムの詳細 #
双対問題 #
ソフトマージンSVMの主問題にラグランジュ乗数\(\alpha_i \ge 0\)を導入すると、以下の双対問題が得られます。
$$ \max_{\boldsymbol{\alpha}} \sum_{i=1}^{n} \alpha_i - \frac{1}{2} \sum_{i=1}^{n} \sum_{j=1}^{n} \alpha_i \alpha_j y_i y_j K(\mathbf{x}_i, \mathbf{x}_j) $$$$ \text{s.t.} \quad 0 \le \alpha_i \le C, \quad \sum_{i=1}^{n} \alpha_i y_i = 0 $$この双対問題は \(\boldsymbol{\alpha}\) についての凸二次計画問題であり、大域的最適解が保証されます。データは \(K(\mathbf{x}_i, \mathbf{x}_j)\) の形でしか現れないので、内積をカーネル関数に置き換えることで、入力空間での明示的な写像なしに高次元空間での分離が可能になります。
KKT条件とサポートベクター #
最適解はKKT(Karush-Kuhn-Tucker)条件を満たします。
$$ \alpha_i \bigl[ y_i(\mathbf{w}^\top \mathbf{x}_i + b) - 1 + \xi_i \bigr] = 0 $$$$ (C - \alpha_i)\,\xi_i = 0 $$これにより、各サンプルは\(\alpha_i\)の値に応じて3つのカテゴリーに分類されます。
| \(\alpha_i\) の値 | サンプルの役割 | 位置 |
|---|---|---|
| \(\alpha_i = 0\) | 非サポートベクター | マージン外側(正しく分類) |
| \(0 < \alpha_i < C\) | マージン上のサポートベクター | \(y_i(\mathbf{w}^\top \mathbf{x}_i + b) = 1\) |
| \(\alpha_i = C\) | マージン内側のサポートベクター | 誤分類またはマージン違反 |
バイアス項\(b\)は、\(0 < \alpha_i < C\)を満たすサポートベクターから計算されます。学習後は clf.support_ にサポートベクターの番号、clf.dual_coef_ に \(\alpha_i y_i\) が入っています。
決定関数 #
学習後の予測は、サポートベクターのみを使って以下で計算されます。
$$ f(\mathbf{x}) = \operatorname{sign}\left(\sum_{i \in \text{SV}} \alpha_i\, y_i\, K(\mathbf{x}_i, \mathbf{x}) + b\right) $$サポートベクター以外のサンプル(\(\alpha_i = 0\))は決定関数に寄与しないため、訓練データの大部分を捨てても予測が変わりません。これがSVMのスパース性で、400 点で学習しても予測時に使うのは数十点だけ、ということが起きます。
カーネル関数 #
カーネル関数は\(K(\mathbf{x}_i, \mathbf{x}_j) = \langle \phi(\mathbf{x}_i), \phi(\mathbf{x}_j) \rangle\)を満たす関数で、高次元空間への写像\(\phi\)を明示的に計算せずに内積を求められます。Mercerの定理により、正定値カーネルであれば対応する特徴空間が存在することが保証されます。
| カーネル | 数式 | 特徴 |
|---|---|---|
| 線形 | \(K(\mathbf{x}_i, \mathbf{x}_j) = \mathbf{x}_i^\top \mathbf{x}_j\) | 計算が高速、線形分離可能なデータ向け |
| 多項式 | \(K(\mathbf{x}_i, \mathbf{x}_j) = (\gamma, \mathbf{x}_i^\top \mathbf{x}_j + r)^d\) | 交互作用を考慮、\(d\)で非線形度を制御 |
| RBF | \(K(\mathbf{x}_i, \mathbf{x}_j) = \exp(-\gamma \lVert \mathbf{x}_i - \mathbf{x}_j \rVert^2)\) | 無限次元空間への写像、汎用的 |
| シグモイド | \(K(\mathbf{x}_i, \mathbf{x}_j) = \tanh(\gamma, \mathbf{x}_i^\top \mathbf{x}_j + r)\) | ニューラルネットワークとの類似性 |
RBF カーネルの \(\gamma\) は「1 つのサポートベクターの影響が届く範囲」の逆数で、gamma=0.5 なら距離 1 離れた点への影響が \(e^{-0.5} \approx 0.61\) に、gamma=10 なら \(e^{-10} \approx 0.00005\) に減ります。
SMOアルゴリズム #
双対問題の求解には**SMO(Sequential Minimal Optimization)**が広く使われます。SMOは2つの\(\alpha_i\)を同時に選んで解析的に更新するため、大規模な二次計画ソルバーを必要としません。まず KKT 条件に違反する \(\alpha_i\) を 1 つ選び、次に対応するもう 1 つの \(\alpha_j\) をヒューリスティックで選びます。その 2 つを制約 \(\sum \alpha_k y_k = 0\) のもとで解析的に更新し、すべての \(\alpha\) が KKT 条件を満たすまでこれを繰り返します。SVC の libsvm 実装はこの SMO で、max_iter=-1(既定)なら収束するまで回します。
参考リンク
Boser, B. E., Guyon, I. M., & Vapnik, V. N. (1992). A Training Algorithm for Optimal Margin Classifiers. Proceedings of the 5th Annual ACM Workshop on Computational Learning Theory (COLT), 144–152.
Platt, J. C. (1998). Sequential Minimal Optimization: A Fast Algorithm for Training Support Vector Machines. Microsoft Research Technical Report MSR-TR-98-14.
SVMは特徴量のスケールに非常に敏感です。正規化なしで学習すると、大きいスケールの特徴量がマージンを支配し、性能が大きく低下します。必ず StandardScaler を適用してください。
Pythonで線形カーネルと RBF カーネルを比べる #
次のコードは make_moons で三日月形に絡み合った 2 クラス 400 点を作り、線形カーネルの SVC と RBF カーネルの SVC を両方学習して、RBF の決定境界を背景色で描きます。2 つの訓練精度を print で比べると、直線では分けられないデータで RBF がどれだけ効くかが数字で分かります。
| |
実行結果の読み方 #
背景の 2 色の境目が RBF カーネル SVM の決定境界です。2 つの三日月の間を縫うように曲がっています。print される 2 つの精度のうち、線形カーネルは直線 1 本の限界で 0.9 前後、RBF は三日月に沿えるのでそれより高くなります。noise=0.25 のせいで半円が重なる中央には、どちらのカーネルでも分けられない点が残ります。
カーネル選択に迷った場合は、まずRBF(kernel="rbf")から試してください。RBFは非線形な境界を汎用的に表現でき、多くのケースでベースラインとして機能します。C と gamma は GridSearchCV で探索するのが効率的です。
罰則 C と決定境界 #
C を変えるとサポートベクタマシンのマージンと境界がどう変化するか確認できます。
使いどころと落とし穴 #
SVM が向くのは、サンプル数が数千〜数万で特徴量が多く、境界が曲がっているデータです。テキストのように特徴量が疎で数万次元ある場合は、線形カーネルの LinearSVC が RBF より速く、精度も出やすくなります。苦手なのは 10 万サンプルを超える大規模データです。カーネル行列が \(n \times n\) になり、学習時間が \(n^2\)〜\(n^3\) で伸びます。間違えやすい設定は StandardScaler の省略と、C・gamma を片方だけ調整することで、2 つは対数スケール(\(10^{-2}\)〜\(10^{3}\))で同時に GridSearchCV にかけます。確率が必要なら probability=True で後から推定できますが、内部で 5 分割交差検証が走るぶん学習が遅くなるので、確率が主目的なら ロジスティック回帰 のほうが素直です。
まとめ #
SVM は、両クラスの最も近い点までの距離(マージン)が最大になる境界を選び、マージンに接するサポートベクターだけで決定関数 \(f(\mathbf{x}) = \operatorname{sign}(\sum \alpha_i y_i K(\mathbf{x}_i, \mathbf{x}) + b)\) を作ります。罰則係数 \(C\) は「マージンの広さ」と「はみ出しの許容」のトレードオフで、小さいほど広く滑らかな境界になります。カーネルトリックは内積を \(K(\mathbf{x}_i, \mathbf{x}_j)\) に置き換えるだけで、make_moons のような曲がった境界を特徴量を増やさずに表現できました。最後に、StandardScaler と GridSearchCV による \(C\)・\(\gamma\) の対数探索を忘れないでください。
参考文献 #
- Vapnik, V. (1998). Statistical Learning Theory. Wiley.
- Smola, A. J., & Schölkopf, B. (2004). A Tutorial on Support Vector Regression. Statistics and Computing, 14(3), 199 E22.
- ロジスティック回帰 — 確率ベースの線形分類
- k近傍法 — 距離ベースの分類
- サポートベクター回帰 — SVM の回帰版
- One-Class SVM — SVMを応用した教師なし異常検知