まとめk-means++ は、k-means の最初のセントロイドを「既に選ばれたセントロイドから遠い点ほど選ばれやすい」確率で置く初期化の方法です。新しいセントロイドは、いちばん近い既存セントロイドまでの距離 \(D(x)\) の 2 乗に比例する確率で選ばれるので、同じ塊の中に 2 つ落ちる偏りが起きにくくなります。初期配置が良ければ k-means は悪い局所解に落ちにくく、このページでは中心が 3 つ横に並んだデータで init="random" と比べ、50 回試行した WCSS のばらつきが小さくなることを確かめます。scikit-learn の KMeans では init="k-means++" が既定なので、何も指定しなくてもこの初期化が使われています。
直感
#
k-means の結果は初期セントロイドの位置に大きく左右されます。3 つの塊があるデータで、たまたま 2 つのセントロイドが同じ塊の中に置かれると、その塊が 2 つに割れ、残りの 2 つの塊が 1 つのセントロイドに押し込まれたまま収束します。k-means++ はこの事故を防ぐため、1 点目だけをランダムに選び、2 点目以降は「既に選んだセントロイドから遠い点ほど選ばれやすい」確率で選びます。遠い点が優先されるので、3 つの塊にはほぼ確実に 1 つずつセントロイドが置かれ、そこから始める k-means は良い答えに着きます。
1 点目をランダムに選ぶ→
各点から最近のセントロイドまでの距離 D(x) を計算→
D(x)² に比例する確率で次のセントロイドを選ぶ→
k 個そろった?→
この初期値から k-means を実行→
安定したクラスター
まだ足りない: D(x) の計算に戻る
何が起きているか(ステップで見る)
#
コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。
見るポイント:割り当てでは点の色だけ、更新では重心だけが動く。WCSS は決して増えない。
Pythonで確かめる
#
Arthur, David, and Sergei Vassilvitskii. “k-means++: The advantages of careful seeding.” SODA 2007.
ライブラリと実験データ
#
使うのは make_blobs と KMeans だけです。k-means++ は KMeans の init 引数で切り替えるので、専用のクラスは要りません。
1
2
3
4
| import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_blobs
from sklearn.cluster import KMeans
|
クラスター間の距離が近い、やや難しいデータを生成します。中心が \((-3, 0), (0, 0), (3, 0)\) で、cluster_std=1.2 なので隣の塊とすそが重なります。
1
2
3
4
5
6
| X, y_true = make_blobs(
n_samples=500,
centers=[[-3, 0], [0, 0], [3, 0]],
cluster_std=1.2,
random_state=42,
)
|
ランダム初期化 vs k-means++
#
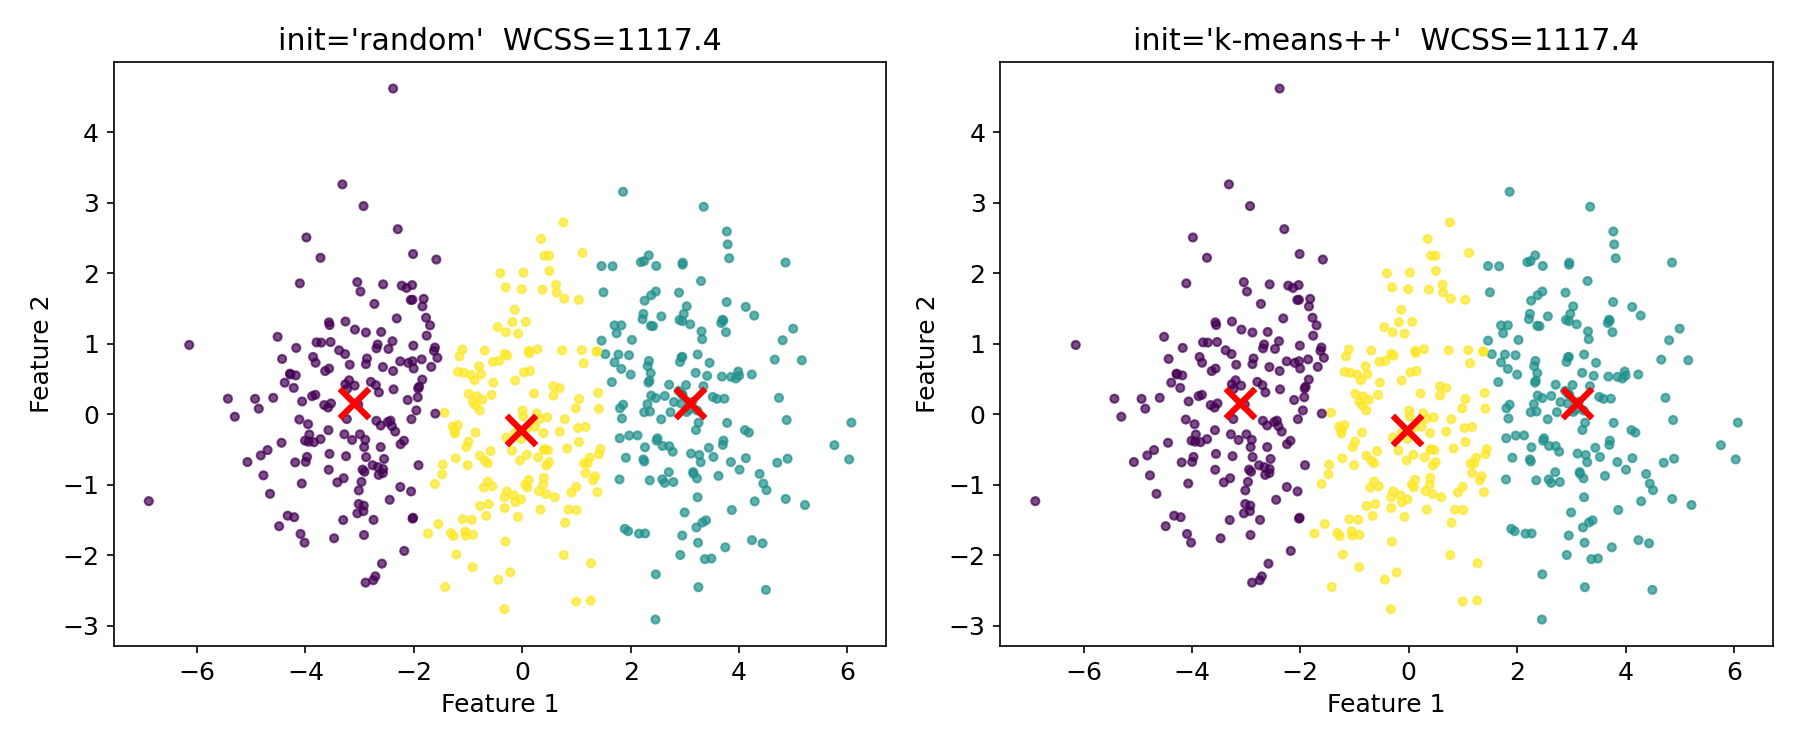
同じデータに対して、init="random" と init="k-means++" を n_init=1(初期化を 1 回だけ)で走らせ、結果とタイトルの WCSS を左右に並べます。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
| fig, axes = plt.subplots(1, 2, figsize=(12, 5))
for ax, init_method in zip(axes, ["random", "k-means++"]):
km = KMeans(n_clusters=3, init=init_method, n_init=1, random_state=0)
labels = km.fit_predict(X)
ax.scatter(X[:, 0], X[:, 1], c=labels, cmap="viridis", s=15, alpha=0.7)
ax.scatter(
km.cluster_centers_[:, 0], km.cluster_centers_[:, 1],
c="red", marker="x", s=200, linewidths=3,
)
ax.set_title(f"init='{init_method}' WCSS={km.inertia_:.1f}")
plt.tight_layout()
plt.show()
|
実行結果の読み方
#
左の init='random' では WCSS が右より大きく、中央の塊が左右の色に割られているか、右端の塊の × がずれているはずです。右の init='k-means++' では 3 つの塊に × が 1 つずつ乗り、WCSS が小さくなります。ただし 1 回の比較は乱数の運も含むので、次に 50 回繰り返して分布で確かめます。
複数試行での安定性の比較
#
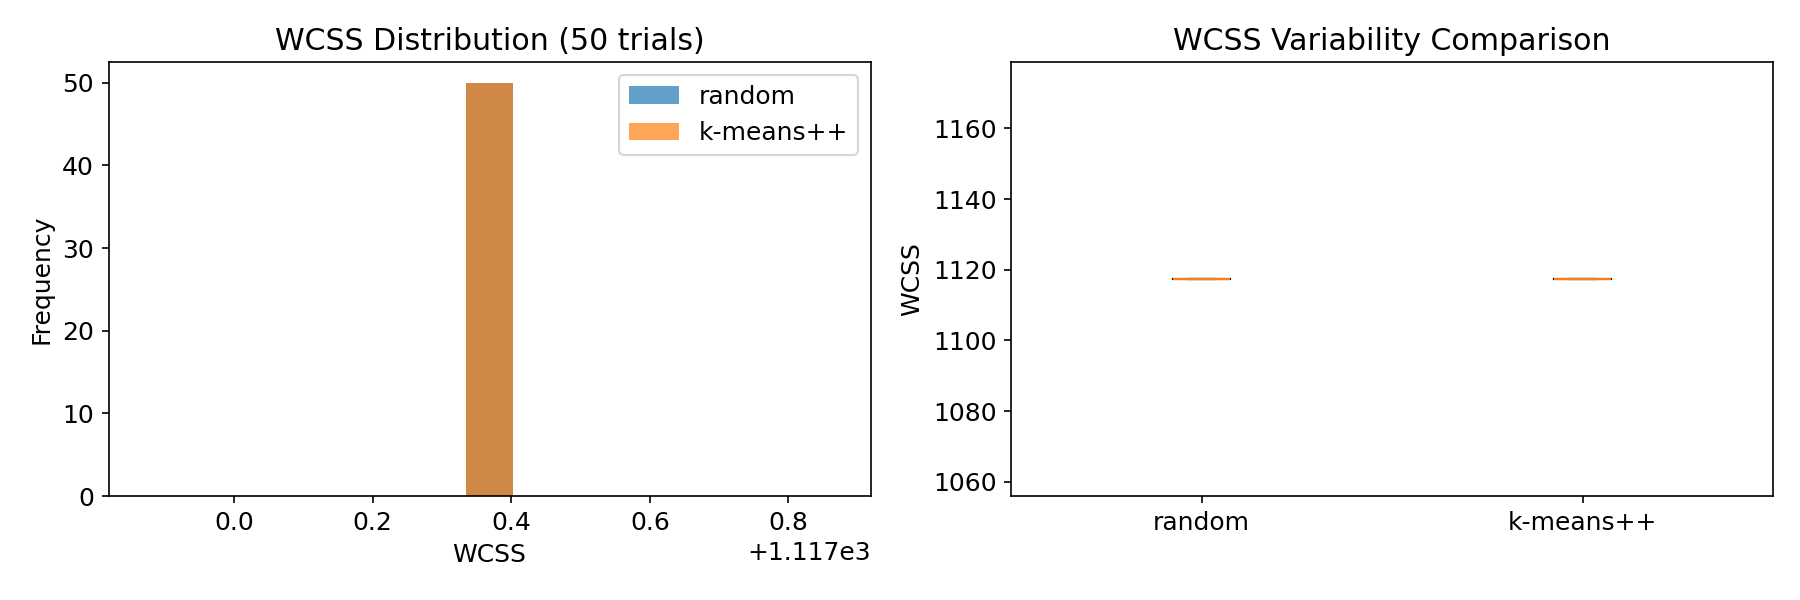
random_state を 0 から 49 まで変えて n_init=1 の学習を 50 回ずつ行い、WCSS のヒストグラムと箱ひげ図で、初期化ごとのばらつきを比べます。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
| random_scores = []
pp_scores = []
for seed in range(50):
km_r = KMeans(n_clusters=3, init="random", n_init=1, random_state=seed)
km_r.fit(X)
random_scores.append(km_r.inertia_)
km_pp = KMeans(n_clusters=3, init="k-means++", n_init=1, random_state=seed)
km_pp.fit(X)
pp_scores.append(km_pp.inertia_)
fig, axes = plt.subplots(1, 2, figsize=(12, 4))
axes[0].hist(random_scores, bins=15, alpha=0.7, label="random")
axes[0].hist(pp_scores, bins=15, alpha=0.7, label="k-means++")
axes[0].set_xlabel("WCSS")
axes[0].set_ylabel("頻度")
axes[0].set_title("WCSSの分布(50回試行)")
axes[0].legend()
axes[1].boxplot(
[random_scores, pp_scores],
labels=["random", "k-means++"],
)
axes[1].set_ylabel("WCSS")
axes[1].set_title("WCSSのばらつき比較")
plt.tight_layout()
plt.show()
print(f"random 平均WCSS: {np.mean(random_scores):.1f} 標準偏差: {np.std(random_scores):.1f}")
print(f"k-means++ 平均WCSS: {np.mean(pp_scores):.1f} 標準偏差: {np.std(pp_scores):.1f}")
|
k-means++の初期化アルゴリズム
#
図で確かめた k-means++ の挙動を手順として書くと、次の 3 段階になります。まず、データからランダムに 1 つ目のセントロイドを選びます。次に、各データ点について、もっとも近い既存セントロイドまでの距離 \(D(x)\) を計算し、\(D(x)^2\) に比例する確率で次のセントロイドを選びます。最後に、この計算と選択を \(k\) 個のセントロイドがそろうまで繰り返します。距離の 2 乗に比例させるので、既存のセントロイドから遠い塊にいる点は近い点の何倍も選ばれやすく、セントロイドがデータ全体にバランスよく配置されます。確率的に選ぶ(最遠点を決定的に選ばない)のは、外れ値 1 点が必ず選ばれる事故を避けるためです。
Mini-Batch k-means
#
大規模データでは、各反復でデータの一部(ミニバッチ)だけを使ってセントロイドを更新する MiniBatchKMeans が実用的です。次のコードは batch_size=100 で学習し、通常の k-means と WCSS を比べます。
1
2
3
4
5
6
7
| from sklearn.cluster import MiniBatchKMeans
mbkm = MiniBatchKMeans(n_clusters=3, batch_size=100, random_state=42)
labels_mb = mbkm.fit_predict(X)
print(f"Mini-Batch k-means WCSS: {mbkm.inertia_:.1f}")
print(f"通常 k-means WCSS: {KMeans(n_clusters=3, random_state=42).fit(X).inertia_:.1f}")
|
k-means++は初期化を改善しますが、k-meansの根本的な制約(球状クラスター仮定、\(k\) の事前指定)は解消しません。クラスターの形状が非凸な場合や、クラスター数が不明な場合はDBSCANやHDBSCANも検討してください。
scikit-learnのKMeansはinit="k-means++"がデフォルトなので、特に指定しなくても恩恵を受けられます。さらに安定性を高めたい場合はn_init=10以上を設定してください。大規模データではMiniBatchKMeansで計算コストを抑えられます。
まとめ
#
k-means++ は、最初の 1 点をランダムに、2 点目以降を距離 \(D(x)\) の 2 乗に比例する確率で選ぶことで、同じ塊に 2 つのセントロイドが落ちる偏りを防ぎます。中心が 3 つ並んだデータで 50 回試行すると、init="random" より WCSS の平均も標準偏差も小さくなり、局所解に落ちる回数が減ることが確認できました。scikit-learn の KMeans では既定で有効なので、設定しなくても恩恵を受けており、さらに n_init=10 以上にすれば残りの運も抑えられます。数百万点の大規模データでは MiniBatchKMeans と組み合わせ、WCSS のわずかな増加と引き換えに計算コストを削減します。
- k-means — k-means の基本と、エルボー法・シルエット係数によるクラスター数の選択
- X-means — クラスター数を自動推定する発展手法