02.5.3
X-means
c_min から出発し、分割が BIC を改善するクラスタだけを割り、上限 c_max に達するか改善が止まるまで繰り返します。このページでは make_blobs で作った 10 個の塊に対し、KMeans(n_clusters=5) が塊をまたいで割ってしまう結果と、pyclustering の xmeans が 10 個を言い当てる結果を並べて比べます。分割の判定基準を BIC から MNDL に変えたとき、tolerance を変えたときの図の変化も確認します。- k-means — X-means は k-means を拡張してクラスター数を自動推定します
直感 #
X-means は「まず粗く分けて、分ける価値があるクラスタだけ追加で割る」戦略です。k-means で c_min=3 個に分けたあと、各クラスタの中でもう一度 k=2 の k-means を走らせ、「1 つのまま」と「2 つに割る」のどちらが BIC で見て良いモデルかを比べます。割った方が良ければ採用し、良くなければそのクラスタは確定です。全体を一度に最適化するのではなく、クラスタごとに局所的な統計判定を積み重ねるので、k を 2 から 10 まで総当たりする手間が省けます。
k-means と X-means を同じデータで比べる #
X-means はクラスタリングの過程でクラスタ数を自動的に決めるアルゴリズムです。以下では make_blobs で中心が 10 個のデータを作り、k-means++ で k=5 を指定した結果と、pyclustering の xmeans に k を任せた結果を比較します。
Pelleg, Dan, and Andrew W. Moore. “X-means: Extending k-means with efficient estimation of the number of clusters.” Icml. Vol. 1. 2000.
| |
k-meansでkをあらかじめ指定 #
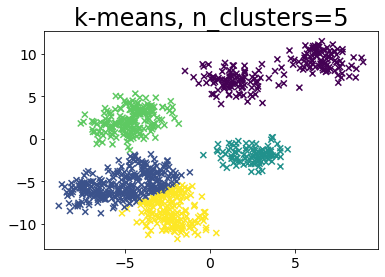
まず比較の基準として、中心 10 個のデータを KMeans(n_clusters=5) で分けます。k=5 は正解の 10 の半分なので、塊をまたいだ割り方になるはずです。
| |
実行結果の読み方 #
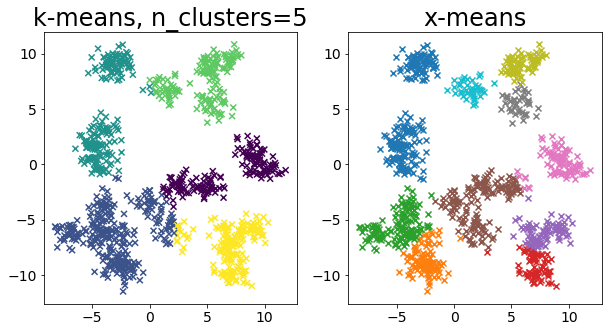
図では 10 個あるはずの塊が 5 色に塗られ、離れた 2 つの塊が同じ色になっている箇所が見つかります。k-means は与えられた k を忠実に守るので、k が正解とずれているとこの形の失敗になります。
x-meanでクラスタ数を指定せずに実行 #
BAYESIAN_INFORMATION_CRITERION #
同じデータを pyclustering の xmeans に渡します。初期クラスタ数 c_min=3 から出発し、BIC で分割の可否を判定しながら上限 c_max=10 まで増やします。
| |
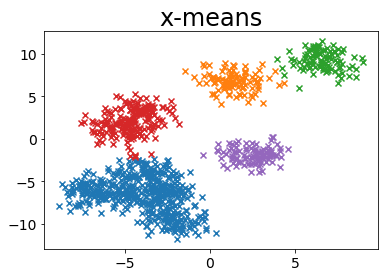
図では 10 個の塊がそれぞれ別の色に塗られ、k=5 の k-means で起きていた「2 つの塊が同じ色」が消えています。k を一度も指定していないのに正解の 10 に到達するのが X-means の効果です。
MINIMUM_NOISELESS_DESCRIPTION_LENGTH #
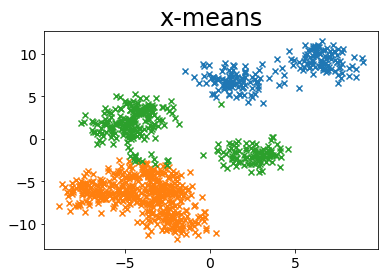
分割の判定基準を BIC から MNDL に替えて、同じ c_min=3、c_max=10 で実行します。
| |
toleranceの影響 #
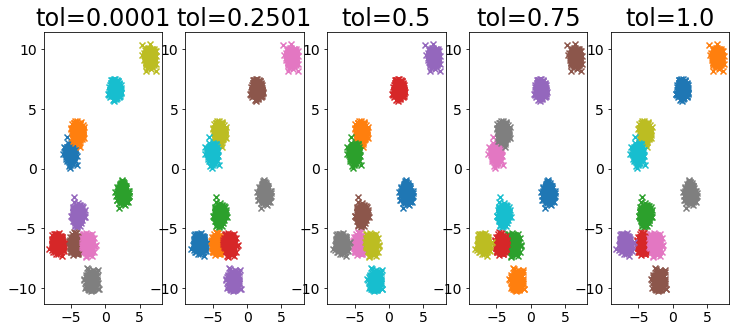
内部の k-means の収束閾値 tolerance を 0.0001 から 1 まで 5 段階で変え、散らばりの小さい(cluster_std=0.4)10 個の塊に対する結果を横に並べます。
| |
色々なデータに対して k-means と x-means を比較する #
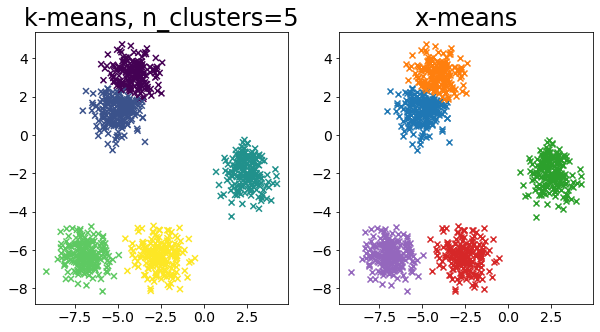
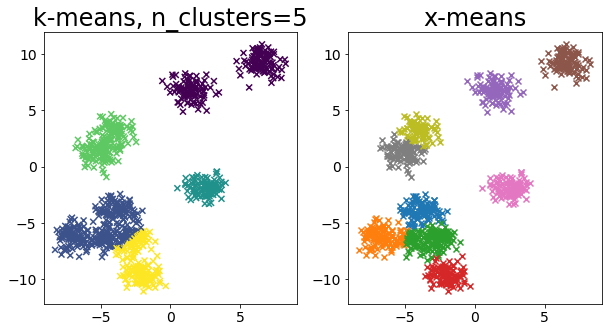
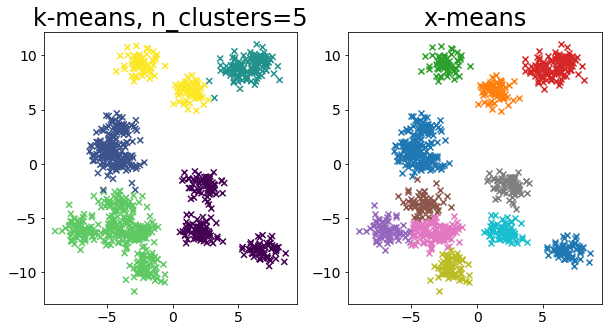
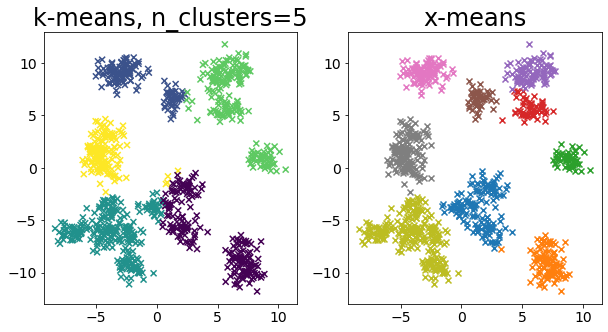
塊の数を 5, 10, 15, 20, 25 と増やした 5 種類のデータで、左に KMeans(n_clusters=5)、右に xmeans(c_min=3, c_max=20) の結果を並べます。
| |
実行結果の読み方 #
5 組の図のうち、左の k-means は塊が 10 個以上になると必ず複数の塊を 1 色にまとめます。右の X-means は 10、15、20 個の塊までは色の数が正解と揃い、25 個のデータだけ c_max=20 の上限に当たって分け切れません。X-means の答えは「k を決めずに済む」ことと「c_min・c_max の範囲内でしか探さない」ことの両方を含んでいます。
クラスタ数と K-Means #
スライダーで k-means の n_clusters を 2 から 10 まで動かすと、200 点の 4 つの塊に対するシルエット係数と inertia が変わります。シルエット係数は k=4 で最大の 0.80 になり、inertia は k を増やすほど単調に減って 4 以降は下がり方が緩やかになります。X-means が BIC で選ぶのも、この「4 で分割の価値がなくなる」地点です。
使いどころと落とし穴 #
X-means が向くのは、塊の数に見当がつかないが各塊は球状に近いデータです。判定に使う BIC が「クラスタ = 1 つの正規分布」を仮定しているので、三日月のような形のクラスタは不必要に 2 分割されます。そうしたデータでは DBSCAN や HDBSCAN のような密度ベースの手法を選びます。探索は c_min から増やす一方向なので、c_min を正解より大きくした誤りは直せず、c_max が小さいと上の 25 個の例のように分け切れません。初期中心は kmeans_plusplus_initializer で選びますが、k-means++ と同じく乱数に依存するので、random_state を変えて結果が揺れないかを確認してから採用します。
まとめ #
X-means は k-means で c_min 個に分けたあと、各クラスタを k=2 で割って BIC(または MNDL)が改善するかを判定し、改善するクラスタだけを割ることで k を自動で増やします。make_blobs(centers=10) のデータでは KMeans(n_clusters=5) が塊をまたいで塗り分けたのに対し、xmeans(c_min=3, c_max=10) は 10 個を言い当てました。結果を左右するのは c_min・c_max の探索範囲と内部 k-means の tolerance で、c_max が正解を下回ると分け切れません。球状でないクラスタには BIC の正規分布の仮定が合わないので、別の手法を選びます。