02.4.1 高校生向け
ランダムフォレスト(高校生向け)
こんな場面を想像してみよう #
文化祭の模擬店が「黒字になるか、赤字になるか」を予想します。過去の模擬店のデータ(場所・値段・メニューの数・天気・…)はたくさんあります。
1 人の先生に全データを見せて、「はい/いいえ」の質問で判断の木を作ってもらうこともできます。でも、その先生が去年の 1 件に引きずられていたら? そこで作戦を変えます。100 人の先生を呼び、それぞれにくじ引きで選んだ一部の記録だけを渡し、しかも見てよい項目もくじで制限して、めいめいに判断の木を作ってもらう。そして最後は 100 人の多数決。これがランダムフォレスト(たくさんの木=森)です。
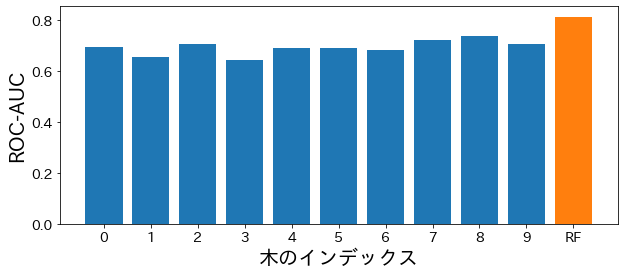
上の図は、森に入っている木を 1 本ずつ取り出して「当たりやすさ」(ROC-AUC という指標。1 に近いほど良い)を測ったものです。1 本ずつはどれも 0.7 前後なのに、多数決した森(右端のオレンジ)は 0.81。平凡な木を集めると、どの 1 本よりも強くなることが分かります。
仕組み:くじ引きで木を変え、多数決でまとめる #
まず、データをくじ引きで選び直します。元のデータが 1000 件なら、くじを 1000 回引いて(同じ件が何度出てもよい)木 1 本分の学習データを作ります。だいたい 3 分の 1 の件は選ばれず、代わりに何度も選ばれる件が出るので、木ごとに見ているデータが少しずつちがいます。
次に、質問を選ぶたびに使える特徴量を 20 個中 4 個くらいにくじで制限します。分類なら \(\sqrt{20} \approx 4\) 個だけを候補にして、その中から 決定木分類 と同じ基準でいちばん良い質問を選びます。この制限がないと、どの木も「いちばん強い特徴量」から始めてしまい、似た木ばかりになります。
これを木の本数だけ繰り返します。100 本なら 100 回です。木どうしは互いに関係なく作れるので、100 本を同時に(並列に)育てられ、コンピュータが 4 台あれば 25 本ずつ分担できます。
最後に、100 本の予測を多数決か平均でまとめます。分類なら新しい点を 100 本すべての木に通し、いちばん票の多いクラスを答えにします。回帰なら 100 本の予測値の平均です。
散布図の上では、1 本の木の境界は縦横の線でガタガタに区切られ、データが少し変わるだけで線の位置が大きく動きます。100 本重ねて多数決すると、たまたま 1 本だけが作った変な部屋は票が足りずに消え、多くの木が一致した境界だけが残ります。結果として境界はなめらかになり、学習データが 10 件入れ替わっても大きくは動かなくなります。
多数決で強くなる理由を確率で確かめる #
木が 1 本ずつ独立に正解率 0.7 だとして、\(n\) 本の多数決が正解する確率を計算してみます。3 本なら「3 本とも正解」か「2 本正解・1 本不正解」のときに多数決が正解なので、\(0.7^3 + {}_3\mathrm{C}_2 \times 0.7^2 \times 0.3 = 0.784\) です。
| |
1 本で 0.70、3 本で 0.78、11 本で 0.92、51 本で 0.999。ただしこれは「木どうしの間違いが独立」という前提の話です。全部の木が同じデータの同じ特徴量を見ていたら、同じところで同じ間違いをするので、本数を増やしても良くなりません。ステップ 1 と 2 のくじ引きは、この前提に少しでも近づけるための工夫です。
動かして見てみよう #
下の図で「再生」を押すと、説明した手順が 1 つずつ進みます。手順ごとの説明は図の下に出ます。
気をつけたいこと #
最初の注意点は、木が似ていると 100 本あっても効果が薄いことです。特徴量を 4 個にくじで制限しないと、どの木も同じ強い特徴量から始めて似た木になり、多数決の意味が薄れます。二つ目は、1 本の木ほど説明しやすくないことです。決定木は「この質問にこう答えたから」と理由を言えますが、100 本の多数決は一言では説明できません。代わりに「どの特徴量が効いたか」を重要度という数値で集計します。三つ目は、学習データの範囲の外は予測できないことです。回帰では 100 本の木の平均を返すので、学習データの最大値より大きい値は出せません。これは決定木から引き継いだ性質です。
やってみよう #
最初の課題は、10 問の○×クイズを友だち 5 人に解いてもらい、1 人ずつの正解数と「5 人の多数決」の正解数を比べることです。多数決のほうが上がったでしょうか。全員が同じ問題を間違えたとき、5 人の多数決は役に立ったでしょうか。二つ目は、上のコードの p を 0.5 や 0.4 に変えて実行してみることです。1 本ずつが半分しか当たらないとき、51 本の多数決は強くなるでしょうか。三つ目は、「くじ引きで一部のデータだけを見せる」のが有利になる場面と、不利になる場面を 1 つずつ考えることです。ヒントは、データが 20 件しかないような極端に少ないときです。
つぎに読む #
分散が下がる式、特徴量の重要度の 2 つの測り方、OOB スコア、scikit-learn の RandomForestClassifier での実装は 標準版のランダムフォレスト で扱っています。森をつくる 1 本の木の仕組みは 高校生向けの決定木分類 と 高校生向けの決定木回帰 へ進んでください。木を「同時に」ではなく「順番に」育てる別の方法は アンサンブル学習 の勾配ブースティングで扱います。