K_DM Book
用語集
対象者 標準
対象者別の入口 →

対象者の設定はこのブラウザの中にだけ保存されます。

言語 JA

【ベンチマーク】分散不均一な回帰

中級

02.1.13

【ベンチマーク】分散不均一な回帰

最終更新 2026-03-06 読了時間 6 分
まとめ
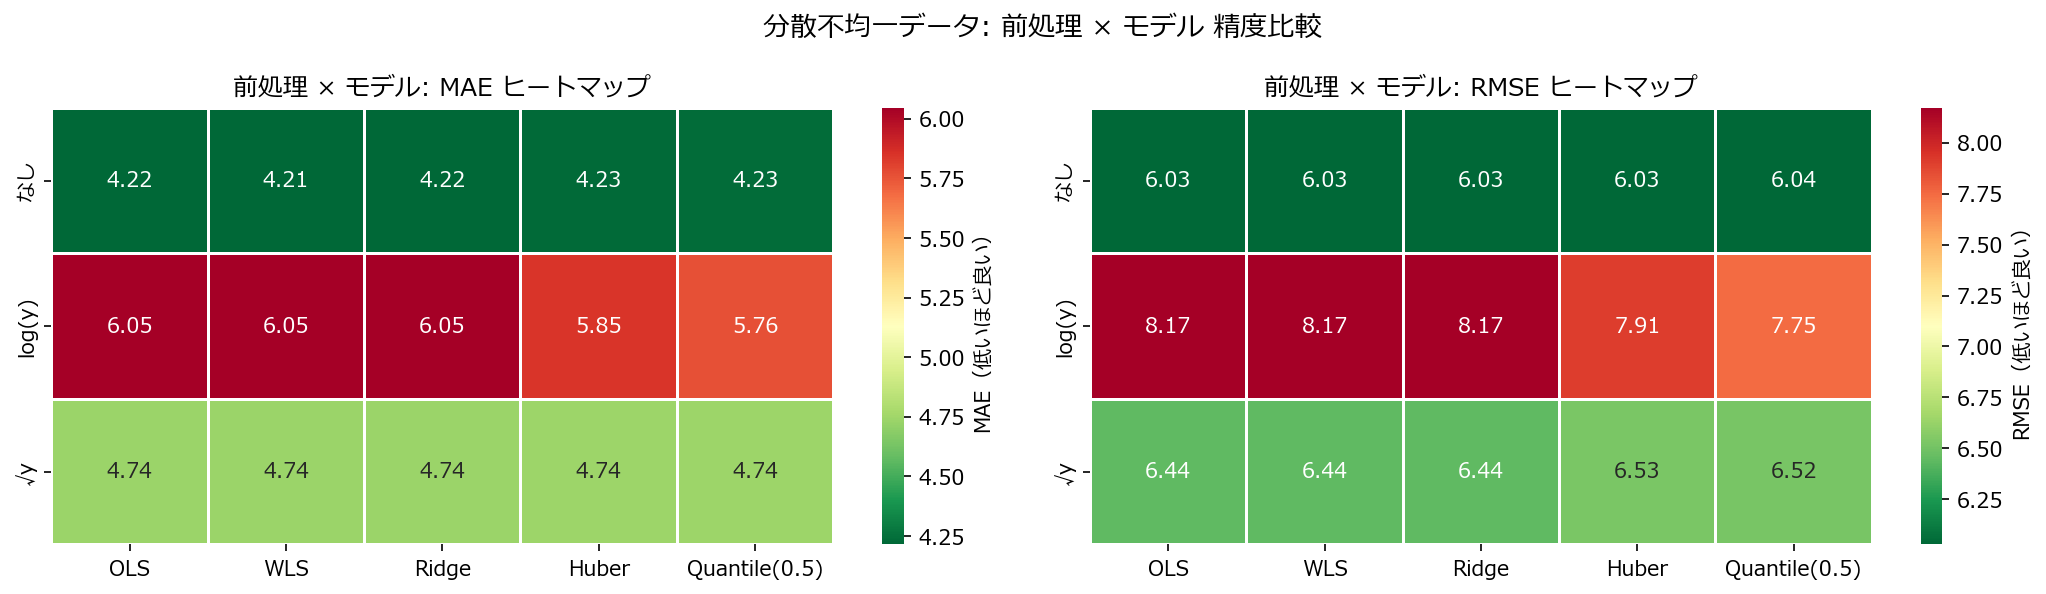
このベンチマークでは、\(y = 3x + \epsilon\)、\(\epsilon \sim N(0, (0.5x)^2)\) と \(x\) が大きいほどノイズが広がる 500 点のデータで、OLS・WLS・Ridge・HuberRegressor・QuantileRegressor の 5 モデルを比較します。前処理として「なし」「log(y)」「√y」の 3 通りを掛け合わせ、5 分割交差検証の MAE と RMSE をヒートマップで並べます。OLS の傾きの推定は不偏のまま 3 に近づきますが、\(x\) の大きい区間で残差が扇形に広がり、予測区間の幅を一律に見積もると実態と合わなくなります。WLS に正しい重み \(1/x^2\) を与えるか log 変換で分散を揃えると、残差の広がりが均一になります。

売上が大きい店舗ほど売上のブレも大きい、所得が高いほど消費のばらつきも大きい——実務データでは分散が一定でないケースが多い。等分散を仮定する OLS をそのまま適用すると、係数推定は正しくても信頼区間や予測区間が歪む。ここでは分散不均一(heteroscedasticity)な合成データで最適なアプローチを検証する。


1. データの特徴 #

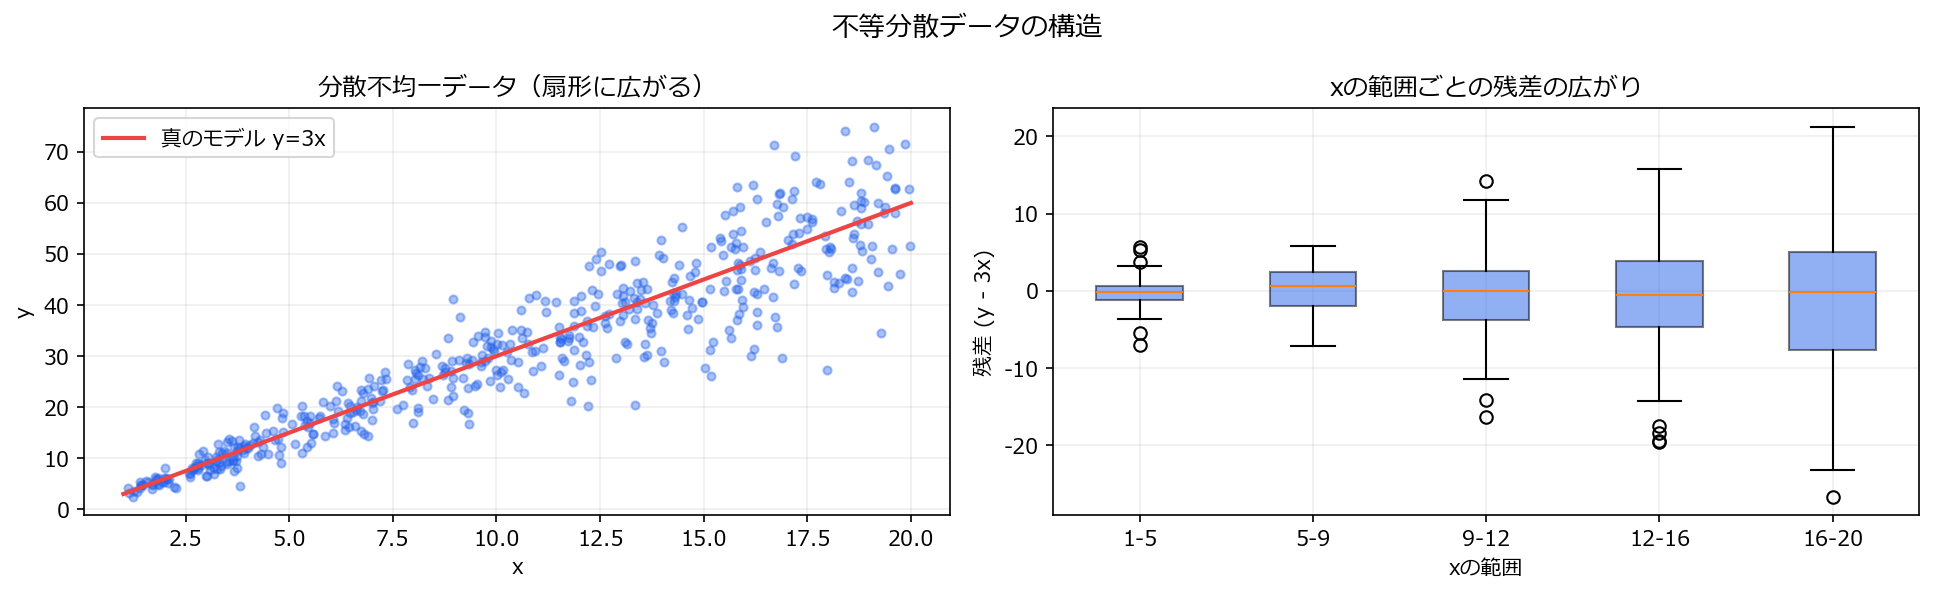
説明変数は 1 つで、\(x\) は \([1, 20]\) の一様分布から 500 点を引きます。真のモデルは \(y = 3x + \epsilon\) で、ノイズ \(\epsilon \sim N(0, (0.5x)^2)\) の標準偏差が \(0.5x\) と \(x\) に比例して増えます。\(x = 1\) では標準偏差 0.5、\(x = 20\) では 10 なので、散布図は右に行くほど扇形に広がります。

何が起きているか(ステップで見る) #

コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。

見るポイント:RMSE は二乗するぶん 1 つの大外れに引きずられる。MAE は線形、中央絶対誤差はほぼ動かない。

2. 合成データの生成 #

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

rng = np.random.default_rng(42)
n = 500

x = rng.uniform(1, 20, size=n)
noise = rng.normal(0, 0.5 * x)
y = 3 * x + noise

fig, axes = plt.subplots(1, 2, figsize=(13, 4))

axes[0].scatter(x, y, alpha=0.4, s=15, color="#2563eb")
axes[0].plot([1, 20], [3, 60], color="#ef4444", linewidth=2, label="真のモデル y=3x")
axes[0].set_title("分散不均一データ(扇形に広がる)")
axes[0].set_xlabel("x")
axes[0].set_ylabel("y")
axes[0].legend()
axes[0].grid(alpha=0.2)

# 残差の分散をxの範囲ごとに可視化
bins = np.linspace(1, 20, 6)
bin_labels = [f"{bins[i]:.0f}-{bins[i+1]:.0f}" for i in range(len(bins)-1)]
residuals = y - 3 * x
bin_idx = np.digitize(x, bins) - 1
bin_idx = np.clip(bin_idx, 0, len(bin_labels) - 1)
bp_data = [residuals[bin_idx == i] for i in range(len(bin_labels))]
bp = axes[1].boxplot(bp_data, labels=bin_labels, patch_artist=True)
for patch in bp["boxes"]:
    patch.set_facecolor("#2563eb")
    patch.set_alpha(0.5)
axes[1].set_title("xの範囲ごとの残差の広がり")
axes[1].set_xlabel("xの範囲")
axes[1].set_ylabel("残差 (y - 3x)")
axes[1].grid(alpha=0.2)

fig.suptitle("不等分散データの構造", fontsize=13)
fig.tight_layout()
plt.show()

不等分散データの構造

3. 比較するパイプライン #

前処理説明モデル
なし(生データ)そのまま回帰5モデル
log(y) 変換対数変換で分散安定化5モデル
√y 変換平方根変換で分散安定化5モデル
モデル特徴
OLS最小二乗法(等分散仮定)
WLS重み付き最小二乗法(weights=1/x²)
RidgeL2正則化
Huberロバスト回帰(外れ値に強い)
Quantile(0.5)中央値回帰(分布の歪みに強い)

4. 実験と結果 #

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
from sklearn.model_selection import cross_val_score, KFold
from sklearn.linear_model import LinearRegression, Ridge, HuberRegressor, QuantileRegressor
from sklearn.preprocessing import FunctionTransformer
from sklearn.pipeline import Pipeline
from sklearn.base import clone
import seaborn as sns

cv = KFold(n_splits=5, shuffle=True, random_state=42)
X = x.reshape(-1, 1)

# 変換関数
def log_transform(y):
    return np.log1p(y)

def sqrt_transform(y):
    return np.sqrt(np.maximum(y, 0))

def inv_log(y):
    return np.expm1(y)

def inv_sqrt(y):
    return y ** 2

models = {
    "OLS": LinearRegression(),
    "WLS": LinearRegression(),  # 手動で重み適用
    "Ridge": Ridge(alpha=1.0),
    "Huber": HuberRegressor(epsilon=1.35),
    "Quantile(0.5)": QuantileRegressor(quantile=0.5, alpha=0.0, solver="highs"),
}

transforms = {
    "なし": (None, None),
    "log(y)": (log_transform, inv_log),
    "√y": (sqrt_transform, inv_sqrt),
}

results = []
for trans_name, (fwd, inv) in transforms.items():
    for mdl_name, mdl in models.items():
        maes, rmses = [], []
        for train_idx, test_idx in cv.split(X):
            X_tr, X_te = X[train_idx], X[test_idx]
            y_tr, y_te = y[train_idx], y[test_idx]

            y_fit = fwd(y_tr) if fwd else y_tr

            m = clone(mdl)
            if mdl_name == "WLS" and fwd is None:
                # 重みを 1/x² に設定
                w = 1.0 / (X_tr.ravel() ** 2 + 1e-6)
                m.fit(X_tr, y_fit, sample_weight=w)
            else:
                try:
                    m.fit(X_tr, y_fit)
                except Exception:
                    maes.append(np.nan)
                    rmses.append(np.nan)
                    continue

            pred = m.predict(X_te)
            if inv:
                pred = inv(pred)

            maes.append(np.mean(np.abs(y_te - pred)))
            rmses.append(np.sqrt(np.mean((y_te - pred) ** 2)))

        results.append({
            "前処理": trans_name, "モデル": mdl_name,
            "MAE": np.nanmean(maes), "RMSE": np.nanmean(rmses),
        })

df_res = pd.DataFrame(results)
pivot = df_res.pivot_table(index="前処理", columns="モデル", values="MAE")
trans_order = ["なし", "log(y)", "√y"]
mdl_order = ["OLS", "WLS", "Ridge", "Huber", "Quantile(0.5)"]
pivot = pivot.reindex(index=[t for t in trans_order if t in pivot.index],
                      columns=[m for m in mdl_order if m in pivot.columns])

fig, axes = plt.subplots(1, 2, figsize=(14, 4))

sns.heatmap(pivot, annot=True, fmt=".2f", cmap="RdYlGn_r",
            linewidths=0.5, ax=axes[0], cbar_kws={"label": "MAE(低いほど良い)"})
axes[0].set_title("前処理 × モデル: MAE ヒートマップ")
axes[0].set_xlabel("")
axes[0].set_ylabel("")

pivot_rmse = df_res.pivot_table(index="前処理", columns="モデル", values="RMSE")
pivot_rmse = pivot_rmse.reindex(index=[t for t in trans_order if t in pivot_rmse.index],
                                columns=[m for m in mdl_order if m in pivot_rmse.columns])
sns.heatmap(pivot_rmse, annot=True, fmt=".2f", cmap="RdYlGn_r",
            linewidths=0.5, ax=axes[1], cbar_kws={"label": "RMSE(低いほど良い)"})
axes[1].set_title("前処理 × モデル: RMSE ヒートマップ")
axes[1].set_xlabel("")
axes[1].set_ylabel("")

fig.suptitle("分散不均一データ: 前処理 × モデル 精度比較", fontsize=13)
fig.tight_layout()
plt.show()

精度比較ヒートマップ

読み方のポイント #

OLS の傾きの推定は 3 に近く正しいのですが、\(x\) が大きい区間の残差がそのまま MAE と RMSE に乗るため、生データの行では他のモデルと大差がつきません。WLS に正しい重み \(1/x^2\) を与えると、ノイズの小さい左側の点で直線が決まり、傾きの推定の分散が小さくなります。ただし MAE・RMSE は元の尺度で測るので、右側の大きなノイズ自体は消えず、改善幅は限定的です。log(y) の行では変換後の分散がほぼ均一になるため、5 モデルすべてで RMSE が揃う方向に動きます。


5. 誤差パターン分析 #

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
from sklearn.model_selection import train_test_split
from sklearn.base import clone

X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=42)

configs = [
    ("OLS(生データ)", LinearRegression(), None, None, None),
    ("WLS(1/x²重み)", LinearRegression(), None, None, "wls"),
    ("OLS + log(y)", LinearRegression(), log_transform, inv_log, None),
]

fig, axes = plt.subplots(1, 3, figsize=(15, 4))
for i, (name, mdl, fwd, inv, special) in enumerate(configs):
    m = clone(mdl)
    y_fit = fwd(y_tr) if fwd else y_tr

    if special == "wls":
        w = 1.0 / (X_tr.ravel() ** 2 + 1e-6)
        m.fit(X_tr, y_fit, sample_weight=w)
    else:
        m.fit(X_tr, y_fit)

    pred = m.predict(X_te)
    if inv:
        pred = inv(pred)

    residuals = y_te - pred
    axes[i].scatter(X_te, residuals, alpha=0.4, s=15, color="#2563eb")
    axes[i].axhline(0, color="#ef4444", linewidth=1, linestyle="--")
    axes[i].set_title(f"{name}", fontsize=10)
    axes[i].set_xlabel("x")
    axes[i].set_ylabel("残差")
    axes[i].grid(alpha=0.2)

    # 残差の標準偏差をx範囲ごとに表示
    for xmin, xmax in [(1, 7), (7, 14), (14, 20)]:
        mask = (X_te.ravel() >= xmin) & (X_te.ravel() < xmax)
        if mask.sum() > 0:
            std = residuals[mask].std()
            axes[i].text((xmin + xmax) / 2, axes[i].get_ylim()[1] * 0.85,
                        f"σ={std:.1f}", ha="center", fontsize=8,
                        bbox=dict(boxstyle="round", facecolor="#f0f0f0", alpha=0.8))

fig.suptitle("残差パターンの比較(x範囲ごとのσを表示)", fontsize=13)
fig.tight_layout()
plt.show()

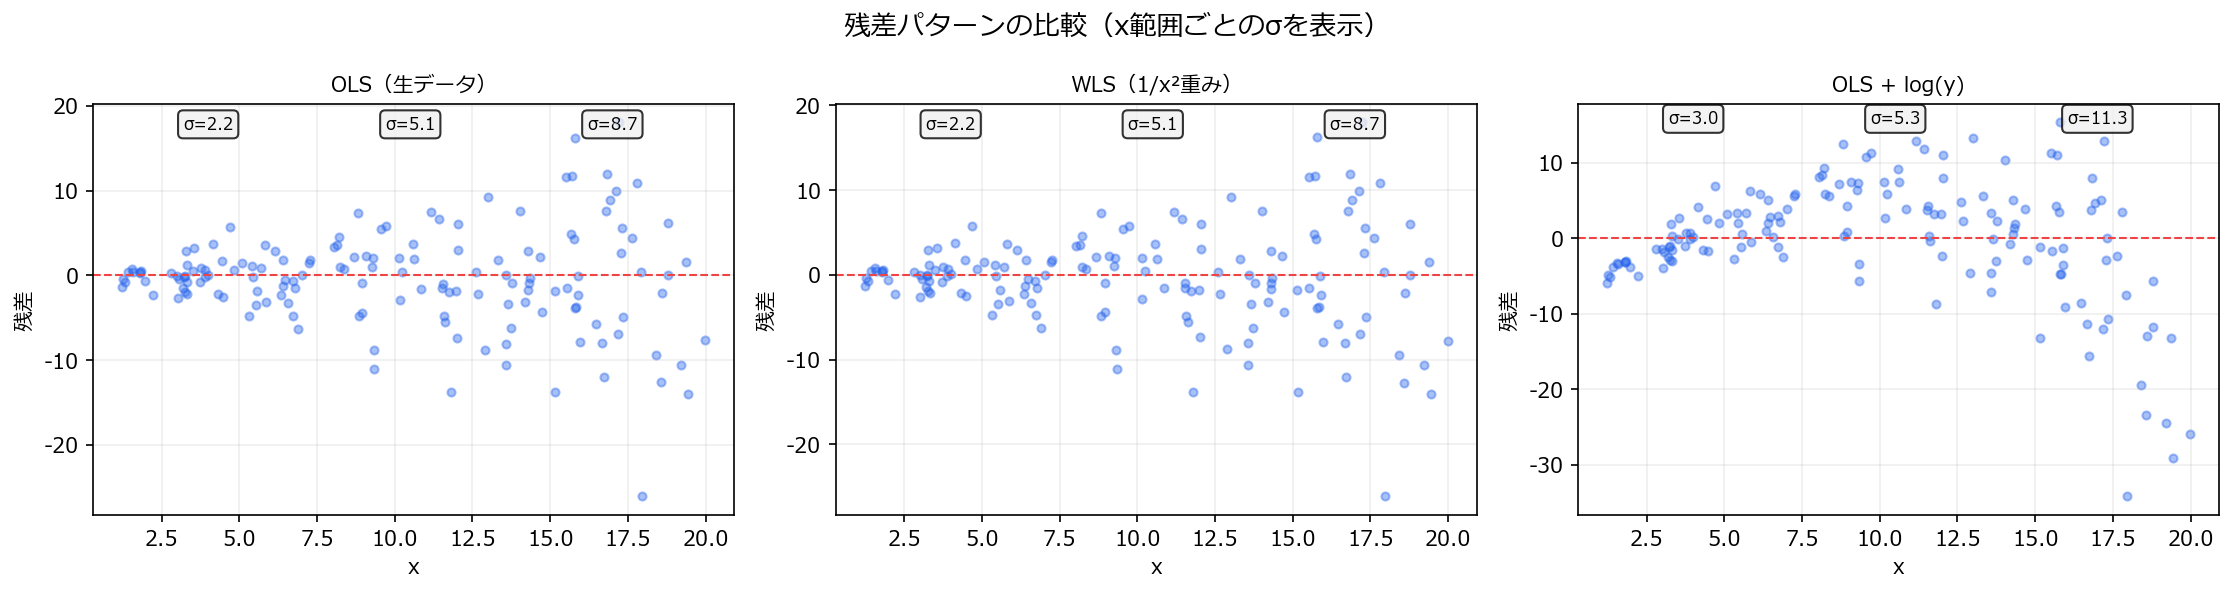
残差パターン比較

OLS の残差は \(x\) が大きくなるにつれて扇形に広がり、3 区間の σ が左から右へ増えていきます(不等分散の典型)。WLS でも元の尺度の残差は右側で大きいままですが、直線の位置はノイズの小さい左側で決まっています。log 変換では 3 区間の σ がほぼ揃い、分散が均質化されたことが数値で確認できます。


6. よくある失敗パターン #

1 つ目は OLS のまま予測区間を計算することです。等分散を仮定した予測区間は残差全体の標準偏差 1 本で幅を決めるので、\(x = 20\) 付近では実際のばらつき(σ ≈ 10)より狭く、\(x = 1\) 付近では実際(σ ≈ 0.5)より広くなります。2 つ目は対数変換の逆変換でバイアスを無視することで、log(y) で学習した予測を expm1 で戻すと、期待値ではなく中央値の推定になります。期待値が必要なら Duan のスミアリング推定などでバイアス補正を行います。