02.1.2
リッジ・ラッソ
RidgeCV / LassoCV が交差検証で選びます。このページでは 10 特徴量のうち 3 つだけが効く 200 件の人工データで、線形回帰・リッジ・ラッソの係数を棒グラフで並べ、\(\alpha\) を動かした正則化パスで両者の縮み方の違いを見ます。先に 線形回帰 で最小二乗法が残差二乗和だけを最小にしていることを確認しておくと、このページで足すのが「罰則の項 1 つ」だけだと分かります。
直感 #
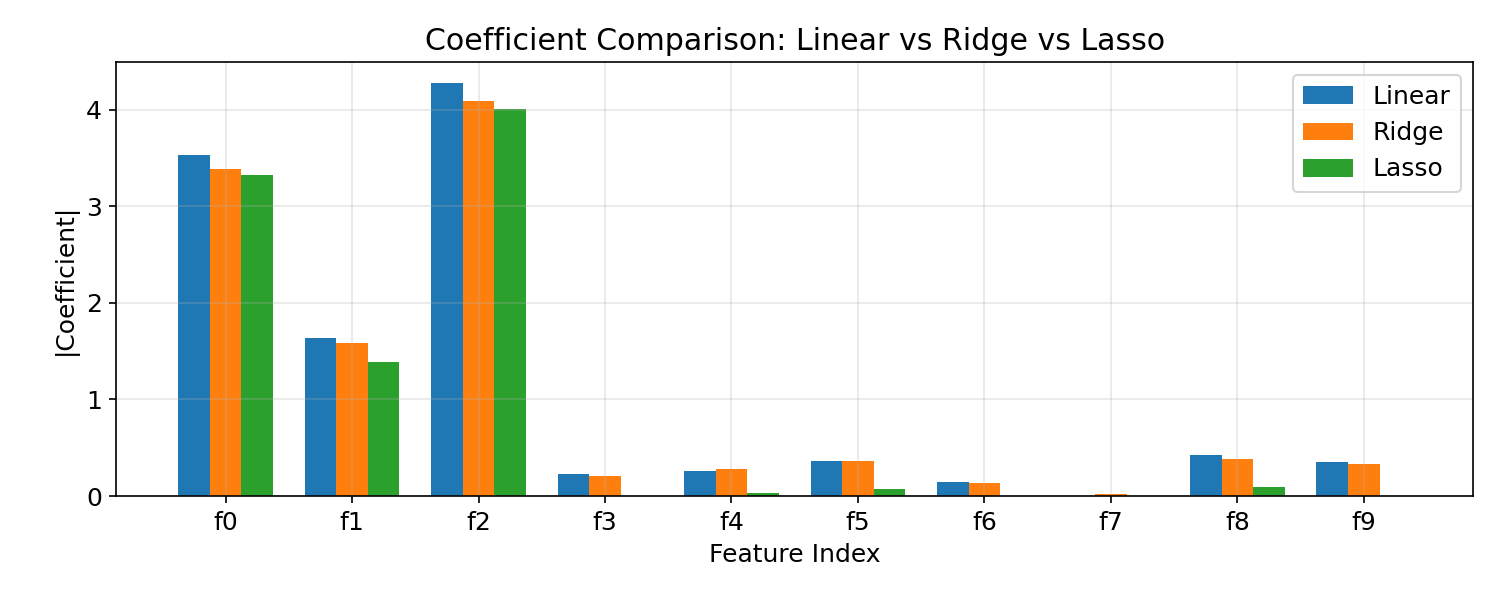
10 個の特徴量で 200 件を説明する最小二乗法は、本当は効かない 7 個の列にも小さな係数を付けます。説明変数どうしの相関が強いと、片方に +10、もう片方に −9 のような打ち消し合う係数が出ます。データが少し変わるだけで符号が入れ替わることもあります。リッジ回帰とラッソ回帰は、残差二乗和に \(\alpha \times\) 罰則を足し、「当てはまりを少し犠牲にしてでも係数を小さく保つ」方向に解をずらします。リッジは 10 本の係数すべてを比例的に縮め、ラッソは小さい係数から順にちょうど 0 にするので、下の棒グラフでは青→橙→緑の順に棒が低くなり、緑だけ消える棒が出ます。
何が起きているか(ステップで見る) #
コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。
見るポイント:罰則 α を強めるほど係数が縮み、曲線が暴れなくなる。強すぎると当てはまりが悪くなる。下のコードでは、この α を RidgeCV と LassoCV が 5 分割交差検証で自動的に選びます。
式で書くと何を足しているか #
どちらも第 1 項は最小二乗法と同じ残差二乗和で、違いは第 2 項の罰則の測り方だけです。リッジ回帰は係数の 2 乗和 \(\lVert \boldsymbol\beta \rVert_2^2\) を罰します。
$$ \min_{\boldsymbol\beta, b} \sum_{i=1}^{n} \left(y_i - (\boldsymbol\beta^\top \mathbf{x}_i + b)\right)^2 + \alpha \lVert \boldsymbol\beta \rVert_2^2 $$ラッソ回帰は係数の絶対値の和 \(\lVert \boldsymbol\beta \rVert_1\) を罰します。
$$ \min_{\boldsymbol\beta, b} \sum_{i=1}^{n} \left(y_i - (\boldsymbol\beta^\top \mathbf{x}_i + b)\right)^2 + \alpha \lVert \boldsymbol\beta \rVert_1 $$\(\alpha\) を大きくすると係数はより強く抑えられ、\(\alpha = 0\) なら両方とも最小二乗法に戻ります。2 乗の罰則は係数が 0 に近づくほど弱くなるのでリッジの係数は 0 に届きませんが、絶対値の罰則は 0 の手前でも傾きが一定なので、ラッソでは \(\alpha\) がある閾値を超えた係数がちょうど 0 になります。
Pythonを用いた実験や説明 #
次のコードは、10 個の特徴量のうち先頭 3 個だけに係数 3 前後を置いた 200 件のデータを作り、線形回帰・RidgeCV・LassoCV の 3 モデルを同じ標準化パイプラインで学習します。係数の絶対値を 10 本の棒で並べ、最後に 5 分割交差検証の R² を印字して汎化性能を比べます。
| |
実行結果の読み方 #
インデックス 0〜2 の 3 本は 3 色とも高く立ち、青(Linear)より橙(Ridge)が少し低く、緑(Lasso)はさらに少し低くなります。これが罰則による縮みです。インデックス 3〜9 では青に小さな棒が残り、橙はそれを縮め、緑は多くが消えて 0 になります。印字される 5 分割交差検証の R² は 3 手法で大きく違わないので、正則化の効果は「精度を上げる」より「不要な係数を消して解釈しやすくし、データが変わっても係数が安定する」点にあると読んでください。
正則化パスの可視化 #
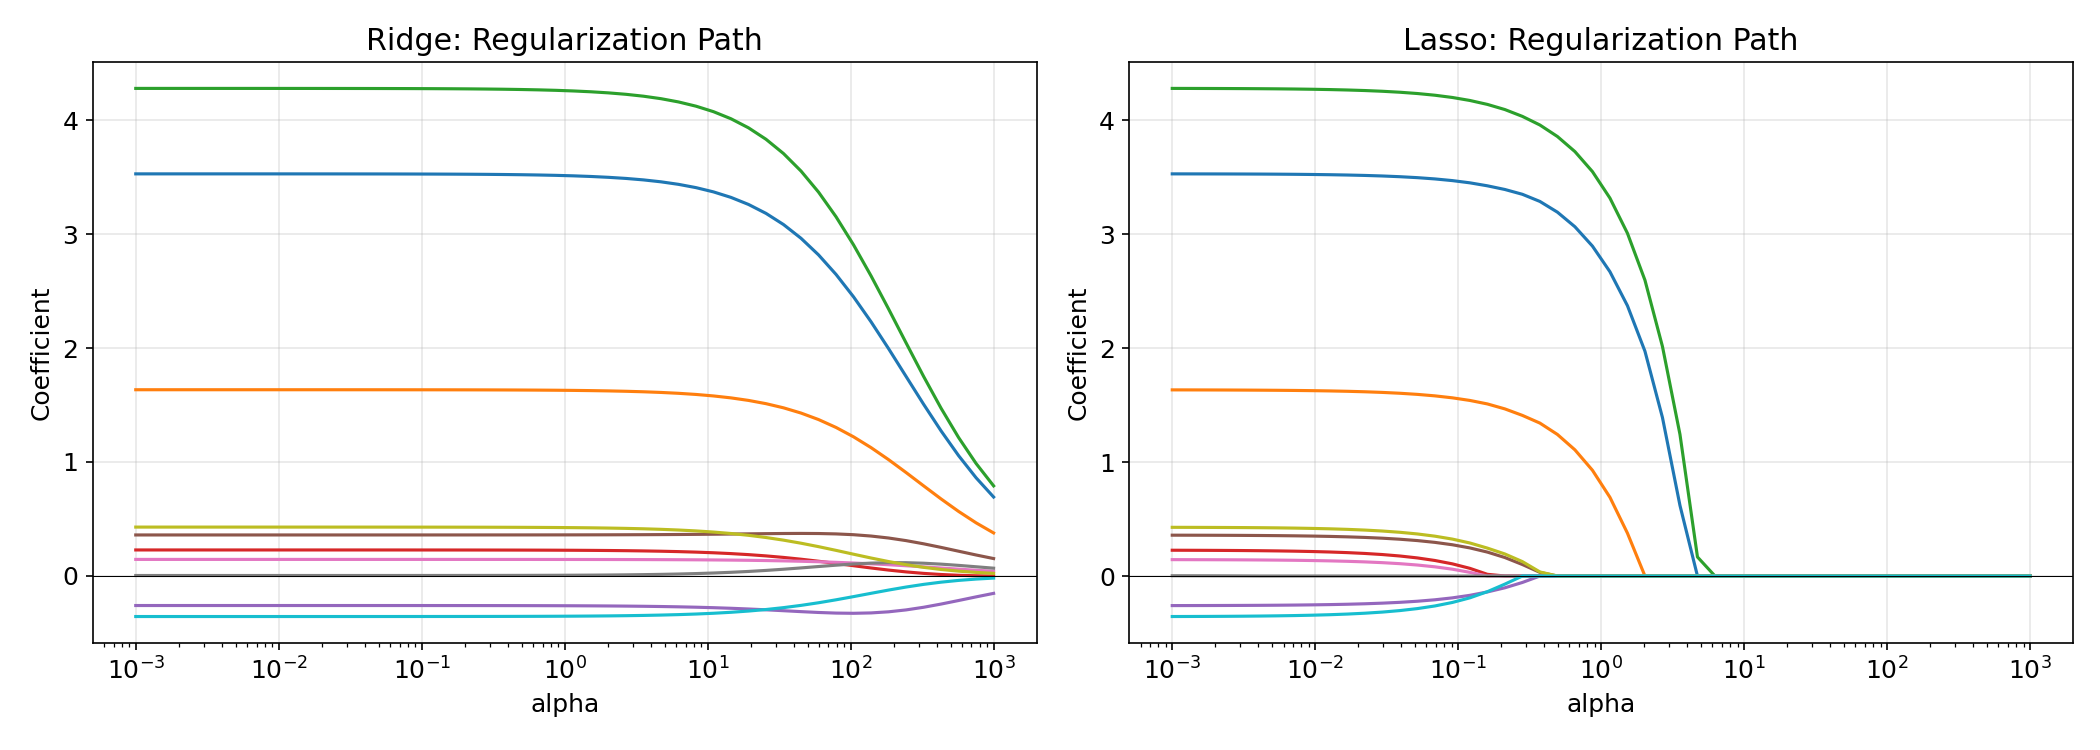
\(\alpha\) を変化させたときの係数の軌跡を正則化パスと呼びます。リッジでは係数が滑らかに 0 に近づき、ラッソではある閾値で急に 0 になる様子が確認できます。
リッジ回帰とラッソ回帰は特徴量のスケールに敏感です。標準化(StandardScaler)を適用せずに学習すると、スケールの大きい特徴量が過剰にペナルティを受け、正しい係数推定ができません。必ずパイプラインに標準化を含めてください。
リッジとラッソの使い分けに迷ったら、RidgeCVとLassoCVの両方を試して交差検証スコアを比較してください。特徴量が多く不要な変数が含まれている場合はラッソ、多重共線性が疑われる場合はリッジが有効です。両方の性質が欲しい場合はElastic Netを検討してください。
正則化係数と回帰曲線 #
スライダーで正則化係数 α を 0.01 から 100 まで変えると、多項式の回帰曲線が暴れた形から平らな形へ縮んでいく様子を確認できます。
Ridge の係数パス #
スライダーで正則化係数 α を大きくすると、10 本の係数がなだらかな曲線で 0 に近づいていきます。ラッソのようにぴたりと 0 に張り付く線がないことを確認してください。
まとめ #
リッジ回帰は L2 罰則で 10 本の係数をすべてなだらかに縮め、説明変数どうしの相関が強くても符号が入れ替わらない安定した推定を返します。ラッソ回帰は L1 罰則で不要な 7 本の係数をちょうど 0 にするので、特徴量選択とモデルの解釈を兼ねられます。罰則の強さ \(\alpha\) は RidgeCV / LassoCV に対数刻みの候補を渡して交差検証で選ぶのが実務の定番で、StandardScaler を make_pipeline に組み込まないと分散の大きい列だけ罰則が弱くなります。相関の強い列をグループで残したいときは、両方の罰則を混ぜた Elastic Net に進んでください。
参考文献 #
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge Regression: Biased Estimation for Nonorthogonal Problems. Technometrics, 12(1), 55–67.
- Tibshirani, R. (1996). Regression Shrinkage and Selection via the Lasso. Journal of the Royal Statistical Society: Series B, 58(1), 267–288.
- Zou, H., & Hastie, T. (2005). Regularization and Variable Selection via the Elastic Net. Journal of the Royal Statistical Society: Series B, 67(2), 301–320.
- 線形回帰 — 正則化なしの基本手法
- Elastic Net — L1+L2 の折衷
- 多項式回帰 — 正則化が特に有効な非線形回帰
- Huber Loss — 外れ値に頑健な損失関数