02.3.4
RuleFit
sqft_living > 9475」「grade > 8.5 & sqft_living > 3405」のような if-then ルール(0/1 の特徴量)に変換し、元の数値特徴量と一緒に L1 正則化(Lasso)つきの線形モデルに入れて予測する手法です。L1 正則化が多くのルールの係数を 0 にするので、max_rules=100 で始めても最終的に残るのは係数が非 0 の数十本だけになります。各ルールの係数を見れば「この条件に当たると価格が約 19 万ドル上がる」と読めるため、木のアンサンブルに近い表現力を保ちながら線形モデルの解釈性を得られます。読み終えると、get_rules() の coef・support・importance の意味を読み、ルールが実データで本当に成り立つかを箱ひげ図で検証できるようになります。決定木分類器 で「根から葉への経路が条件の AND になる」ことを先に学ぶと、RuleFit のルールがその経路そのものだと分かって理解がスムーズです。
直感 #
住宅価格を予測するとき、線形回帰は「床面積 1 平方フィートあたり 55 ドル」のように特徴量ごとに 1 つの傾きしか持てません。決定木なら「床面積が 3405 を超え、かつ grade が 8.5 を超える家」のような組み合わせの効果を表せますが、1 本の木は不安定です。RuleFit はこの 2 つを合わせ、まず勾配ブースティングで浅い木を多数作り、根から各ノードへの経路を 1 本ずつ「条件に当たれば 1、外れれば 0」のルール特徴量に変換します。次に、元の数値特徴量とこれらのルールをまとめて Lasso 回帰に入れ、効かないルールの係数を 0 に落とします。残った係数つきルールの一覧が、そのままモデルの説明になります。
詳細な解説 #
Friedman, Jerome H and Bogdan E Popescu. “Predictive learning via rule ensembles.” The Annals of Applied Statistics. JSTOR, 916–54. (2008).(pdf)
実験用のデータを取得する #
openml で公開されている CC0 Public Domain のデータセット house_sales を使って、アメリカ・キング郡の住宅価格 price を予測する回帰モデルを作ります。次のコードは fetch_openml でデータを取得し、数値列だけを説明変数 X に残します。
上記openmlページではデータの出典が不明ですが自分が調べた限りではデータの提供元はここのようです。
| |
データの中身を確認する #
| |
| bedrooms | bathrooms | sqft_living | sqft_lot | floors | waterfront | view | condition | grade | sqft_above | sqft_basement | yr_built | yr_renovated | lat | long | sqft_living15 | sqft_lot15 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3.0 | 1.00 | 1180.0 | 5650.0 | 1.0 | 0.0 | 0.0 | 3.0 | 7.0 | 1180.0 | 0.0 | 1955.0 | 0.0 | 47.5112 | -122.257 | 1340.0 | 5650.0 |
| 1 | 3.0 | 2.25 | 2570.0 | 7242.0 | 2.0 | 0.0 | 0.0 | 3.0 | 7.0 | 2170.0 | 400.0 | 1951.0 | 1991.0 | 47.7210 | -122.319 | 1690.0 | 7639.0 |
| 2 | 2.0 | 1.00 | 770.0 | 10000.0 | 1.0 | 0.0 | 0.0 | 3.0 | 6.0 | 770.0 | 0.0 | 1933.0 | 0.0 | 47.7379 | -122.233 | 2720.0 | 8062.0 |
| 3 | 4.0 | 3.00 | 1960.0 | 5000.0 | 1.0 | 0.0 | 0.0 | 5.0 | 7.0 | 1050.0 | 910.0 | 1965.0 | 0.0 | 47.5208 | -122.393 | 1360.0 | 5000.0 |
| 4 | 3.0 | 2.00 | 1680.0 | 8080.0 | 1.0 | 0.0 | 0.0 | 3.0 | 8.0 | 1680.0 | 0.0 | 1987.0 | 0.0 | 47.6168 | -122.045 | 1800.0 | 7503.0 |
| 5 | 4.0 | 4.50 | 5420.0 | 101930.0 | 1.0 | 0.0 | 0.0 | 3.0 | 11.0 | 3890.0 | 1530.0 | 2001.0 | 0.0 | 47.6561 | -122.005 | 4760.0 | 101930.0 |
| 6 | 3.0 | 2.25 | 1715.0 | 6819.0 | 2.0 | 0.0 | 0.0 | 3.0 | 7.0 | 1715.0 | 0.0 | 1995.0 | 0.0 | 47.3097 | -122.327 | 2238.0 | 6819.0 |
| 7 | 3.0 | 1.50 | 1060.0 | 9711.0 | 1.0 | 0.0 | 0.0 | 3.0 | 7.0 | 1060.0 | 0.0 | 1963.0 | 0.0 | 47.4095 | -122.315 | 1650.0 | 9711.0 |
| 8 | 3.0 | 1.00 | 1780.0 | 7470.0 | 1.0 | 0.0 | 0.0 | 3.0 | 7.0 | 1050.0 | 730.0 | 1960.0 | 0.0 | 47.5123 | -122.337 | 1780.0 | 8113.0 |
| 9 | 3.0 | 2.50 | 1890.0 | 6560.0 | 2.0 | 0.0 | 0.0 | 3.0 | 7.0 | 1890.0 | 0.0 | 2003.0 | 0.0 | 47.3684 | -122.031 | 2390.0 | 7570.0 |
RuleFitを実行する #
Python implementation of the rulefit algorithm - GitHub の実装を使用して RuleFit を動かします。次のコードは最大 100 本のルールを作る設定で学習し、内部で使われた木モデルの設定を表示します。
※実行する際は import warnings;warnings.simplefilter('ignore') は外してください
| |
RuleFit(max_rules=100,
        tree_generator=GradientBoostingRegressor(learning_rate=0.01,
                                                 max_depth=100,
                                                 max_leaf_nodes=5,
                                                 n_estimators=28,
                                                 random_state=27,
                                                 subsample=0.04543939429397564))
作成されたルールを確認する #
学習後に get_rules() を呼ぶと、元の特徴量(type = linear)と木から作られたルール(type = rule)が係数つきで 1 つの表に並びます。次のコードは係数が 0 でないものだけを残し、重要度の高い順に 10 件表示します。
| |
| rule | type | coef | support | importance | |
|---|---|---|---|---|---|
| 8 | grade | linear | 6.199314e+04 | 1.000000 | 66184.725645 |
| 29 | sqft_living > 9475.0 | rule | 1.927942e+06 | 0.001018 | 61491.753935 |
| 43 | grade > 8.5 & sqft_living > 3405.0 & long <= -... | rule | 3.570118e+05 | 0.024440 | 55126.384264 |
| 2 | sqft_living | linear | 5.532732e+01 | 1.000000 | 46347.924165 |
| 11 | yr_built | linear | -1.522004e+03 | 1.000000 | 44393.726859 |
| 15 | sqft_living15 | linear | 5.344916e+01 | 1.000000 | 34501.058499 |
| 62 | lat <= 47.516000747680664 & sqft_living <= 3920.0 | rule | -6.549757e+04 | 0.361507 | 31467.457947 |
| 103 | sqft_basement <= 3660.0 & grade > 9.5 | rule | 1.240216e+05 | 0.068228 | 31270.434139 |
| 48 | sqft_living <= 9475.0 & grade > 9.5 & long > -... | rule | -1.473030e+05 | 0.040733 | 29117.596559 |
| 67 | sqft_living <= 4695.0 & waterfront > 0.5 & sqf... | rule | 3.936285e+05 | 0.005092 | 28016.079499 |
ルールが正しいか確認してみる #
RuleFit が出したルールは「学習データでそう見えた」だけなので、元データで裏取りします。上の表とは別の実行で得られた sqft_above linear 8.632149e+01 1.000000 66243.550192 の線形項に基づいて、sqft_above(地上部分の面積)が増えると y(price)が増える傾向にあるかどうかを散布図で確認します。
| |
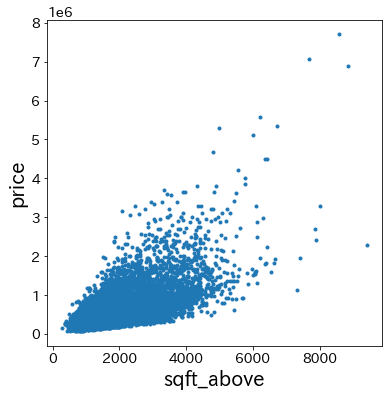
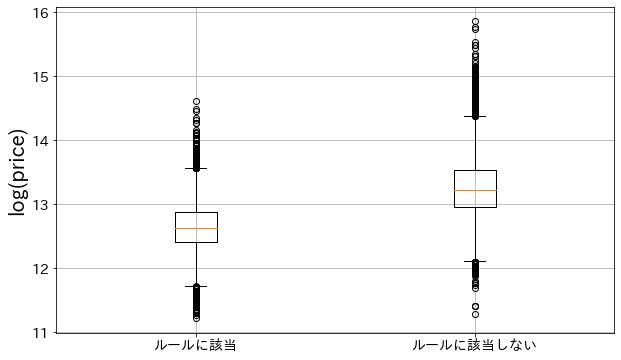
次に、sqft_living <= 3935.0 & lat <= 47.5314998626709 rule -8.271074e+04 0.377800 40101.257833 のルール項を検証します。係数が約 −8.3 万ドルとマイナスなので、このルールに該当するデータ(全体の約 38 %)の y(price)は低い傾向にあるはずです。次のコードは該当する家と該当しない家の log(y) を箱ひげ図で比べます。
| |
実行結果の読み方 #
散布図では sqft_above が大きいほど price が高い右上がりの帯が見え、線形項の係数が正であることと一致します。箱ひげ図では「sqft_living <= 3935 かつ lat <= 47.53」に当たる家の log(price) の中央値が、当たらない家より明らかに低く、係数 −8.3 万ドルの向きが実データで裏づけられました。ルールの support が 0.38 と大きいので、この 1 本だけで全体の 4 割近い家の価格を押し下げる方向に働いています。
まとめ #
RuleFit は、勾配ブースティングの木の経路を 0/1 のルール特徴量に変換し、元の特徴量と一緒に Lasso に入れて係数を付けるハイブリッド手法です。L1 正則化が max_rules=100 の候補から不要なルールを係数 0 で落とすので、残った get_rules() の表が「どの条件が価格を何ドル動かすか」の一覧になります。support が 0.001 のようなルールは少数の例外に合わせたものなので、散布図や箱ひげ図で実データと突き合わせてから使ってください。精度だけが目的なら ランダムフォレスト や勾配ブースティングをそのまま使う方が高く、RuleFit は「係数つきルールで説明したい」場面で選ぶモデルです。