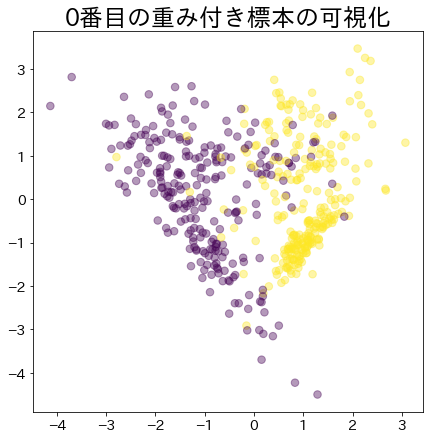
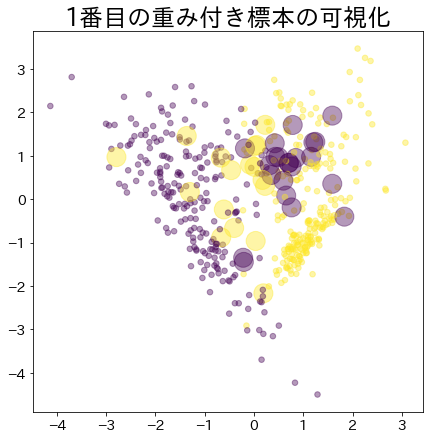
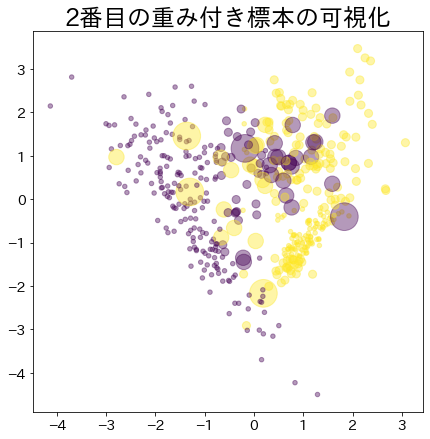
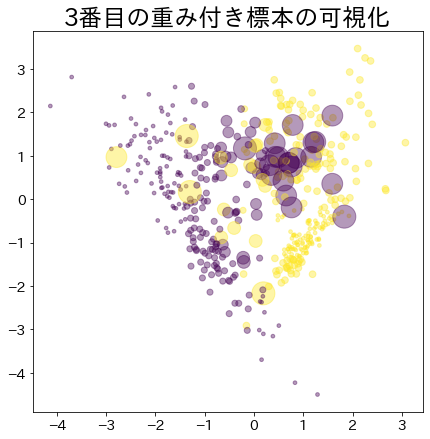
Ο AdaBoost λειτουργεί εστιάζοντας επανειλημμένα στα λάθη του προηγούμενου γύρου. Κάθε αδύναμος εκπαιδευτής είναι περιορισμένος, αλλά το σταθμισμένο σύνολο συσσωρεύει συμπληρωματικές διορθώσεις, παράγοντας έναν ισχυρό ταξινομητή από απλά στοιχεία.
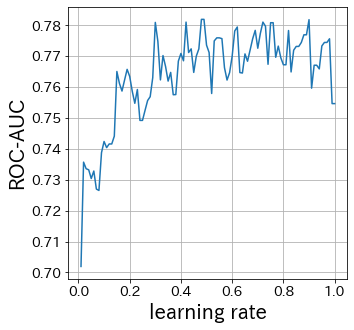
Όσο μικρότερο είναι το learning-rate, τόσο μικρότερο είναι το εύρος ενημερώσεων βαρών. Αντίθετα, αν είναι πολύ μεγάλο, η σύγκλιση μπορεί να μην επιτευχθεί.
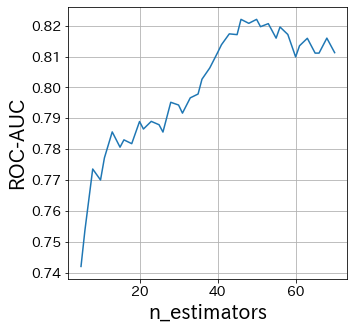
Το n_estimators καθορίζει τον αριθμό των αδύναμων εκπαιδευτών.
Κανονικά, δεν χρειάζεται να αυξήσετε ή να μειώσετε αυτή την παράμετρο.
Καθορίστε το n_estimators σε κάποιον μεγάλο αριθμό και στη συνέχεια ρυθμίστε τις άλλες παραμέτρους.
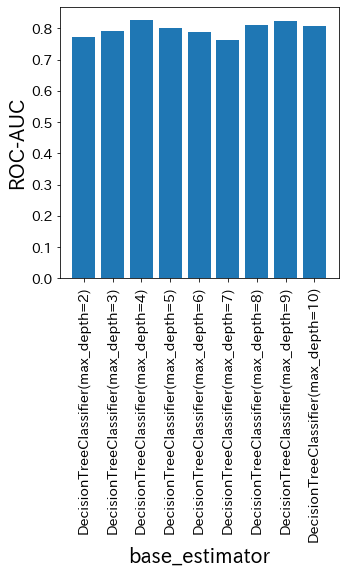
Η παράμετρος base_estimator καθορίζει τι χρησιμοποιείται ως αδύναμος εκπαιδευτής. Με άλλα λόγια, είναι μία από τις πιο σημαντικές παραμέτρους στον Adaboost.
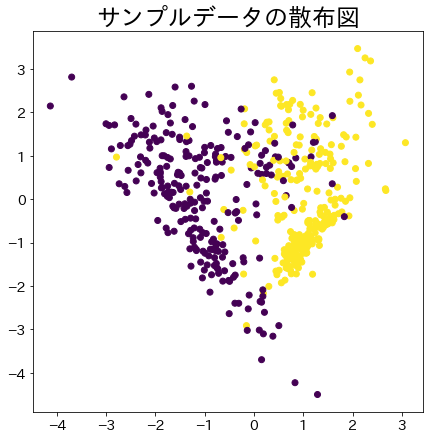
# ΣΗΜΕΙΩΣΗ: Μοντέλο που δημιουργήθηκε για τον έλεγχο του sample_weight που μεταβιβάζεται στο μοντέλο# Αυτός ο DummyClassifier δεν αλλάζει τις παραμέτρους του AdaboostclassDummyClassifier:def__init__(self):self.model=DecisionTreeClassifier(max_depth=3)self.n_classes_=2self.classes_=["A","B"]self.sample_weight=None## sample_weightdeffit(self,X,y,sample_weight=None):self.sample_weight=sample_weightself.model.fit(X,y,sample_weight=sample_weight)returnself.modeldefpredict(self,X,check_input=True):proba=self.model.predict(X)returnprobadefget_params(self,deep=False):return{}defset_params(self,deep=False):return{}n_samples=500X_2,y_2=make_classification(n_samples=n_samples,n_features=2,n_informative=2,n_redundant=0,n_repeated=0,random_state=117,n_clusters_per_class=2,)plt.figure(figsize=(7,7,))plt.title(f"Scatter plots of sample data")plt.scatter(X_2[:,0],X_2[:,1],c=y_2)plt.show()
clf=AdaBoostClassifier(n_estimators=4,random_state=0,algorithm="SAMME",base_estimator=DummyClassifier())clf.fit(X_2,y_2)fori,estimators_iinenumerate(clf.estimators_):plt.figure(figsize=(7,7,))plt.title(f"Visualization of the {i}-th weighted sample")plt.scatter(X_2[:,0],X_2[:,1],marker="o",c=y_2,alpha=0.4,s=estimators_i.sample_weight*n_samples**1.65,)plt.show()