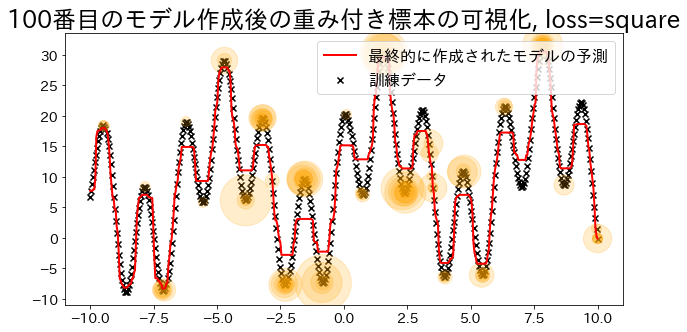
Η παλινδρόμηση AdaBoost τονίζει επανειλημμένα τις περιοχές όπου οι τρέχοντες προβλεπτές αποδίδουν χαμηλά. Ανακατανέμοντας την προσοχή σε δείγματα με υψηλό σφάλμα, το σύνολο αποτυπώνει μη γραμμικά μοτίβα υπολοίπων που μεμονωμένοι εκπαιδευτές συχνά αγνοούν.
# ΣΗΜΕΙΩΣΗ: Αυτό το μοντέλο χρησιμεύει για τον έλεγχο του sample_weight του μοντέλουclassDummyRegressor:def__init__(self):self.model=DecisionTreeRegressor(max_depth=5)self.error_vector=Noneself.X_for_plot=Noneself.y_for_plot=Nonedeffit(self,X,y):self.model.fit(X,y)y_pred=self.model.predict(X)# Τα βάρη υπολογίζονται με βάση το σφάλμα παλινδρόμησης.# https://github.com/scikit-learn/scikit-learn/blob/main/sklearn/ensemble/_weight_boosting.py#L1130self.error_vector=np.abs(y_pred-y)self.X_for_plot=X.copy()self.y_for_plot=y.copy()returnself.modeldefpredict(self,X,check_input=True):returnself.model.predict(X)defget_params(self,deep=False):return{}defset_params(self,deep=False):return{}
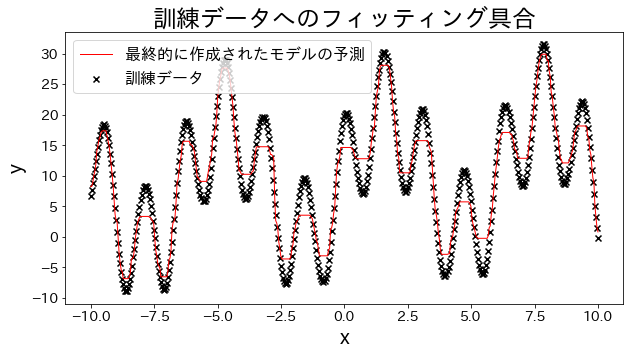
Προσαρμογή μοντέλων παλινδρόμησης στα δεδομένα εκπαίδευσης
#
# training datasetX=np.linspace(-10,10,500)[:,np.newaxis]y=(np.sin(X).ravel()+np.cos(4*X).ravel())*10+10+np.linspace(-2,2,500)## train Adaboost regressorreg=AdaBoostRegressor(DummyRegressor(),n_estimators=100,random_state=100,loss="linear",learning_rate=0.8,)reg.fit(X,y)y_pred=reg.predict(X)# Έλεγχος της προσαρμογής στα δεδομένα εκπαίδευσης.plt.figure(figsize=(10,5))plt.scatter(X,y,c="k",marker="x",label="訓練データ")plt.plot(X,y_pred,c="r",label="prediction",linewidth=1)plt.xlabel("x")plt.ylabel("y")plt.legend()plt.show()
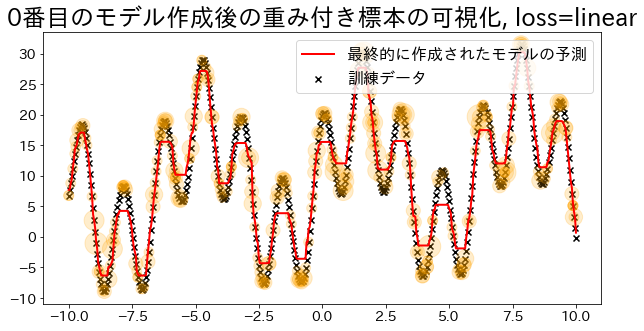
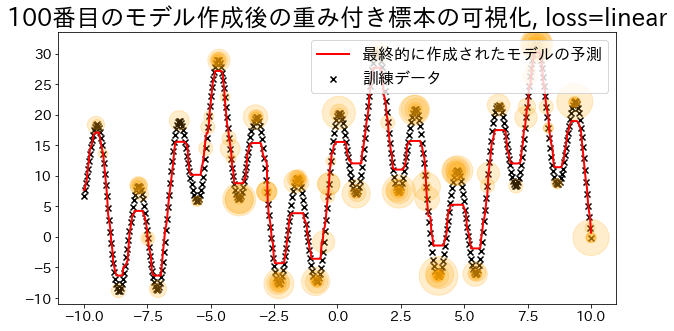
Ο Adaboost καθορίζει τα βάρη με βάση τα σφάλματα της παλινδρόμησης. Οπτικοποιήστε το μέγεθος των βαρών όταν ορίζεται ως ’linear’. Παρατηρήστε πώς τα δεδομένα με αυξημένα βάρη έχουν μεγαλύτερη πιθανότητα να επιλεγούν κατά τη διάρκεια της εκπαίδευσης.
loss{’linear’, ‘square’, ’exponential’}, default=‘linear’
The loss function to use when updating the weights after each boosting iteration.
defvisualize_weight(reg,X,y,y_pred):"""Function for plotting the value (number of times sampled) corresponding to the weights of the sample
Parameters
----------
reg : sklearn.ensemble._weight_boosting
boosting model
X : numpy.ndarray
training dataset
y : numpy.ndarray
target
y_pred:
prediction
"""assertreg.estimators_isnotNone,"len(reg.estimators_) > 0"fori,estimators_iinenumerate(reg.estimators_):ifi%100==0:# Μέτρηση πόσες φορές εμφανίζονται τα δεδομένα στο σύνολο που χρησιμοποιήθηκε για τη δημιουργία του i-οστού μοντέλουweight_dict={xi:0forxiinX.ravel()}forxiinestimators_i.X_for_plot.ravel():weight_dict[xi]+=1# Σχεδιάστε τον αριθμό εμφανίσεων ως πορτοκαλί κύκλους στο γράφημα (όσο μεγαλύτερος ο αριθμός, τόσο μεγαλύτερος ο κύκλος)weight_x_sorted=sorted(weight_dict.items(),key=lambdax:x[0])weight_vec=np.array([s*100forxi,sinweight_x_sorted])# plot graphplt.figure(figsize=(10,5))plt.title(f"Visualization of the weighted sample after creating the {i}-th model, loss={reg.loss}")plt.scatter(X,y,c="k",marker="x",label="training data")plt.scatter(estimators_i.X_for_plot,estimators_i.y_for_plot,marker="o",alpha=0.2,c="orange",s=weight_vec,)plt.plot(X,y_pred,c="r",label="prediction",linewidth=2)plt.legend(loc="upper right")plt.show()## Δημιουργία μοντέλου παλινδρόμησης με loss="linear"reg=AdaBoostRegressor(DummyRegressor(),n_estimators=101,random_state=100,loss="linear",learning_rate=1,)reg.fit(X,y)y_pred=reg.predict(X)visualize_weight(reg,X,y,y_pred)
1
2
3
4
5
6
7
8
9
10
11
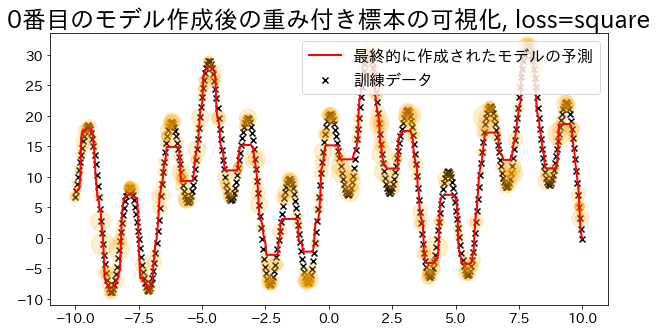
## Δημιουργία μοντέλου παλινδρόμησης με loss="square"reg=AdaBoostRegressor(DummyRegressor(),n_estimators=101,random_state=100,loss="square",learning_rate=1,)reg.fit(X,y)y_pred=reg.predict(X)visualize_weight(reg,X,y,y_pred)