Το Gradient Boosting ξεκινά με μια πρόχειρη πρόβλεψη, και στη συνέχεια προσθέτει επανειλημμένα μικρά δέντρα που διορθώνουν αυτά που το τρέχον μοντέλο εξακολουθεί να κάνει λάθος. Πολλές μικρές, στοχευμένες διορθώσεις συσσωρεύονται σε έναν ευέλικτο προβλεπτή.
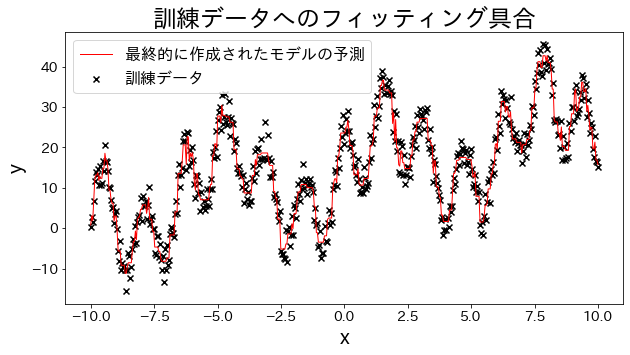
# training datasetX=np.linspace(-10,10,500)[:,np.newaxis]noise=np.random.rand(X.shape[0])*10# targety=((np.sin(X).ravel()+np.cos(4*X).ravel())*10+10+np.linspace(-10,10,500)+noise)# train gradient boostingreg=GradientBoostingRegressor(n_estimators=50,learning_rate=0.5,)reg.fit(X,y)y_pred=reg.predict(X)# Έλεγχος προσαρμογής στα δεδομένα εκπαίδευσηςplt.figure(figsize=(10,5))plt.scatter(X,y,c="k",marker="x",label="training data")plt.plot(X,y_pred,c="r",label="Predictions for the final created model",linewidth=1)plt.xlabel("x")plt.ylabel("y")plt.title("Degree of fitting to training dataset")plt.legend()plt.show()
Επίδραση της συνάρτησης απώλειας στα αποτελέσματα
#
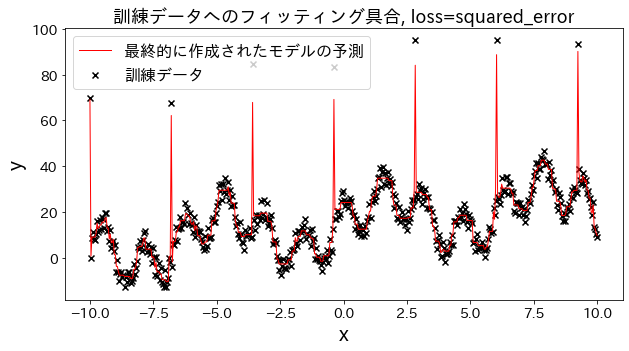
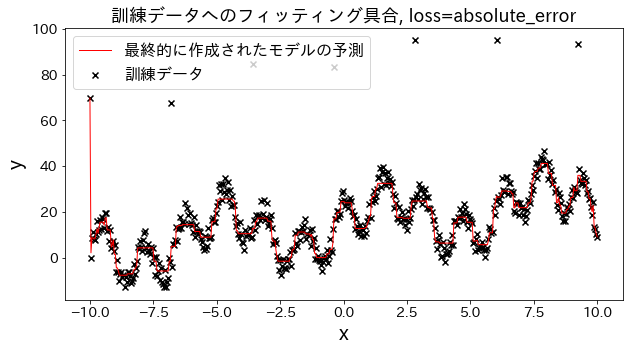
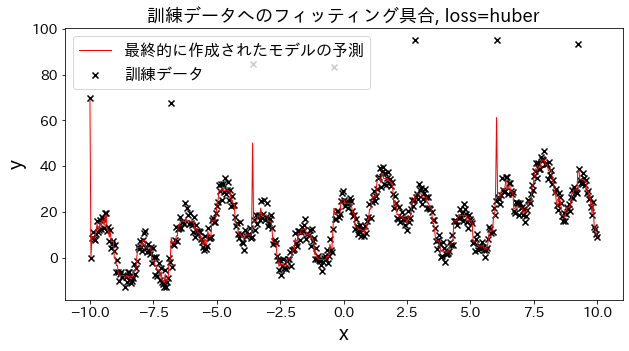
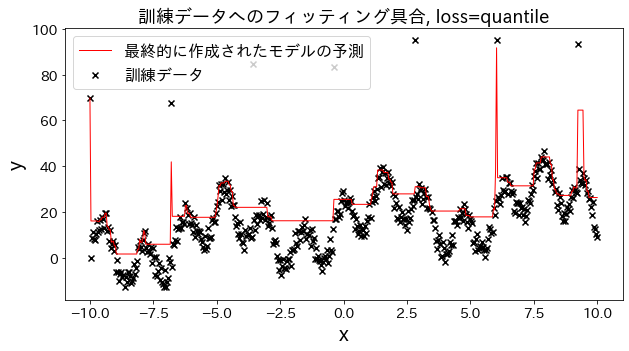
Ελέγξτε πώς αλλάζει η προσαρμογή στα δεδομένα εκπαίδευσης όταν η απώλεια αλλάζει σε [“squared_error”, “absolute_error”, “huber”, “quantile”]. Αναμένεται ότι τα “absolute_error” και “huber” δεν θα προβλέψουν τις ακραίες τιμές, δεδομένου ότι η ποινή για ακραίες τιμές δεν είναι τόσο μεγάλη όσο το τετραγωνικό σφάλμα.
# training dataX=np.linspace(-10,10,500)[:,np.newaxis]# prepare outliersnoise=np.random.rand(X.shape[0])*10fori,niinenumerate(noise):ifi%80==0:noise[i]=70+np.random.randint(-10,10)# targety=((np.sin(X).ravel()+np.cos(4*X).ravel())*10+10+np.linspace(-10,10,500)+noise)forlossin["squared_error","absolute_error","huber","quantile"]:# train gradient boostingreg=GradientBoostingRegressor(n_estimators=50,learning_rate=0.5,loss=loss,)reg.fit(X,y)y_pred=reg.predict(X)# Έλεγχος προσαρμογής στα δεδομένα εκπαίδευσης.plt.figure(figsize=(10,5))plt.scatter(X,y,c="k",marker="x",label="training dataset")plt.plot(X,y_pred,c="r",label="Predictions for the final created model",linewidth=1)plt.xlabel("x")plt.ylabel("y")plt.title(f"Degree of fitting to training data, loss={loss}",fontsize=18)plt.legend()plt.show()