Αντί να επιλέγει ένα καλύτερο μοντέλο, το stacking μαθαίνει ένα μοντέλο δεύτερου επιπέδου που αποφασίζει πότε πρέπει να εμπιστευτεί κάθε βασικό μοντέλο. Λειτουργεί καλά όταν οι βασικοί εκπαιδευτές κάνουν διαφορετικά είδη σφαλμάτων.
# Δημιουργία δεδομένων με 20 χαρακτηριστικάn_features=20X,y=make_classification(n_samples=2500,n_features=n_features,n_informative=10,n_classes=2,n_redundant=0,n_clusters_per_class=4,random_state=777,)X_train,X_test,y_train,y_test=train_test_split(X,y,test_size=0.33,random_state=777)
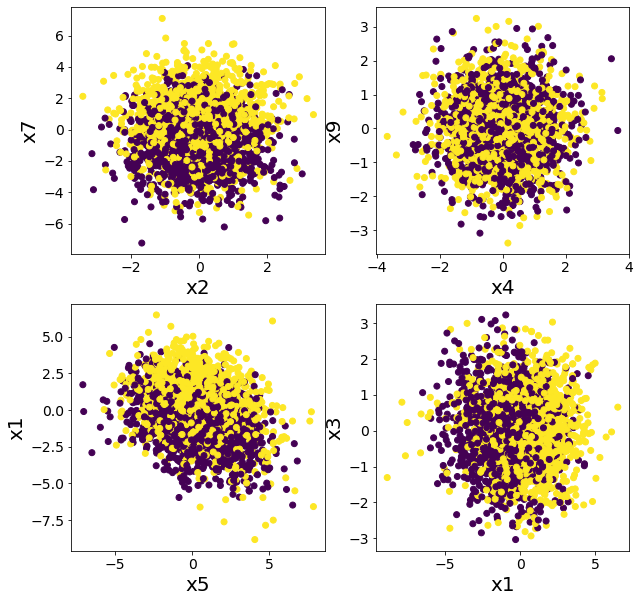
Σχεδίαση δεδομένων ως προς πολλαπλά χαρακτηριστικά
#
Επιβεβαιώστε ότι δεν φαίνεται να είναι ταξινομήσιμα με απλούς κανόνες.
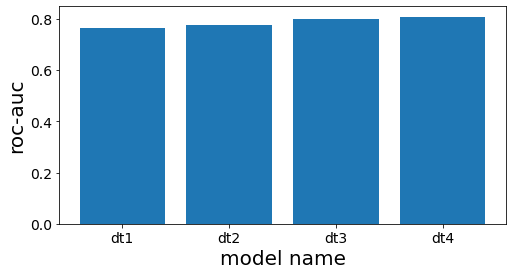
# Μοντέλα που χρησιμοποιούνται στον βασικό εκπαιδευτήestimators=[("dt1",DecisionTreeClassifier(max_depth=3,random_state=777)),("dt2",DecisionTreeClassifier(max_depth=4,random_state=777)),("dt3",DecisionTreeClassifier(max_depth=5,random_state=777)),("dt4",DecisionTreeClassifier(max_depth=6,random_state=777)),]# Αριθμός μοντέλων στον βασικό εκπαιδευτήn_estimators=len(estimators)# Μοντέλο συγκέντρωσηςfinal_estimator=DecisionTreeClassifier(max_depth=3,random_state=777)# Εκπαίδευση βασικού εκπαιδευτή και μοντέλου συγκέντρωσηςclf=StackingClassifier(estimators=estimators,final_estimator=final_estimator)clf.fit(X_train,y_train)# Αξιολόγησηy_pred=clf.predict(X_test)clf_score=roc_auc_score(y_test,y_pred)print("ROC-AUC")print(f"Decision Tree Stacking={clf_score}, Random Forest={rf_score}")
ROC-AUC
Decision Tree Stacking=0.7359716965608031, Random Forest=0.855797033310609
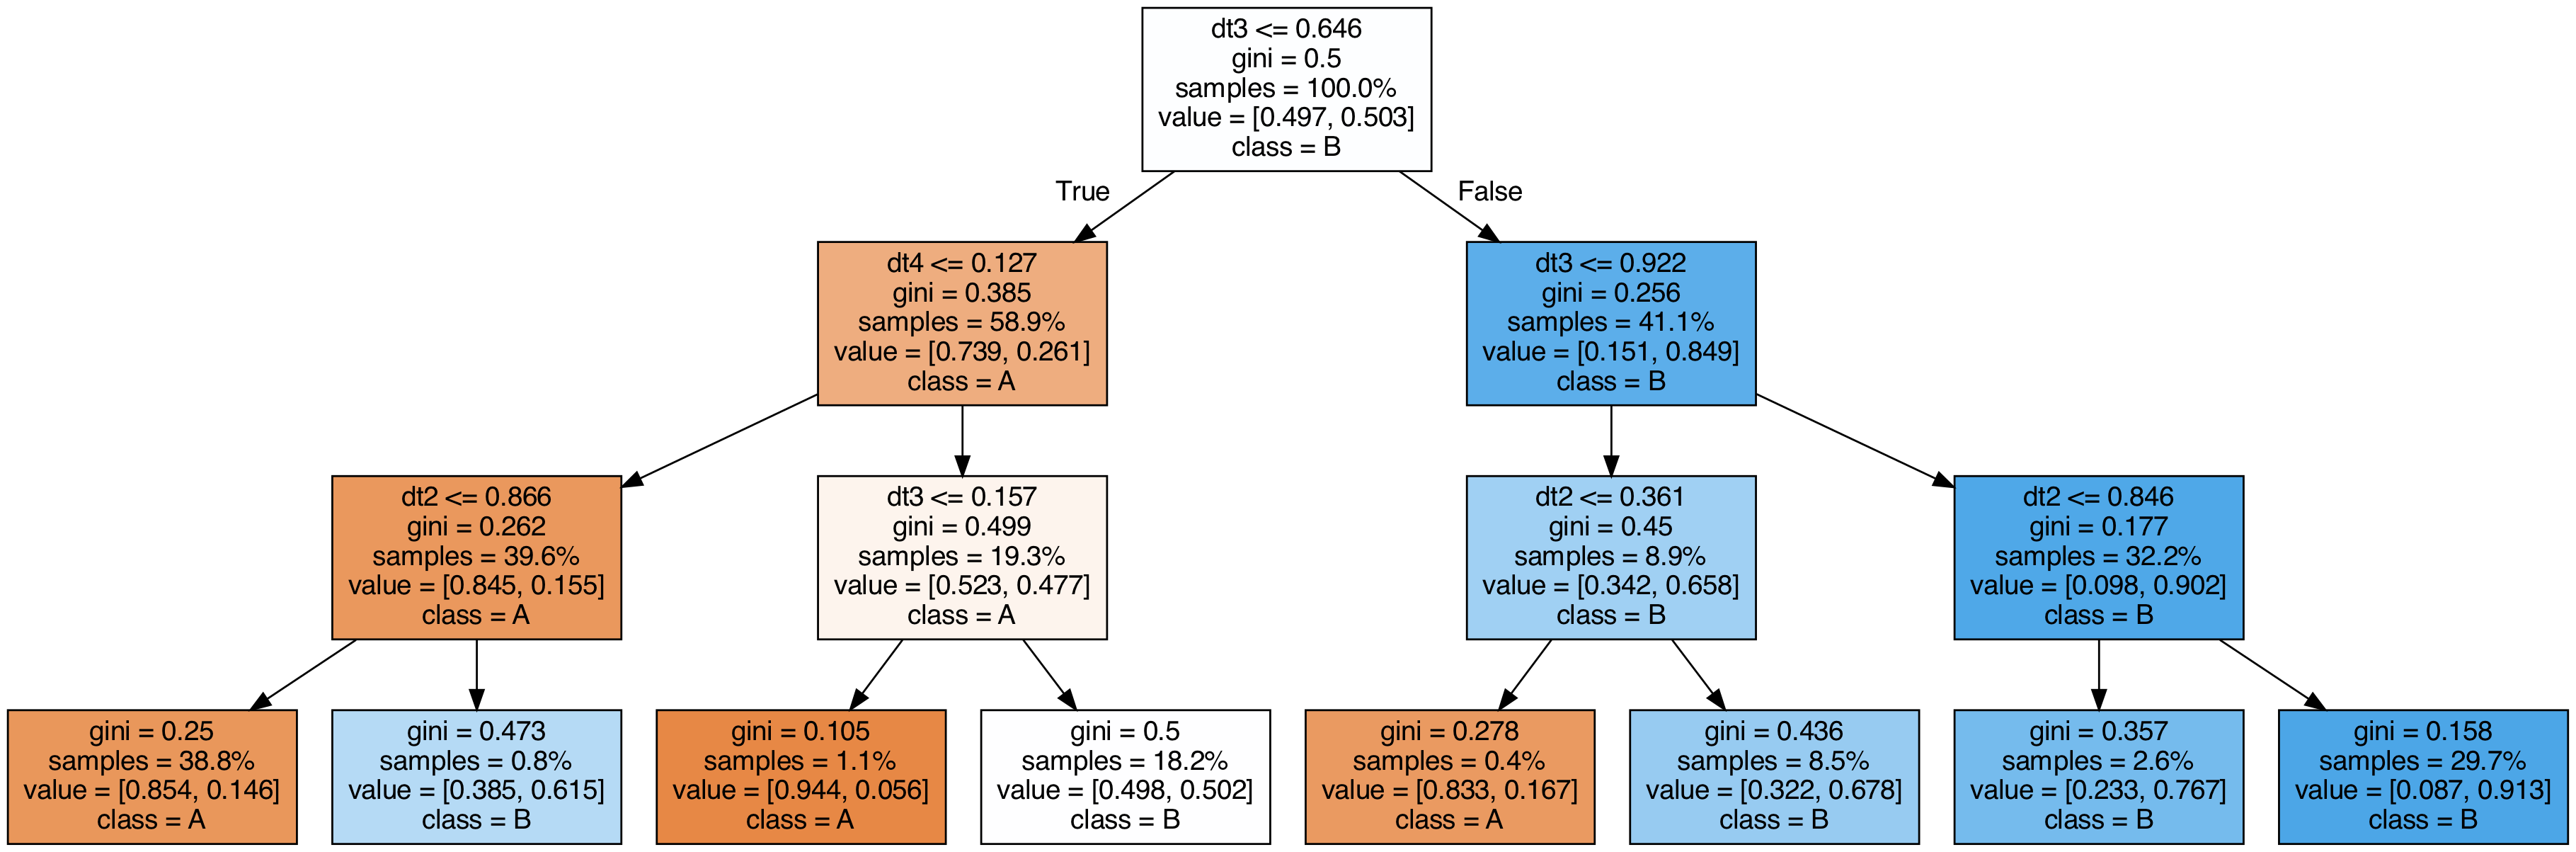
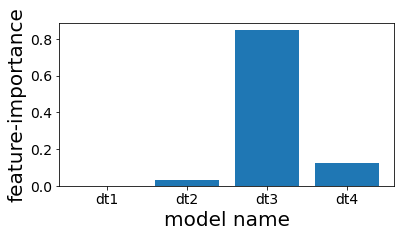
Οπτικοποίηση δέντρων που χρησιμοποιούνται στο stacking
#