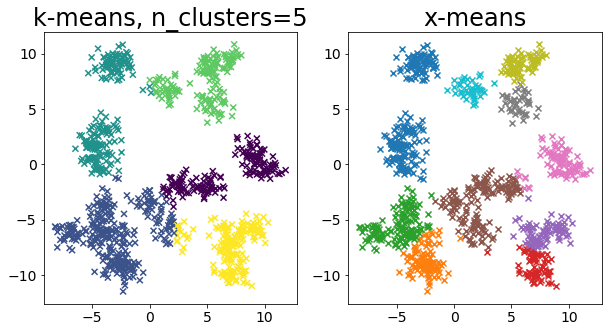
X-means aplica una estrategia de dividir y validar: comienza con pocos clústeres y solo divide cuando el criterio estadístico mejora. Así reduce la exploración manual de k sin perder control sobre la complejidad.
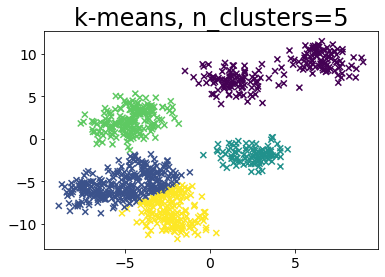
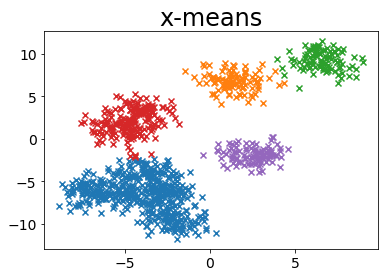
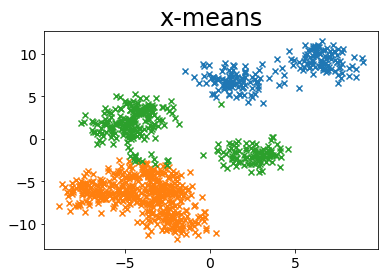
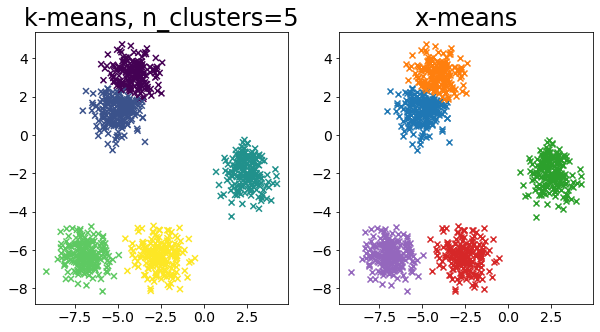
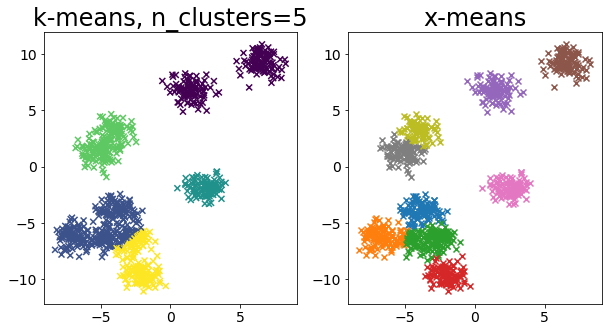
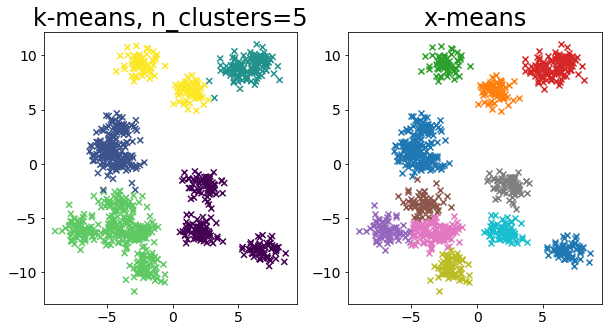
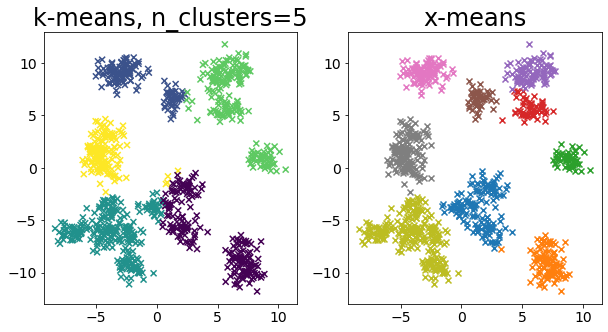
X-means es un tipo de algoritmo de agrupamiento que determina automáticamente el número de clústeres a medida que avanza el proceso de agrupamiento. Esta página compara los resultados de k-means++ y X-means.
defplot_by_kmeans(X,k=5):y_pred=KMeans(n_clusters=k,random_state=random_state,init="random").fit_predict(X)plt.scatter(X[:,0],X[:,1],c=y_pred,marker="x")plt.title(f"k-means, n_clusters={k}")# Crear datos de muestran_samples=1000random_state=117117X,_=make_blobs(n_samples=n_samples,random_state=random_state,cluster_std=1,centers=10)# Ejecutar k-means++.plot_by_kmeans(X)
Ejecutar sin especificar el número de clústeres en X-means
#
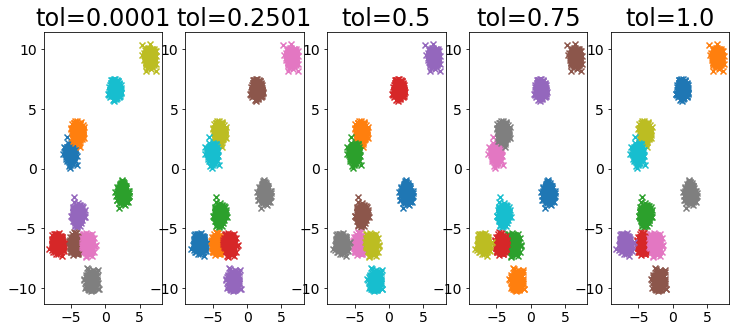
frompyclustering.cluster.xmeansimportxmeansfrompyclustering.cluster.center_initializerimportkmeans_plusplus_initializerBAYESIAN_INFORMATION_CRITERION=0MINIMUM_NOISELESS_DESCRIPTION_LENGTH=1defplot_by_xmeans(X,c_min=3,c_max=10,criterion=BAYESIAN_INFORMATION_CRITERION,tolerance=0.025):initial_centers=kmeans_plusplus_initializer(X,c_min).initialize()xmeans_instance=xmeans(X,initial_centers,c_max,criterion=criterion,tolerance=tolerance)xmeans_instance.process()# Crear datos para las parcelasclusters=xmeans_instance.get_clusters()n_samples=X.shape[0]c=[]fori,cluster_iinenumerate(clusters):X_ci=X[cluster_i]color_ci=[ifor_incluster_i]plt.scatter(X_ci[:,0],X_ci[:,1],marker="x")plt.title("x-means")# Ejecutar x-meansplot_by_xmeans(X,c_min=3,c_max=10,criterion=BAYESIAN_INFORMATION_CRITERION)