03.3.1 高校生向け
Accuracy(高校生向け)
こんな場面を想像してみよう #
スマホの迷惑メールフィルタを自作したとします。テスト用に 100 通のメールを用意し、そのうち 20 通が本物の迷惑メールです。判定結果を 4 つのマスに数えると次の表になりました。
| 判定:迷惑 | 判定:普通 | 合計 | |
|---|---|---|---|
| 実際:迷惑 | 16 | 4 | 20 |
| 実際:普通 | 5 | 75 | 80 |
このフィルタは何点でしょうか。いちばん素直な答え方が正解率です。当たりは「迷惑を迷惑と言えた 16 通」と「普通を普通と言えた 75 通」なので、
$$ \text{正解率} = \frac{16 + 75}{100} = 0.91 $$です。表の左上から右下への対角線が当たり、それ以外のマス(4 と 5)が外れ、と覚えると見やすくなります。
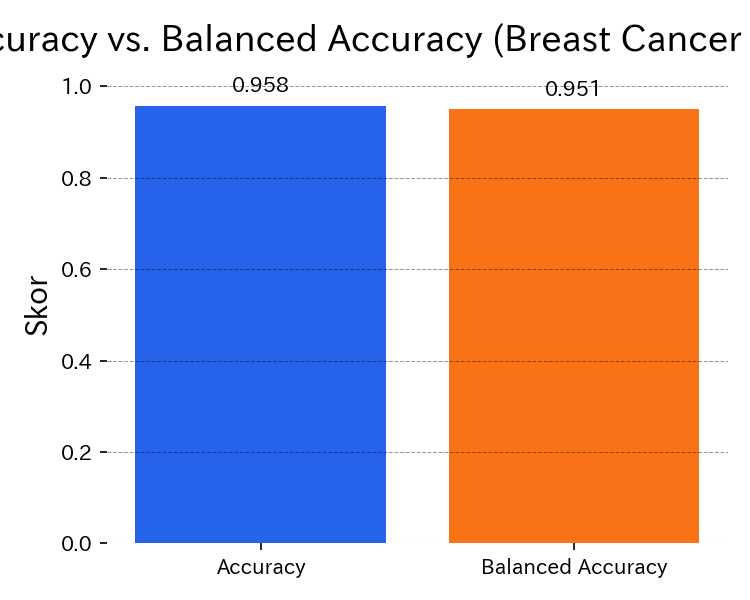
上の図は、乳がん診断のデータで学習したモデルの正解率(左)と、「陽性だけの正解率」と「陰性だけの正解率」を平均したバランス正解率(右)です。このデータは陽性と陰性の数が 4 : 6 くらいであまり偏っていないので、2 本はほぼ同じ高さです。陽性が全体の 1 % しかないデータなら、左の棒は高いままでも右の棒はがくんと下がります。
仕組み:線を引いて、当たりを数える #
まず、モデルは各メールに「迷惑らしさ」0〜1 の点数をつけます。数直線の上に 100 個の点が並ぶと想像してください。本物の迷惑メールは右寄り、普通のメールは左寄りですが、混ざる部分もあります。次に、しきい値(たとえば 0.5)の位置に縦線を引き、線より右を「迷惑」判定、左を「普通」判定とします。答え合わせでは、線の右側にいる本物の迷惑メールと、左側にいる普通のメールが「当たり」で、右側に紛れ込んだ普通のメール(誤報)と左側に残った迷惑メール(見逃し)が「外れ」です。当たりの個数 ÷ 100 が正解率になります。
最後に線を動かしてみます。線を右へずらす(厳しくする)と、普通のメールが左へ移って誤報が減る一方、迷惑メールも左へ移って見逃しが増えます。正解率は「当たりに変わった点と外れに変わった点の差」だけ動きます。線を右端まで動かせば全員「普通」判定になり、正解率は普通メールの割合 80 % に一致します。
動かして見てみよう #
下の図で「再生」を押すと、説明した手順が 1 つずつ進みます。手順ごとの説明は図の下に出ます。
気をつけたいこと #
最初の注意点は、偏ったデータで数字がうそをつくことです。ある病気の人が 1,000 人に 10 人なら、全員を「健康」と答えても正解率 99 % ですが、病気の人は 1 人も見つけていません。二つ目は、2 種類の間違いの重さがちがうことです。迷惑メールの見逃しは少し不便なだけですが、大事なメールを迷惑扱いする誤報は困ります。それでも正解率はどちらも「外れ 1 件」として同じ重さで数えます。三つ目は、100 % に近すぎたら疑うことで、テスト用のメールを学習にも使っていた、答えがメールの中に書いてあった、といった事故でも正解率は跳ね上がります。
やってみよう #
最初の課題は、上のフィルタでしきい値を上げたとき、「迷惑」判定が 21 通から 15 通に減り、内訳が本物 13 通・普通 2 通になった場合の正解率を計算し、元の 0.91 と比べて何が変わり何が変わらなかったかを言葉にすることです。二つ目は、身の回りで「ほとんどが片方」の 2 択データを 1 つ見つけ(例:1 か月のうち雨の日と晴れの日)、「全部多数派」と答えるモデルの正解率を出すことです。三つ目は、正解率が 95 % なのに「使いものにならない」モデルの例を 1 つ考え、なぜ困るのかを説明することです。
つぎに読む #
数式と Python での実装、バランス正解率との比較は 標準版の正解率(Accuracy) で扱っています。当たり外れを 4 マスに整理する表は 混同行列(高校生向け)、見逃しと誤報を別々に測る方法は 適合率・再現率(高校生向け) へ進んでください。数式なしで読むなら 正解率(中学生向け) があり、16 種類の指標の一覧は 分類の評価指標 にあります。