03.3.16 高校生向け
混同行列(高校生向け)
こんな場面を想像してみよう #
「正解率 95% のモデルを作った」と友だちが言いました。このモデル、どんな間違いをしているか分かるでしょうか。実は 1 つの数字からでは分かりません。見逃しばかりなのか、誤報ばかりなのか、両方少しずつなのか、95 % という数字は何も教えてくれません。それを見るための表が混同行列です。
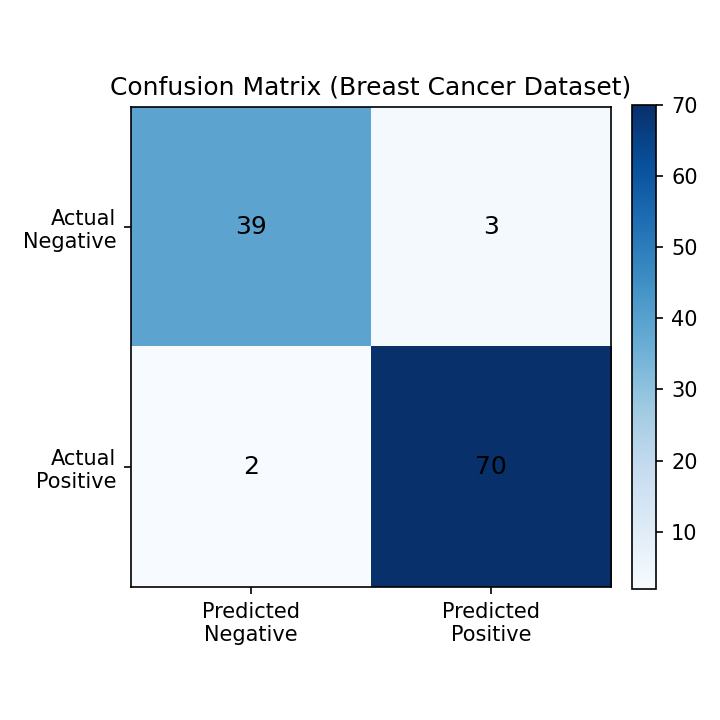
上の図は 114 人分の検査データで作った混同行列です。2 つの行が実際(上段が陰性、下段が陽性)、2 つの列が予測(左列が陰性、右列が陽性)を表します。
| 予測:陰性 | 予測:陽性 | 行の合計 | |
|---|---|---|---|
| 実際:陰性 | 39(真陰性 TN) | 3(偽陽性 FP) | 42 |
| 実際:陽性 | 2(偽陰性 FN) | 70(真陽性 TP) | 72 |
左上から右下への対角線(39 と 70)が当たりです。右上の 3 は「陰性なのに陽性と言った」誤報、左下の 2 は「陽性なのに陰性と言った」見逃しです。「正解率 95%」の中身は、対角線の 109 件 ÷ 全体の 114 件 ≒ 0.956 で、間違いは誤報 3 件と見逃し 2 件、ということが表から読めます。
仕組み:点を 4 つのマスに振り分ける #
まず、モデルは 1 人ずつに「陽性らしさ」の点数(0〜1)をつけます。数直線の上に 114 個の点が並ぶと想像してください。次に、しきい値の位置に線を引き、右なら「陽性」、左なら「陰性」と判定します。そして 1 人ずつ、実際のラベルと判定の組み合わせで 4 マスのどれか 1 つに入れていきます。全員がちょうど 1 マスに入るので、4 マスの合計は必ず全件数の 114 になります。
ここで線を動かしてみます。しきい値を下げると「陽性」判定が増え、件数が左列から右列へ移ります。下段では見逃し FN が真陽性 TP に変わり(うれしい)、上段では真陰性 TN が誤報 FP に変わります(うれしくない)。上段 42 人・下段 72 人という行の合計は変わりません。実際の人数は線とは無関係だからです。
最後に割り算で指標を出します。正解率は対角線 ÷ 全体 = 109/114 ≒ 0.956 です。再現率は TP ÷ 下段の合計 = 70/72 ≒ 0.972、適合率は TP ÷ 右列の合計 = 70/73 ≒ 0.959。特異度は TN ÷ 上段の合計 = 39/42 ≒ 0.929 になります。「どの行・どの列で割るか」を表で指させれば、4 つの指標の意味は忘れません。
動かして見てみよう #
下の図で「再生」を押すと、説明した手順が 1 つずつ進みます。手順ごとの説明は図の下に出ます。
気をつけたいこと #
最初の注意点は、行と列の向きはソフトによって逆なことです。この本では行が実際・列が予測ですが、逆に並べる流儀もあるので、表を見たら最初に「行は何か」を確認します。二つ目は、件数だけでは偏りが見えないことで、陰性 1,000 人・陽性 10 人のデータでは、見逃し 5 件は「陽性の半分」なのに、表の中では小さく見えます。そこで行ごとに割合、つまり 5/10 = 50 % のように行の合計で割った値も出して読みます。三つ目は、多クラスでも考え方は同じで、3 クラスなら 3 行 3 列になることです。対角線が当たりで、対角線から外れたマスが「どのクラスをどのクラスと間違えたか」を教えてくれます。
やってみよう #
最初の課題は、上の表でしきい値を下げたら見逃しが 2 → 0 件、誤報が 3 → 8 件になったとして、4 マスを書き直し、正解率・再現率・適合率・特異度を計算することです(行の合計 42 と 72 は変わりません)。二つ目は、天気予報の「降る/降らない」と実際の天気を 2 週間記録して混同行列を作り、見逃し(降らないと言ったのに降った)と誤報のどちらが多かったかを数えることです。三つ目は、晴れ・くもり・雨の 3 クラスの混同行列を自分で作り、「くもりと雨を間違えやすい」という結果が 9 マスのどこに現れるかを示すことです。
つぎに読む #
Python での描き方、正規化(割合表示)、多クラスへの拡張は 標準版の混同行列 で扱っています。4 マスから出す指標をくわしく見るには 正解率(高校生向け)、適合率・再現率(高校生向け)、感度・特異度(高校生向け) へ進んでください。数式なしで読むなら 混同行列(中学生向け) があり、16 種類の指標の一覧は 分類の評価指標 にあります。