03.3.8 高校生向け
F1 スコア(高校生向け)
こんな場面を想像してみよう #
適合率・再現率(高校生向け) で使った金属探知機で、感度の設定を 3 とおり試しました。どの設定がいちばん「よい腕前」でしょうか。
| 設定 | 適合率 P | 再現率 R | ふつうの平均 (P+R)/2 |
|---|---|---|---|
| A(感度 低) | 0.90 | 0.45 | 0.675 |
| B(感度 中) | 0.60 | 0.75 | 0.675 |
| C(感度 高) | 0.475 | 0.95 | 0.7125 |
ふつうの平均では A と B が 0.675 で同点、C が 0.7125 でいちばんです。でも C は「鳴った場所の半分以上がはずれ」で、掘ってばかりの設定です。もっと極端に、1 か所だけ鳴って本物だった設定 D(P = 1.0、R = 0.05)を考えると、ふつうの平均は 0.525 で B より下なのにそれほど悪く見えません。「片方だけ良い」を高く評価しすぎるのが、ふつうの平均の弱点です。
仕組み:低い方に引っぱられる平均 #
まず、逆数にして平均します。F1 は P と R の調和平均、つまり逆数の平均の逆数で、
$$ F_1 = \frac{2}{\dfrac{1}{P} + \dfrac{1}{R}} = \frac{2PR}{P + R} $$と計算します。P と R のうち小さい方(たとえば 0.45)の逆数が大きくなって平均を支配するので、結果は小さい方に近づきます。
次に、3 つの設定を計算し直します。A は \(2 \times 0.90 \times 0.45 / 1.35 = 0.60\)、B は \(2 \times 0.60 \times 0.75 / 1.35 \approx 0.67\)、C は \(2 \times 0.475 \times 0.95 / 1.425 \approx 0.63\)。順位は B > C > A に変わり、バランスのよい B が選ばれます。極端な D は \(2 \times 1.0 \times 0.05 / 1.05 \approx 0.095\) と、きちんと低い点になります。
最後に、しきい値を 0 から動かしてみます。しきい値 0 では全部を陽性と言うので R = 1、P は陽性の割合(下の図のデータでは約 0.05)で、F1 は約 0.1 です。線を右へ動かすと誤報が減って P が上がり、R は 1 から少しずつ下がります。F1 はしばらく上がり続け、山の頂上を迎えます。線を右端まで動かして陽性判定が 1 件もなくなると R = 0 となり、F1 は 0 に落ちます。
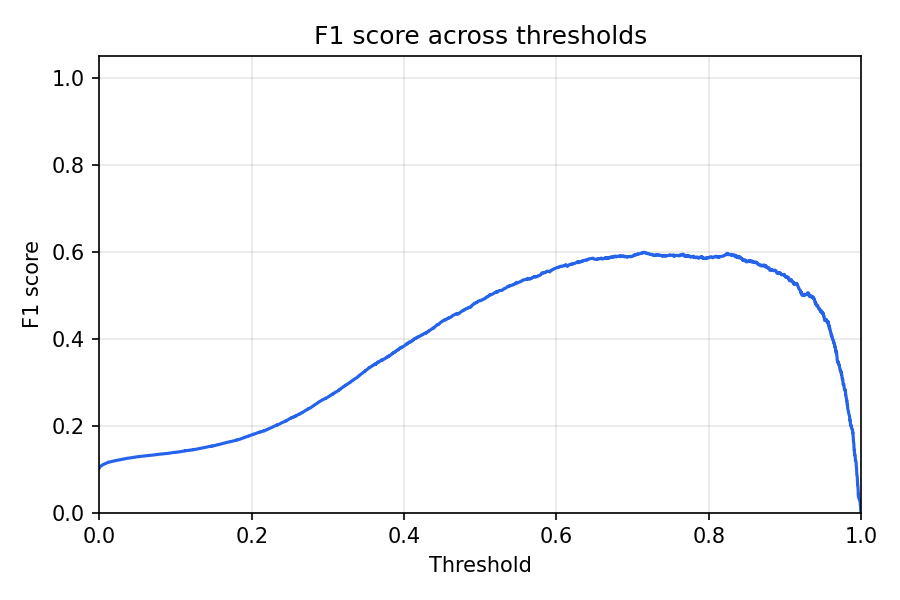
上の図は、陽性が 5% のデータで実際にしきい値を動かした結果です。左端の約 0.1 がしきい値 0 の値、右端の 0 がしきい値 1 の値になっています。山の頂上(この例では 0.7 付近)が、誤報と見逃しのバランスがいちばんよい線の位置です。
動かして見てみよう #
下の図で「再生」を押すと、説明した手順が 1 つずつ進みます。手順ごとの説明は図の下に出ます。
気をつけたいこと #
最初の注意点は、F1 は真陰性を見ていないことです。式に出てくるのは真陽性・誤報・見逃しだけで、「陰性を陰性と当てた数」は入っていません。陰性を正しく当てることも大事なら、正解率や特異度も F1 の横に並べます。二つ目は、見逃しの方が痛いなら重みを変えることで、再現率を 2 倍重く見る F2、適合率を重く見る F0.5 という仲間があります。F1 は「どちらも同じくらい大事」という前提の指標です。三つ目は、F1 が最大の線が正解とは限らないことです。「見逃しは 1 割まで」といった現場の制約があるなら、その条件を満たす線を優先し、F1 は比較の参考にとどめます。
やってみよう #
最初の課題は、適合率 0.80・再現率 0.20 のモデルについて、ふつうの平均と F1 を計算し、どちらがこのモデルの弱点を正直に表しているか説明することです。二つ目は、上の図の山の頂上(0.7 付近)より少し右のしきい値を選ぶと、適合率 P と再現率 R のどちらが上がりどちらが下がるかを予想し、その理由を線の動きで説明することです。三つ目は、P と R がどちらも 0.7 のときの F1 を計算してふつうの平均と比べ、2 つが等しくなる理由を考えることです。
つぎに読む #
Fβ スコアの式、しきい値ごとの F1 を計算する Python コード、多クラスでの平均のとり方は 標準版の F1 スコア で扱っています。土台になる 2 つの指標は 適合率・再現率(高校生向け)、陰性側も含めた見方は 感度・特異度(高校生向け) へ進んでください。16 種類の指標の一覧は 分類の評価指標 にまとめています。