03.3.5
MCC
matthews_corrcoef(y_test, y_pred) の値を読み、閾値ごとの MCC を描いて最大点を動作点の候補にできるようになります。混同行列 の TP・FP・FN・TN の 4 マスが何を数えているかを先に押さえておくと、MCC の式が「4 マスの相関」だとそのまま読めます。
直感:4 マス全部を使った相関係数 #
1,000 件のうち不正取引が 50 件のデータで、「全部正常」と答えるモデルを考えます。Accuracy は 950/1000 = 0.95 と高く見えますが、不正を 1 件も捕まえていません。MCC はこの予測を 0 と採点します。理由は、MCC が「予測が 1 か 0 か」と「正解が 1 か 0 か」の 2 つの列をそのまま相関係数にかけているからで、予測列が全部 0 なら分散がなく、どんな正解列とも相関は 0 です。TP・TN・FP・FN のどれか 1 つが極端に少ないだけでも分母が小さくなって値が引きずられるため、4 マスをバランスよく当てないと 1 に近づけません。
式で書くと何を測っているか #
二値分類において MCC は次式で表されます。
$$ \mathrm{MCC} = \frac{TP \cdot TN - FP \cdot FN}{\sqrt{(TP + FP)(TP + FN)(TN + FP)(TN + FN)}} $$分子の \(TP \cdot TN\) は「両クラスを正しく当てた量」、\(FP \cdot FN\) は「両方向に間違えた量」で、差が正なら予測は正解と同じ向きに動いています。分母は予測の陽性数・正解の陽性数・予測の陰性数・正解の陰性数の積の平方根で、相関係数の「標準偏差で割る」操作に対応します。値は 1 が完全に正しい分類、0 がランダム予測と同程度、−1 が完全に逆の予測で、多クラスでもクラスごとの混同行列から同じ考え方で拡張され、matthews_corrcoef は多クラスのラベルをそのまま受け付けます。
何が起きているか(ステップで見る) #
コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。
見るポイント:閾値を動かすと TP・FP・FN が同時に変わる。どれを重視するかで最適な閾値は変わる。MCC は 4 マスの積で決まるので、FP と FN のどちらかだけを減らしても最大にならない。
Python で計算する #
環境を確認し、必要なパッケージを入れます。
| |
次のコードは、陽性が 5% しかない 40,000 件のデータを作り、class_weight="balanced" のロジスティック回帰で予測して、混同行列と MCC を表示します。
| |
実行結果の読み方 #
混同行列の TN は 9,000 件台、TP は 400 件台になり、MCC は 0.5 前後の値が返ります。同じ予測の Accuracy は 0.9 を超えるので、不均衡データでは Accuracy の方が 0.4 ほど楽観的に見えることが分かります。class_weight を外して再実行すると Accuracy はほとんど変わらないのに MCC だけが下がり、「陽性側を捨てた」ことが数値に出ます。
閾値と MCC の関係 #
閾値ごとの MCC。クラス不均衡でも、最大値付近の閾値を使えば相関が高まりやすい。predict_proba の確率を 0.1 から 0.9 まで刻んで 0/1 に変え、閾値ごとに MCC を計算すると、1 点だけ山になる曲線が描けます。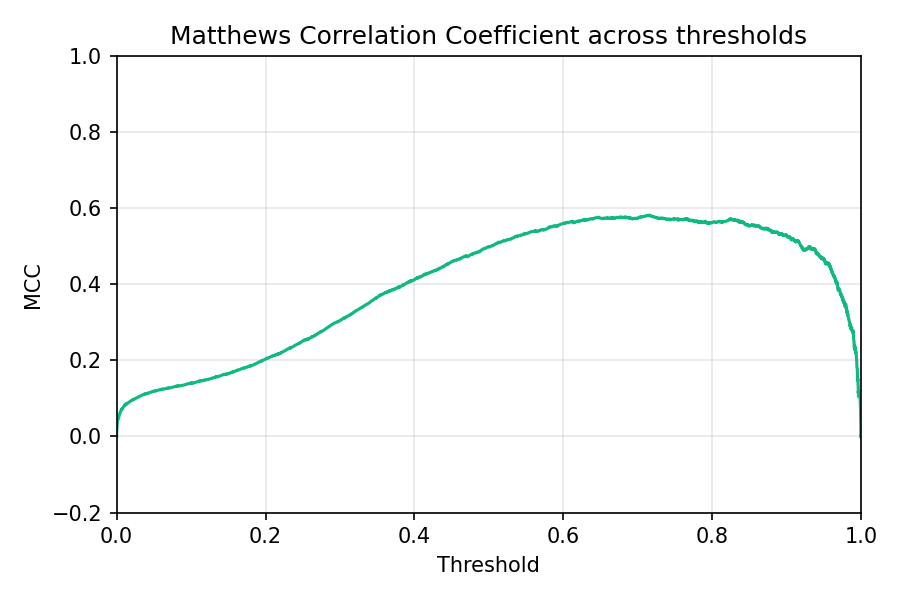
class_weight="balanced" を使った場合は 0.5 より少し高めに出ることが多いです。F1 スコアは TN を式に含まないので陰性をいくら正しく当てても値が変わりませんが、MCC は TN も分子に入るため、陽性 5% と陽性 50% のデータで同じモデルを比べても尺度がずれにくいのが利点です。
使いどころと落とし穴 #
Accuracy が 0.95 なのに MCC が 0.1 なら、どちらかのクラスを無視したモデルだと判断できるので、不均衡データの最初のチェックに向きます。GridSearchCV の scoring に make_scorer(matthews_corrcoef) を渡せば、ハイパーパラメータ探索の目的関数を MCC にできます。ROC 曲線や PR 曲線で全体の形を見たあと、MCC が最大になる閾値を動作点の候補にすると、FP と FN の両方を考えた 1 点が選べます。落とし穴は、4 マスのどれかが 0 のときに分母が 0 になる点で、scikit-learn は MCC を 0 として返しますが、評価データが数十件しかないと値が大きく揺れます。
まとめ #
MCC は混同行列の 4 マスを「予測列と正解列の相関係数」にまとめた指標で、−1 から 1 の尺度を持ち、「全部陰性」のような片寄った予測を 0 と採点します。matthews_corrcoef(y_test, y_pred) で計算でき、陽性 5% のデータでは Accuracy 0.95 のモデルが MCC では 0.5 前後になるなど、不均衡でも偏りなく比べられます。TN を無視する F1 スコアと違って陰性側の当たりも評価するので、閾値ごとに MCC を描いて最大点を探せば FP と FN の両方を考えた動作点が決まります。コーエンのカッパ や バランスド正解率 と並べると、不均衡データでの評価の全体像がそろいます。
閾値と各指標 #
閾値を 0 から 1 まで動かし、Accuracy・Precision・Recall がどの点で入れ替わるか確認してください。MCC の最大点は Precision と Recall が交差する付近に来ます。