03.3.3
Precision-Recall
precision_recall_curve で曲線を描き、見逃しと誤報のどちらが痛い課題かに応じて閾値を選べるようになります。混同行列 の TP・FP・FN・TN の 4 マスを先に押さえておくと、Precision と Recall が「同じ TP をどの分母で割るか」の違いだとすぐ読めます。
直感:誤報と見逃しを別々に数える #
迷惑メールフィルタが 100 通を「迷惑」と判定し、そのうち 90 通が本当に迷惑メールだったとします。Precision は 90/100 = 0.90 で、「迷惑と言ったうちの正解率」です。一方、受信箱全体には迷惑メールが 120 通あったのに 90 通しか捕まえられなかったなら、Recall は 90/120 = 0.75 で、「本物のうち捕まえた割合」です。フィルタの感度を上げて 150 通を迷惑と判定すれば、捕まえる本物は 110 通に増えて Recall は 0.92 に上がりますが、巻き込まれた正常メールも 40 通に増え、Precision は 110/150 = 0.73 に下がります。この「片方を上げると片方が下がる」関係を閾値ごとに全部描いたものが PR 曲線です。
式で書くと何を割っているか #
混同行列の記号を \(TP\)(真陽性)、\(FP\)(偽陽性)、\(FN\)(偽陰性)、\(TN\)(真陰性)とすると、
$$ \text{Precision} = \frac{TP}{TP + FP}, \qquad \text{Recall} = \frac{TP}{TP + FN} $$適合率の分母 \(TP + FP\) は「陽性と判定した数」です。誤報 FP を抑えたいときに重視します。再現率の分母 \(TP + FN\) は「実際の陽性の数」で、見逃し FN が問題になるときに重視します。F1 スコアは 2 つの調和平均で、どちらか一方が 0.1 のように低いと F1 も低く出るため、双方を同程度に重視したいときの 1 本のまとめ指標になります。
$$ F_1 = 2 \cdot \frac{\text{Precision} \cdot \text{Recall}}{\text{Precision} + \text{Recall}} $$何が起きているか(ステップで見る) #
コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。
見るポイント:閾値を動かすと TP・FP・FN が同時に変わる。どれを重視するかで最適な閾値は変わる。閾値を下げるほど FN が減って Recall が上がり、FP が増えて Precision が下がる。
Python で PR 曲線を描く #
環境を確認し、必要なパッケージを導入します。
| |
次のコードでは少数クラスが 5% のデータセット 40,000 件を生成し、class_weight="balanced" 付きロジスティック回帰で確率を出して、PR 曲線と平均適合率(AP)を描画します。図は static/images/eval/classification/precision-recall/pr_curve.png に保存され、generate_eval_assets.py から再生成できます。
| |
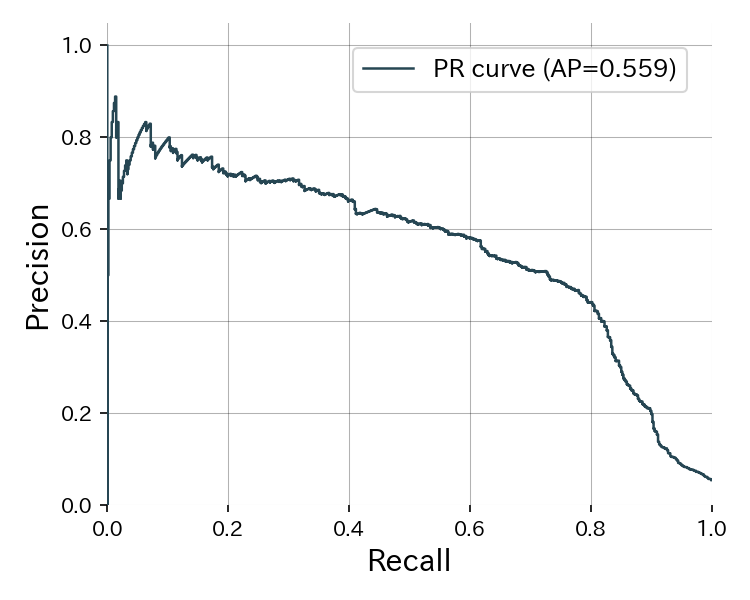
平均適合率(AP)は PR 曲線下の面積。閾値の移動で適合率と再現率のバランスが変わる。
実行結果の読み方 #
曲線の左上は閾値が高く「確信のある数件だけを陽性にした」状態で Precision が 1 に近く、右へ進むほど閾値が下がって Recall が上がり、Precision が落ちていきます。右端は全件を陽性にした状態で、Precision は陽性率の 0.05 に一致します。凡例の AP が 0.5 を超えていれば、ランダム予測(AP ≒ 陽性率 0.05)より 10 倍以上良い識別ができていると読めます。
閾値を 0.5 から 0.3 に下げると何が起きるか #
閾値 0.5 固定では見逃し(FN)を十分に減らせないことがあります。PR 曲線上の任意の点に対応する閾値は precision_recall_curve が 3 番目に返す thresholds から取れるので、Recall を 0.9 以上にしたい点を探し、その閾値で予測し直します。次のコードは閾値を 0.3 に下げて、同じ proba から 3 つの指標を再計算します。
| |
多クラス分類での平均化 #
クラスが 3 つ以上あるときは、クラスごとに Precision と Recall を出してから 1 つにまとめる必要があり、scikit-learn では average 引数で重み付けを切り替えます。macro はクラスごとの値を単純平均するので、サンプル数が 10 件しかないクラスも 10,000 件のクラスと同じ重みで効きます。weighted は各クラスにサンプル数の重みを付けるので、全体のバランスをそのまま反映します。micro は全サンプルの TP・FP・FN を合算して再計算するため、クラス不均衡が強いと少数クラスの誤りが埋もれます。
| |
まとめ #
Precision は「陽性と判定したうちの正解率」で誤報 FP の少なさを、Recall は「本物の陽性のうち捕まえた割合」で見逃し FN の少なさを測り、分子の TP は共通で分母だけが違います。閾値を 0.5 から 0.3 に下げると Recall が上がり Precision が下がるので、precision_recall_curve で全閾値の組を描き、見逃しが痛い課題なら Recall ≥ 0.9 を満たす閾値を thresholds から選びます。F1 や平均適合率(AP)は 2 つを 1 本にまとめた指標で、モデル比較や閾値調整の議論に使えます。陽性率が 5% のような不均衡では ROC-AUC より PR 曲線の方が差が見えるので、平均適合率 と ROC-AUC を並べて確認します。
閾値と適合率・再現率の変化 #
スライダーで閾値を 0 から 1 まで動かすと、Precision と Recall が逆向きに動き、F1 が途中で山を作る様子を確認できます。
- F1スコア — 適合率と再現率の調和平均
- ROC-AUC — 閾値非依存の性能評価
- 平均適合率 — PR 曲線下面積
- 混同行列 — 各指標の導出元
- Focal Loss — 不均衡データ向けの損失関数