03.4.1
Kullback-Leibler ダイバージェンス
rel_entr で \(p_i \log(p_i / q_i)\) を安全に計算し、ゼロ確率に \(\epsilon\) を足す理由と、生成モデル評価やドリフト監視で向きをどう決めるかを説明できるようになります。直感:Q だと思い込んで P を符号化したときの損 #
天気が「晴れ 70%・雨 30%」の町(分布 \(P\))で、「晴れ 50%・雨 50%」だと思い込んでいる人(分布 \(Q\))がいるとします。この人は晴れの日に「意外だ」と思いすぎ、雨の日に「意外さ」を足りなく見積もるので、日々の驚きの平均が真の分布を知っている人より大きくなります。その余分な驚きの平均が \(\mathrm{KL}(P \parallel Q)\) で、底 2 の対数なら「1 日あたり何ビット余計に符号が必要か」と読めます。思い込みが真実と一致していれば余分はないので 0、\(Q\) が「雨 0%」と決めつけていて実際に雨が降れば驚きは無限大、つまり発散します。
式で書くと何を足し合わせているか #
KL ダイバージェンスは、基準分布 \(Q\) を想定したときに実際の分布 \(P\) がどれだけ異なるかを相対エントロピーとして表します。
$$ \mathrm{KL}(P \parallel Q) = \sum_i p_i \log \frac{p_i}{q_i} $$各項は「\(P\) の重み \(p_i\)」×「\(Q\) が \(P\) をどれだけ低く見ていたか \(\log(p_i / q_i)\)」で、\(q_i < p_i\) の点は正、\(q_i > p_i\) の点は負の寄与をし、合計は必ず 0 以上になります。\(\mathrm{KL}(P \parallel Q) = 0\) のとき分布は一致します。重みが \(p_i\) で掛かるため、一般に \(\mathrm{KL}(P \parallel Q) \neq \mathrm{KL}(Q \parallel P)\) で、どちらを基準に置くかで値が変わります。\(q_i = 0\) かつ \(p_i > 0\) の場合は \(\log(p_i / 0)\) で無限大となるため、サポートの違いに敏感です。
何が起きているか(ステップで見る) #
コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。
見るポイント:分布のずれを測る尺度は複数ある。重なりが消えたとき KL は発散し、Wasserstein は距離を測り続ける。KL の棒だけが途中で天井に張り付く。
Python で実装する #
次のコードは、2 つの確率ベクトルを正規化し、rel_entr で各要素の \(p_i \log(p_i / q_i)\) を計算して合計する関数を定義します。
| |
rel_entr を用いると、配列要素ごとの \(p_i \log \frac{p_i}{q_i}\) を安全に計算できます。ゼロ確率が含まれる場合は微小値 \(\epsilon\) を加えるなどのスムージングを事前に行いましょう。
ヒストグラム例で非対称性を見る #
以下は 6 値の離散分布 \(p\) と \(q\) を棒グラフで並べた例で、\(p\) は左寄り、\(q\) は右寄りの山になっています。
| |
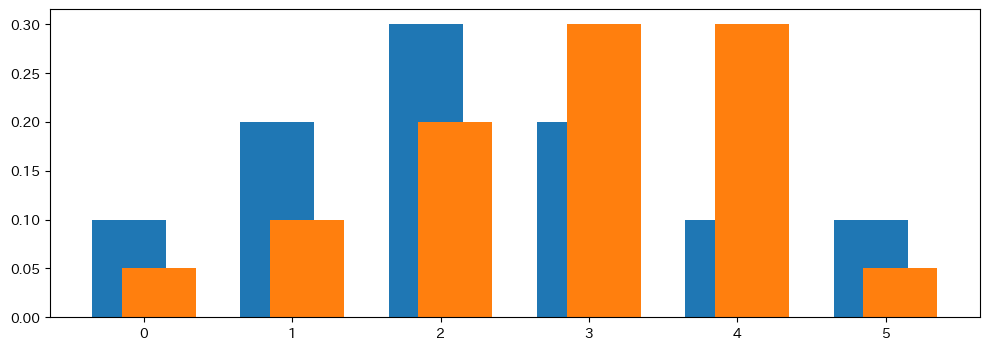
分布pとqを棒グラフで並べた例。形状の違いがKLダイバージェンスの大きさに反映される。
同じ分布どうしの KL は 0 になり、\(p\) と \(q\) の向きを入れ替えると値が変わることを次のコードで確かめます。
| |
出力の KL(p || b) と KL(b || a) が一致しないことから、順序を入れ替えると値が変わり、どちらを基準 \(Q\) とするかで解釈が異なることが確認できます。
Jensen–Shannon ダイバージェンスへの接続 #
KL の非対称性を解消したい場合は、\(P\) と \(Q\) の平均分布 \(M = (P + Q) / 2\) を基準にして両方向の KL を平均した Jensen–Shannon ダイバージェンスを用います。以下の図は平均 1 と平均 4 の 2 つの正規分布と、その中間(平均 2.5)の分布のイメージです。
| |
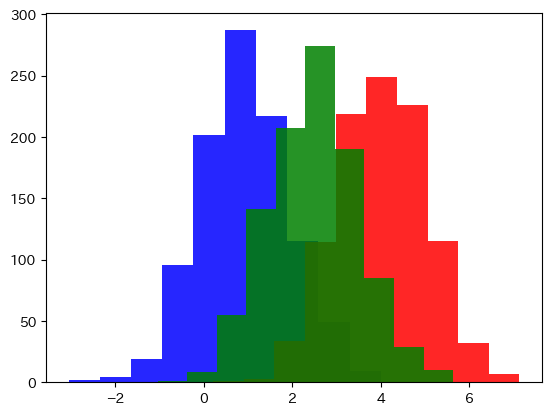
青と赤の正規分布の中間(緑)を基準にすると、Jensen-Shannonダイバージェンスが計算できる。
使いどころと落とし穴 #
生成モデルの評価では、実データの分布を \(P\)、生成分布を \(Q\) に置いて KL を測り、生成分布が教師データから離れていないかをチェックします。監視・ドリフト検知では、学習時の特徴量分布を基準 \(Q\) にして配信データ \(P\) の KL を日次で追い、閾値を超えたらアラートにします。言語モデルでは n-gram 分布や出力確率の差異を KL で測り、蒸留の損失関数としても使われます。注意点として、サンプル数が少ない場合は推定が不安定になるため、ディリクレ事前分布によるスムージングなどを組み合わせます。また、KL が大きい場合でも必ずしも性能悪化を意味しないため、Accuracy や F1 などの指標と合わせて解釈しましょう。
まとめ #
KL ダイバージェンス \(\sum_i p_i \log(p_i / q_i)\) は「基準分布 \(Q\) で \(P\) を符号化したときの余分な情報量」で、分布が一致すれば 0、\(q_i = 0\) の点に \(p_i > 0\) があれば発散します。rel_entr(p + eps, q + eps) の合計で実装でき、\(\epsilon = 10^{-12}\) を足すことで inf を避けられます。6 値分布の例で KL(p || b) と KL(b || a) が一致しないように非対称なので、生成モデル評価や監視では「実データを \(P\)、基準を \(Q\)」のように向きを決めて固定します。対称で有界な尺度が必要なら Jensen-Shannon ダイバージェンス か ヘリンガー距離、ドリフト監視の定番指標なら PSI に進みます。
- Jensen-Shannon ダイバージェンス — KLD の対称化版
- ヘリンガー距離 — 分布間距離の別指標
- コサイン類似度 — ベクトル空間での類似度
- PSI — KLダイバージェンスを応用したデータドリフト検出指標
分布の差と KL ダイバージェンス #
2 つの正規分布の中心のずれを変えると、KL ダイバージェンスが他の距離より急に増え、重なりが消えると発散に向かう様子を確認できます。