03.1.2
層化K分割交差検証
KFold(n_splits=4) で切ると、少数クラスは 4 件前後しかないので検証データに 1 件も入らないフォールドができ、そのフォールドではそのクラスの Recall が計算できません。StratifiedKFold は各クラスを 4 等分してから組み合わせるので、どのフォールドにも全クラスが元の比率で入ります。読み終えると、分類タスクで StratifiedKFold(n_splits=4, shuffle=True, random_state=42) を標準にする理由と、回帰や極端な不均衡で RepeatedStratifiedKFold などに切り替える判断ができるようになります。交差検証 で「フォールドを順番に検証用に回して平均する」流れを先に押さえておくと、このページが「フォールドの切り方だけを変えた版」だと分かります。
直感:各クラスを別々に k 等分してから混ぜる #
学校の 210 人を 4 班に分けるとき、全体をランダムに切ると、たまたま 4 人しかいない部活の生徒が 1 つの班に偏り、別の班には 1 人もいない、ということが起きます。層化(stratify)は「部活ごとに 4 等分してから各班に 1 人ずつ配る」操作で、どの班にも全部活が元の比率で入ります。通常の K-Fold はデータをランダムに分割するため、クラス不均衡なデータでは一部のフォールドに少数クラスのサンプルが偏る、または含まれないことがあります。Stratified K-Fold は各フォールドで元データのクラス比率を維持するように分割することで、この問題を防ぎます。ラベル比率が崩れると、そのフォールドの検証スコアは「少数クラスを 1 件も見ていない」評価になり、\(k\) 回の平均が不安定になります。分類タスクでは基本的に層化を使い、cross_val_score も分類では既定でこちらを選びます。
何が起きているか(ステップで見る) #
コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。
見るポイント:データを増やして 2 本の線の差を見る。2 本の差が残るなら過学習、2 本とも誤差が高いままなら学習不足(図の縦軸は RMSE で、低いほど良い)。各点のスコアは交差検証の平均で、分け方が偏ると線がぎざぎざになる。
Python で KFold と StratifiedKFold を比べる #
次のコードは、10 クラスの不均衡データ(クラス 0 が 82% を占める 210 件)を生成し、通常の K-Fold と Stratified K-Fold で 4 分割したときのラベル分布を比較します。
| |
元データのクラス分布 #
まず 210 件全体のクラス分布をヒストグラムで確認し、クラス 0 だけが突き出ていることを見ます。
| |
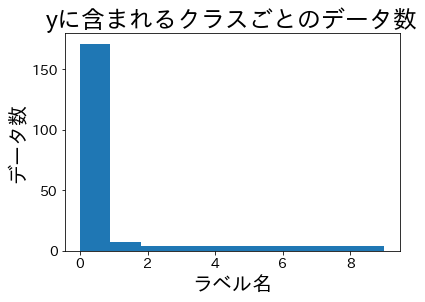
クラス0が大多数を占める不均衡データ。少数クラスはそれぞれ数件しかない。
Stratified K-Foldによる分割 #
StratifiedKFold で 4 分割し、各フォールドの訓練データと検証データのラベル比率が維持されていることを 4×2 の棒グラフで確認します。
| |
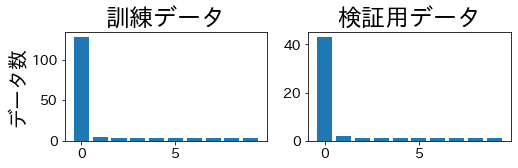
Stratified K-Fold: すべてのフォールドで訓練・検証データのクラス比率が元データと一致している。
通常のK-Foldによる分割 #
同じデータを KFold(n_splits=4) で切ると、一部のフォールドで少数クラスが検証データに 1 件も含まれないことが確認できます。
| |
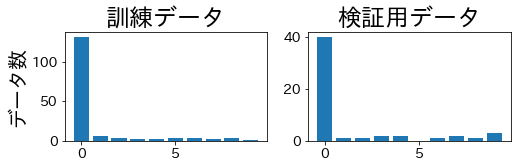
通常のK-Fold: フォールドによっては検証データに少数クラスが含まれず、評価が不安定になる。
使い分けのポイント #
分類タスクでは Stratified K-Fold を標準にします。scikit-learn の cross_val_score や GridSearchCV は分類器を渡すと既定で StratifiedKFold を使うので、cv=5 と整数で指定しただけでも層化されています。回帰タスクではラベルが連続値のため通常の K-Fold を使いますが、目的変数の分布に偏りがある場合は pd.qcut などで 5〜10 個のビンに分け、そのビン番号を y として StratifiedKFold に渡す方法もあります。少数クラスがフォールド数より少ない極端な不均衡では、StratifiedKFold でも警告が出て各フォールドに 1 件も配れないので、RepeatedStratifiedKFold(n_splits=3, n_repeats=5) のように分割数を減らして繰り返し、安定したスコアを得ます。
実務でのチェックリスト #
分割後は、各フォールドの訓練・検証データに全クラスが含まれているかを np.unique(y[valid_idx]) の長さで確認します。shuffle=True と random_state を設定して、再実行やモデル変更のときに同じ分割で比較できるようにします。時系列データの場合は時間順を壊す層化は使わず、TimeSeriesSplit を優先します。
まとめ #
Stratified K-Fold は各クラスを別々に \(k\) 等分してから組み合わせるので、クラス 0 が 82% の 210 件データを 4 分割しても、どのフォールドの検証データにも 10 クラスが元の比率で入ります。通常の KFold では少数クラスの約 4 件が偏り、検証データから消えるフォールドが出て、そのクラスの Recall が 0 扱いになり平均スコアが不安定になります。StratifiedKFold(n_splits=4, shuffle=True, random_state=42) を分類の標準とし、回帰は目的変数をビン分割してから、極端な不均衡は RepeatedStratifiedKFold で繰り返して対応します。フォールド数と少数クラスの件数(例: 4 件を 4 分割)の関係を事前に確認し、検証曲線 や ネステッド交差検証 でも同じ分割器を渡して条件を揃えます。
分割数と層化 k 分割 #
分割数 k を変えると、各フォールドのサイズが 100 件の 1/k ずつになり、少数クラスを 1 件ずつ配れる k の上限が見えてきます。