03.1.3
検証曲線 (Validation Curve)
まとめ検証曲線(Validation Curve)は、1 つのハイパーパラメータを変えながら訓練スコアと検証スコアを並べて描いた図です。横軸を SVC の正則化係数 \(C\)(\(10^{-3}\) から \(10^{2}\) まで対数刻み)にすると、左端では 2 本とも低い学習不足、右端では訓練スコアだけが高止まりする過学習、その間の \(C \approx 1\) 付近で検証スコアが最大になる様子が 1 枚に収まります。学習曲線が「サンプル数とスコア」の関係を調べるのに対し、検証曲線は「ハイパーパラメータとスコア」の関係を読み解く道具です。読み終えると、validation_curve(estimator, X, y, param_name="svc__C", param_range=..., cv=5) で 10 点 × 5 分割のスコアを取り、平均と標準偏差の帯から探索すべき \(C\) の範囲を絞れるようになります。
交差検証 の「\(k\) 回評価して平均と標準偏差を取る」流れを先に見ておくと、検証曲線の各点とその帯がどう計算されているかが分かります。
直感:2 本の線の高さと差で 3 つの状態を見分ける
#
RBF カーネルの SVC は正則化係数 \(C\) が小さいほど境界を単純に、大きいほど訓練データに合わせて複雑にします。\(C\) を 10 通り試して、各 \(C\) で「訓練データでの ROC-AUC」と「交差検証での ROC-AUC」を記録し、横軸 \(C\)・縦軸スコアで 2 本の折れ線にしたものが検証曲線です。訓練スコアが 0.95 なのに検証スコアが 0.80 なら、モデルが訓練データを覚えすぎている過学習で、正則化を強める(\(C\) を小さくする)か木を浅くするなどの調整が効きます。両方のスコアが 0.7 で低いなら表現力が足りない学習不足で、正則化を弱めるかより複雑なモデルに切り替えます。2 本が近く、かつ検証スコアが最大の \(C\) が、汎化性能の高い設定の候補です。
何が起きているか(ステップで見る)
#
コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。
見るポイント:次数を上げると訓練には合うが、未知データでは途中から悪化する。その分岐点がモデル選択。検証曲線は、この「次数」を SVC の \(C\) のような任意のハイパーパラメータに置き換えた図。
Python で SVC の C に対する検証曲線を描く
#
次のコードは、1,200 件の二値分類データに標準化 + RBF カーネル SVC を当て、正則化係数 \(C\) を \(10^{-3}\) から \(10^{2}\) の 10 点で動かしながら、5 分割交差検証の ROC-AUC を訓練側と検証側で計算して描画します。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
| from __future__ import annotations
import matplotlib.pyplot as plt
import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import validation_curve
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC
def plot_validation_curve_for_svc() -> None:
"""SVC の正則化係数に対する検証曲線を描画して保存する。"""
features, labels = make_classification(
n_samples=1200,
n_features=20,
n_informative=5,
n_redundant=2,
n_repeated=0,
n_classes=2,
weights=[0.6, 0.4],
flip_y=0.02,
class_sep=1.2,
random_state=42,
)
model = make_pipeline(StandardScaler(), SVC(kernel="rbf", gamma="scale"))
param_range = np.logspace(-3, 2, 10)
train_scores, valid_scores = validation_curve(
estimator=model,
X=features,
y=labels,
param_name="svc__C",
param_range=param_range,
scoring="roc_auc",
cv=5,
n_jobs=None,
)
train_mean = train_scores.mean(axis=1)
train_std = train_scores.std(axis=1)
valid_mean = valid_scores.mean(axis=1)
valid_std = valid_scores.std(axis=1)
plt.figure(figsize=(7, 5))
plt.semilogx(param_range, train_mean, label="Train score", color="#1d4ed8")
plt.fill_between(
param_range,
train_mean - train_std,
train_mean + train_std,
alpha=0.2,
color="#1d4ed8",
)
plt.semilogx(param_range, valid_mean, label="Validation score", color="#ea580c")
plt.fill_between(
param_range,
valid_mean - valid_std,
valid_mean + valid_std,
alpha=0.2,
color="#ea580c",
)
plt.title("Validation Curve for SVC (ROC-AUC)")
plt.xlabel("Regularization parameter C")
plt.ylabel("Score")
plt.ylim(0.5, 1.05)
plt.legend(loc="best")
plt.grid(alpha=0.3)
plot_validation_curve_for_svc()
|
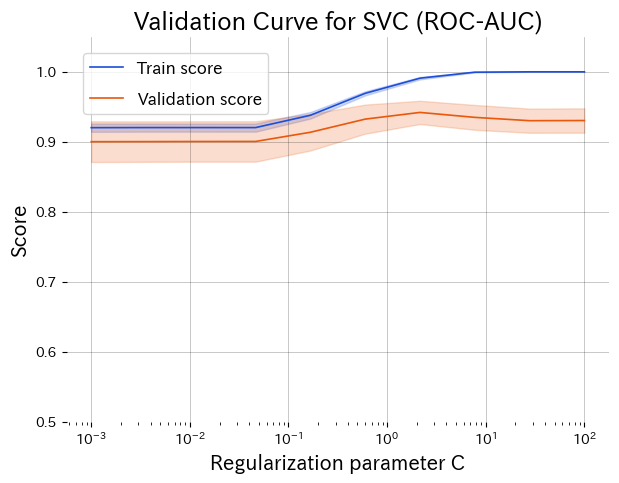
正則化係数 C を変化させたときの学習スコア(青)と検証スコア(橙)。検証スコアがピークになる付近が汎化性能の高い設定。
グラフの読み取りと意思決定
#
左端の小さな \(C\)(\(10^{-3}\) 付近)では正則化が強すぎてモデルが単純化し、訓練スコアと検証スコアがともに低いアンダーフィットになっています。右端の大きな \(C\)(\(10^{2}\) 付近)では正則化が弱まり、訓練スコアだけが 1.0 近くに高止まりして検証スコアが下がるオーバーフィットです。中央付近のピークでは 2 本の差が小さく、検証スコアが最大になるので、このパラメータ領域が最有力候補になります。この例では \(C \approx 1\) 付近で検証スコアがもっとも高く、汎化性能と学習性能のバランスが取れていることがわかります。
使いどころと落とし穴
#
グリッドサーチやベイズ最適化に進む前に、\(C\) のように効きの大きいハイパーパラメータを 1 つ選んで検証曲線を描き、\(10^{-1}\) から \(10^{1}\) のように有効なレンジを絞っておくと、探索の点数を 1/10 に減らせます。データ量が 1,200 件程度だとフォールド間のばらつきが大きいので、平均値だけでなく標準偏差の帯も見て、帯が重なる \(C\) どうしは「差がない」と判断します。gamma や max_depth など主要パラメータごとに検証曲線を作れば、どのパラメータから詰めるべきかの優先順位と、組み合わせの当たりが付きます。検証曲線で「どのパラメータが効くか」を把握し、ラーニングカーブ で「十分なサンプル数があるか」を確認すると、正則化を調整すべきかデータを増やすべきかの改善方針が立てやすくなります。
モデルごとにこうした図を用意しておくと、「\(C = 100\) にすれば訓練スコアは上がるが検証スコアは 0.05 下がる」のように、ハイパーパラメータ調整の方向性をチーム内で数値を添えて説明できます。
パラメータと誤差
#
モデルの複雑さを決めるパラメータを動かすと、訓練誤差は下がり続けるのに検証誤差は途中から上がる様子を確認できます。