まとめ 決定係数 \(R^2\) は、「毎回平均値 \(\bar{y}\) を答える」という最も単純な予測と比べて、モデルが残差二乗和をどれだけ減らせたかの割合です。\(R^2 = 1 - \sum(y_i - \hat{y}_i)^2 / \sum(y_i - \bar{y})^2\) で定義され、1 なら誤差 0、0 なら平均予測と同じ、負なら平均を答えるより悪い予測を意味します。単位を持たないので「ばらつきの 93% を説明した」と読め、
r2_score(y_test, y_pred) の 1 行で計算できます。特徴量を増やすと学習データ上の \(R^2\) は必ず上がるので、テストデータで測るか
自由度調整済み R² と並べて見るのが基本です。
直感:「平均を答える」と比べてどれだけ良いか
# 気温からアイスの売上を予測するモデルの誤差が「平均 3 個」だと言われても、売上が毎日 50〜60 個の店と 10〜200 個の店では意味が違います。そこで、モデルを作らずに毎日「平均の売上」を答えたときの誤差を基準にします。平均予測の残差二乗和が 1,000、モデルの残差二乗和が 70 なら、\(R^2 = 1 - 70/1000 = 0.93\) で「ばらつきの 93% を説明できた」と読みます。モデルの残差が平均予測の残差より大きければ分数が 1 を超え、\(R^2\) は負になります。
定義
# 決定係数 \(R^2\) は、平均予測というベースラインに比べて誤差がどれだけ減ったかを測ります。
$$
R^2 = 1 - \frac{\sum_i (y_i - \hat{y}_i)^2}{\sum_i (y_i - \bar{y})^2}
$$分子はモデルの残差二乗和、分母は平均 \(\bar{y}\) からのずれの二乗和(分散 × n)です。\(R^2 = 1\) は分子が 0、つまり誤差 0 で完全に当てている状態、\(R^2 = 0\) は分子と分母が等しく平均だけを予測したのと同じ状態、\(R^2 < 0\) は平均よりも誤差が大きくモデルが悪化している状態です。学習データ上では特徴量を増やすと分子は単調に小さくなるため、\(R^2\) は過学習しても上がり続ける点に注意が必要です。
何が起きているか(ステップで見る)
# コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。
見るポイント :R² は「平均で予測したときの誤差」に対して、どれだけ誤差(正方形の面積)を減らせたか。
Python で計算する
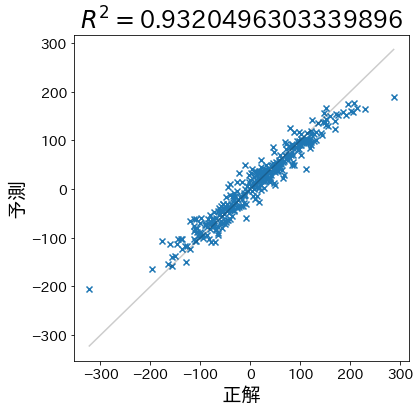
# sklearn.metrics.r2_score を使います。説明変数 20 個のうち 3 個だけが目的変数に効く 1,000 件のデータを生成し、ランダムフォレスト回帰で学習して、テストデータの実測値と予測値の散布図に \(R^2\) を表示します。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
import matplotlib.pyplot as plt
import numpy as np
from sklearn.datasets import make_regression
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import r2_score
from sklearn.model_selection import train_test_split
RANDOM_STATE = 42
X , y = make_regression (
n_samples = 1_000 ,
n_informative = 3 ,
n_features = 20 ,
noise = 5.0 ,
random_state = RANDOM_STATE ,
)
train_X , test_X , train_y , test_y = train_test_split (
X , y , test_size = 0.33 , random_state = RANDOM_STATE
)
model = RandomForestRegressor ( max_depth = 5 , random_state = RANDOM_STATE )
model . fit ( train_X , train_y )
pred_y = model . predict ( test_X )
r2 = r2_score ( test_y , pred_y )
y_min , y_max = np . min ( test_y ), np . max ( test_y )
plt . figure ( figsize = ( 6 , 6 ))
plt . plot ([ y_min , y_max ], [ y_min , y_max ], linestyle = "-" , color = "black" , alpha = 0.2 )
plt . scatter ( test_y , pred_y , marker = "x" )
plt . xlabel ( "True" )
plt . ylabel ( "Predicted" )
plt . title ( f "R^2 = { r2 : .3f } " )
plt . grid ( alpha = 0.3 )
plt . show ()
予測がほぼ対角線上に並び、R²が高い状態。ノイズが小さくモデルが分散をよく説明できている。
学習・検証データが同じ分布から生成され、ノイズも 5.0 と小さいため、予測はほぼ対角線上に並び \(R^2\) も 0.9 を超えます。
ばらつきが大きいデータと負の値
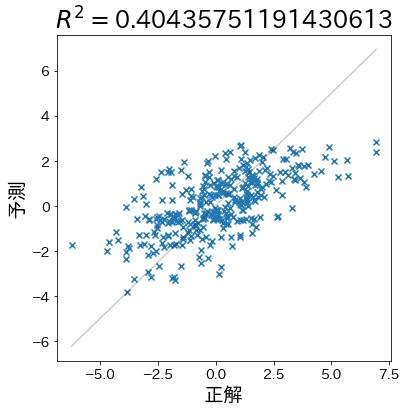
# 特徴量間に相関が多く(effective_rank=4)、ノイズが 30.0 と大きい場合は \(R^2\) が下がります。それでも平均予測よりは良ければ、0〜1 の範囲に収まります。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
X , y = make_regression (
n_samples = 1_000 ,
n_informative = 3 ,
n_features = 20 ,
effective_rank = 4 ,
noise = 30.0 ,
random_state = RANDOM_STATE ,
)
train_X , test_X , train_y , test_y = train_test_split (
X , y , test_size = 0.33 , random_state = RANDOM_STATE
)
model = RandomForestRegressor ( max_depth = 5 , random_state = RANDOM_STATE )
model . fit ( train_X , train_y )
pred_y = model . predict ( test_X )
r2 = r2_score ( test_y , pred_y )
y_min , y_max = np . min ( test_y ), np . max ( test_y )
plt . figure ( figsize = ( 6 , 6 ))
plt . plot ([ y_min , y_max ], [ y_min , y_max ], linestyle = "-" , color = "black" , alpha = 0.2 )
plt . scatter ( test_y , pred_y , marker = "x" , alpha = 0.6 )
plt . xlabel ( "True" )
plt . ylabel ( "Predicted" )
plt . title ( f "R^2 = { r2 : .3f } " )
plt . grid ( alpha = 0.3 )
plt . show ()
ノイズが大きいためばらつきが増し、R²は低下するが0以上を維持している。
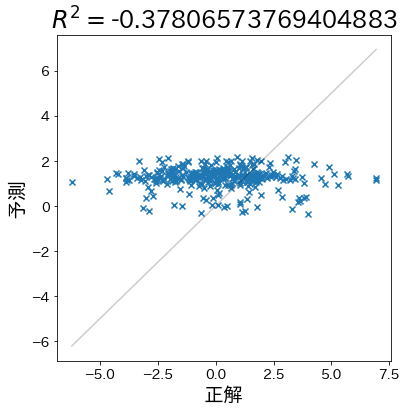
さらに、学習の仕方が悪いと平均予測よりも悪化し \(R^2 < 0\) になります。次の例では、学習データの目的変数をランダムにシャッフルして入力との関係を壊します。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
X , y = make_regression (
n_samples = 1_000 ,
n_informative = 3 ,
n_features = 20 ,
effective_rank = 4 ,
noise = 30.0 ,
random_state = RANDOM_STATE ,
)
train_X , test_X , train_y , test_y = train_test_split (
X , y , test_size = 0.33 , random_state = RANDOM_STATE
)
train_y = np . random . permutation ( train_y )
train_y = np . sin ( train_y ) * 10 + 1
model = RandomForestRegressor ( max_depth = 1 , random_state = RANDOM_STATE )
model . fit ( train_X , train_y )
pred_y = model . predict ( test_X )
r2 = r2_score ( test_y , pred_y )
y_min , y_max = np . min ( test_y ), np . max ( test_y )
plt . figure ( figsize = ( 6 , 6 ))
plt . plot ([ y_min , y_max ], [ y_min , y_max ], linestyle = "-" , color = "black" , alpha = 0.2 )
plt . scatter ( test_y , pred_y , marker = "x" , alpha = 0.6 )
plt . xlabel ( "True" )
plt . ylabel ( "Predicted" )
plt . title ( f "R^2 = { r2 : .3f } " )
plt . grid ( alpha = 0.3 )
plt . show ()
目的変数をシャッフルしたため予測が破綻し、R²が負の値になっている。
負の値は「平均から予測するよりも悪い」ことを意味し、入力と目的変数の関係が崩れている(ラベルの取り違え、リーク、分布の変化など)可能性を示します。
最小二乗法での性質
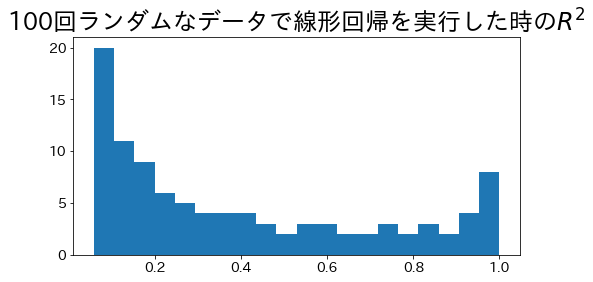
# 最小二乗法による単回帰モデルでは、学習データ上の決定係数は理論上 \(0 \le R^2 \le 1\) に収まります。ノイズを 0 から 3.0 まで変化させながら線形回帰を 100 回繰り返し、テストデータでの \(R^2\) の分布を見ます。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
r2_scores : list [ float ] = []
for noise in np . linspace ( 0.0 , 3.0 , 100 ):
X , y = make_regression (
n_samples = 500 ,
n_informative = 1 ,
n_features = 1 ,
effective_rank = 1 ,
noise = noise ,
random_state = RANDOM_STATE ,
)
train_X , test_X , train_y , test_y = train_test_split (
X , y , test_size = 0.33 , random_state = RANDOM_STATE
)
model = make_pipeline (
StandardScaler ( with_mean = False ),
LinearRegression ( positive = True ),
)
model . fit ( train_X , train_y )
pred_y = model . predict ( test_X )
r2_scores . append ( r2_score ( test_y , pred_y ))
plt . figure ( figsize = ( 8 , 4 ))
plt . hist ( r2_scores , bins = 20 , color = "#2563eb" , alpha = 0.8 , edgecolor = "white" )
plt . xlabel ( "R^2 score" )
plt . ylabel ( "Frequency" )
plt . title ( "Distribution of R^2 across 100 noisy datasets" )
plt . grid ( alpha = 0.3 )
plt . show ()
ノイズを変化させた100回の線形回帰におけるR²の分布。ノイズが大きいほどR²は低下する。
ノイズが大きくなるほどヒストグラムが左側にシフトします。同じモデルでもデータのノイズ次第で \(R^2\) が 1 付近から 0.5 以下まで動くので、1 回の値で判断せず、交差検証や調整済み指標で安定性を確かめる必要が見えてきます。
実務での活用と注意点
# 特徴量を増やすほど学習データの \(R^2\) は上昇するので、Adjusted R² や AIC/BIC と併用して過学習をチェックします。\(R^2\) は単位を持たない相対指標なので、「平均で 3 個外れる」と伝えたいときは MAE、過小予測を罰したいときは RMSLE のように、ビジネス指標と整合する評価値も併せて確認します。サンプルが 30 件程度と少ないと \(R^2\) の分散が大きく解釈が難しいので、交差検証やブートストラップで安定性を確かめます。木系モデルやニューラルネットでは、上の例のようにテストデータで負の値が出ることも珍しくなく、残差プロットやリフトチャートと組み合わせて総合的に判断します。
ノイズと R²
# ノイズ量を 0 から 3.0 まで増やすと R² がどう悪化するか確認できます。点の帯が太くなるにつれて、分子の残差二乗和が分母に近づき、R² が 1 から 0 へ下がる様子が値に表れます。
まとめ
# 決定係数 \(R^2 = 1 - \sum(y_i - \hat{y}_i)^2 / \sum(y_i - \bar{y})^2\) は、平均値を答える予測と比べてモデルが残差二乗和をどれだけ減らせたかの割合で、r2_score(y_true, y_pred) で求まります。ノイズ 5.0 の素直なデータでは 0.9 を超え、ノイズ 30.0 で特徴量が相関したデータでは下がり、目的変数をシャッフルして学習すると −0.3 前後の負の値になり、「平均より悪い」ことを示します。学習データ上では特徴量を足すだけで上がる性質があるため、テストデータで測り、自由度調整済み R² や MAE などの誤差系指標と併用してモデルを評価します。
学習ナビ
PHASE 3 · 評価・改善
読んだページに印をつけると、トップページとセクション一覧に進み具合が表示されます(ブラウザ内にのみ保存)。