03.2.2 高校生向け
決定係数(高校生向け)
こんな場面を想像してみよう #
気温からアイスの売上を予測する直線を引きました。「この直線、どのくらい当たっている?」と聞かれたら、何と答えますか。「平均で 3 個外れる」でもよいのですが、3 個が大きいのか小さいのかは売上のばらつき次第です。そこで、何もモデルを作らなかったときと比べるのが決定係数の考え方です。
モデルを作らなければ、いちばんましな予測は「毎日、平均の売上 \(\bar{y}\) と答える」ことで、5 日分の例なら毎日 62.4 個と答えます。そのときのズレの 2 乗和と、直線で予測したときのズレの 2 乗和を比べます。
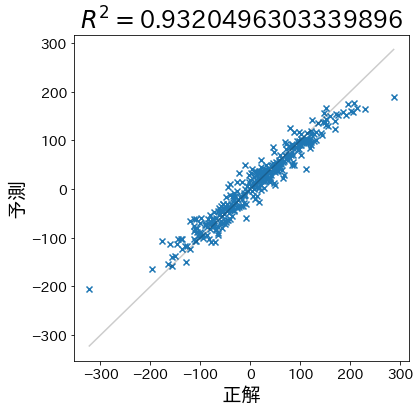
上の図は、横軸が正解、縦軸がモデルの予測です。うすい対角線が「予測=正解」の線で、点がこの線の近くに並ぶほど予測は正確です。この例では点がきれいに対角線に沿っていて、\(R^2\) は約 0.93。「正解のばらつきの 93% を説明できた」と読みます。
仕組み:平均という「基準線」と比べる #
まず基準線を引きます。もとの散布図(横軸に気温、縦軸に売上)に、平均の売上 \(\bar{y}\) の高さで横一直線を引き、各点からこの横線までの縦のズレを 2 乗して足した値が「平均からのズレの 2 乗和」です。これは \(y\) の分散 × データ数にほかなりません。次にモデルの直線で測り直します。同じ点から回帰直線までの縦のズレ(残差)を 2 乗して足します。そして割り算して 1 から引きます。モデルのズレの 2 乗和 ÷ 平均からのズレの 2 乗和 が「残ったズレの割合」で、1 からそれを引いた値が \(R^2\)、つまり「減らせたズレの割合」です。
直線を動かすと値の意味が見えます。直線が点のまん中を正確に通るほど残差は小さくなり、\(R^2\) は 1 に近づき、予測対正解の散布図では点が対角線に吸い寄せられていきます。逆に直線を平均の横線に重ねると、分子と分母が同じになって \(R^2 = 0\) です。さらに直線をあさっての方向に傾けると、残差が平均より大きくなって \(R^2\) は負になります。
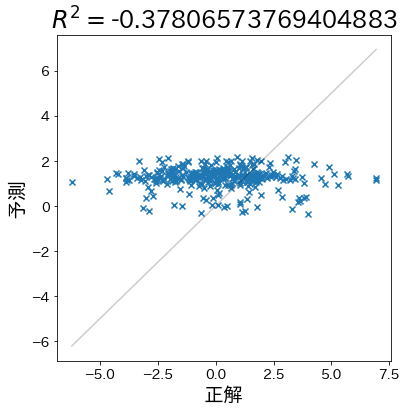
上の図が負になった例です。正解は −5 から 7 まで広がっているのに、予測は 1 付近に張りついて横に寝ています。平均を答え続けるよりも外れているので、\(R^2\) は −0.38 になりました。
手計算の確認用に、5 日分のデータで \(R^2\) を出すコードを置いておきます。
| |
出力は R2 = 0.973 です。pred をすべて 62.4(平均)にすると 0 になることも確かめられます。
動かして見てみよう #
下の図で「再生」を押すと、説明した手順が 1 つずつ進みます。手順ごとの説明は図の下に出ます。
気をつけたいこと #
最初の注意は、0.93 のように高くても因果があるとは限らないことです。\(R^2\) は「直線で説明できた割合」であって、気温が売上の原因だと証明するものではありません。二つ目は、変数を増やすと勝手に上がることです(標準版の Adjusted R² を参照)。関係のないデータを説明変数に足しても \(R^2\) は下がりません。情報IIで学ぶ過学習の入口で、テストデータで測るか、調整済み \(R^2\) を使います。三つ目は、値の見え方はデータ次第ということです。物理の実験なら 0.99 が普通でも、人の行動のデータでは 0.3 でも意味があることがあります。「何と比べて」を忘れないようにします。
やってみよう #
最初の課題は、上のコードの pred を [41, 55, 63, 71, 82] に変えて、\(R^2\) が上がるか下がるか予想してから実行してみることです。二つ目は、身長と体重のように相関がありそうなデータを 10 人分集め、相関係数 \(r\) を計算して 2 乗してみよう。それが「直線でどれだけ説明できるか」の割合です。三つ目は、\(R^2\) が負になる予測を自分で作ってみよう(ヒント:すべての点で平均よりも遠い値を答える)。
つぎに読む #
数式の導出、scikit-learn での計算、ノイズを変えたときの \(R^2\) の分布は 標準版の決定係数 で扱っています。分母に出てきた「相関係数」は 相関係数(高校生向け)、ズレそのものを測る指標は MAE・RMSE(高校生向け) へ進んでください。直線の引き方は 線形回帰(高校生向け)、指標の一覧は 回帰の評価指標 にあります。