05.1.5
ピーク検出
scipy.signal.find_peaks に系列を渡すとピークの位置(添字)が返ってきます。このページでは FRED から取得したハイイールド債のオプション調整後スプレッド BAMLH0A0HYM2(2017 年以降の日次)に distance=30、threshold=0.03、width=3 の条件を付けてピークを検出し、細かな揺れを除いた「信用不安が高まった日」だけを抜き出します。検出した日付を S&P 500 の折れ線に axvline で縦線として重ね、スプレッドのピークと株価の底が重なる 2018 年末や 2020 年 3 月を確認します。読み終えると、3 つの引数がピークの数をどう絞るかを図で説明できるようになります。直感 #
ハイイールド債スプレッドは低格付け社債の利回りが国債をどれだけ上回っているかで、投資家が不安になると急に広がり、落ち着くと縮みます。「不安が頂点に達した日」を知りたくても、日次の線は細かく上下するので、両隣より高い点を全部拾うと何百個もの「ピーク」が出てしまいます。find_peaks はそこに「隣のピークと 30 日以上離れていること」「両隣より 0.03 以上高いこと」「山の幅が 3 日以上あること」という条件を付けて、本当に目立つ山だけを残します。残ったピークの日に S&P 500 がどうなっていたかを見れば、「信用市場の悲鳴が株価の底と重なるか」を検証できます。
FRED からデータを取り出す準備 #
スプレッドと株価指数はどちらも FRED から取得します。関数 get_fred_data() は FRED データベース のページと同じもので、系列 ID を渡すと日付索引の DataFrame を返します。
| |
FRED APIキーが環境変数に設定されている:True
ハイイールド債スプレッド(BAMLH0A0HYM2)を取得する #
ソース:https://fred.stlouisfed.org/series/BAMLH0A0HYM2
ICE BofA US High Yield Index Option-Adjusted Spread を 2017 年 1 月以降の日次で取得します。
| |
| value | |
|---|---|
| date | |
| 2017-01-02 | NaN |
| 2017-01-03 | 4.13 |
| 2017-01-04 | 4.02 |
| 2017-01-05 | 4.04 |
| 2017-01-06 | 3.98 |
S&P 500 を取得する #
ソース:https://fred.stlouisfed.org/series/SP500
比較対象の S&P 500 も get_fred_data("SP500") で取得します。FRED の SP500 は直近 10 年分だけ配信されている点に注意してください。
| |
| value | |
|---|---|
| date | |
| 2017-01-02 | NaN |
| 2017-01-03 | 2257.83 |
| 2017-01-04 | 2270.75 |
| 2017-01-05 | 2269.00 |
| 2017-01-06 | 2276.98 |
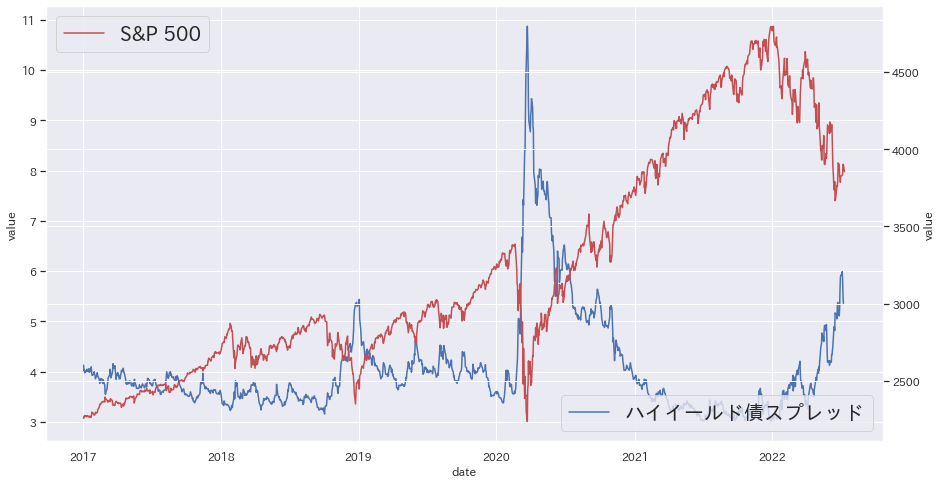
スプレッドを左軸、S&P 500 を右軸にして 1 枚に重ねます。
| |
<matplotlib.legend.Legend at 0x13735de10>
実行結果の読み方 #
青のスプレッドが跳ねた 2018 年 12 月と 2020 年 3 月に、赤の S&P 500 は大きく下げています。特に 2020 年 3 月はスプレッドが 10% 超まで広がった日とほぼ同じ日に株価が底を打っています。この「青の山」を機械的に拾うのが次の find_peaks です。
ピークを検出する #
ハイイールド債スプレッドのピーク #
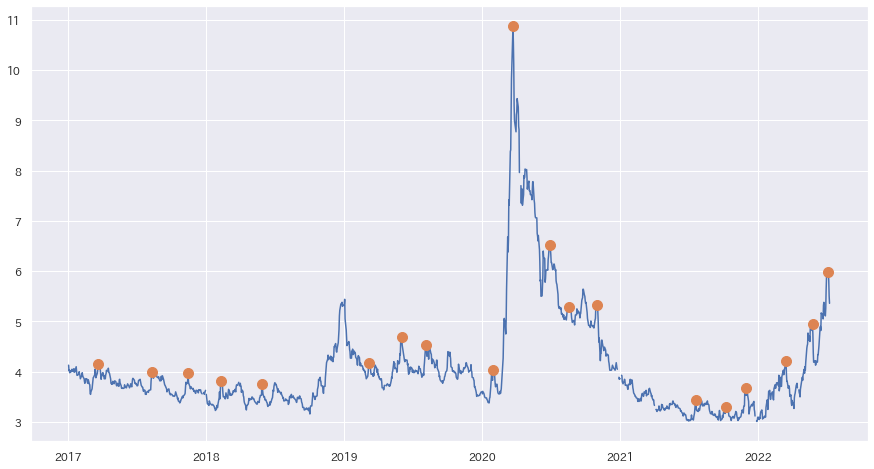
scipy.signal.find_peaks は、両隣より高い点をすべて候補にし、引数で与えた条件を満たすものだけを残して添字の配列で返します。
| |
実行結果の読み方 #
丸印は 2018 年 12 月末、2020 年 3 月下旬、2022 年前半などスプレッドの山の頂点に付いています。2020 年 3 月の急騰部分に丸が 1 つしか無いのは distance=30 の効果で、distance=5 にすると同じ山の中に複数の丸が並びます。
S&P 500 とハイイールド債のピークを比較する #
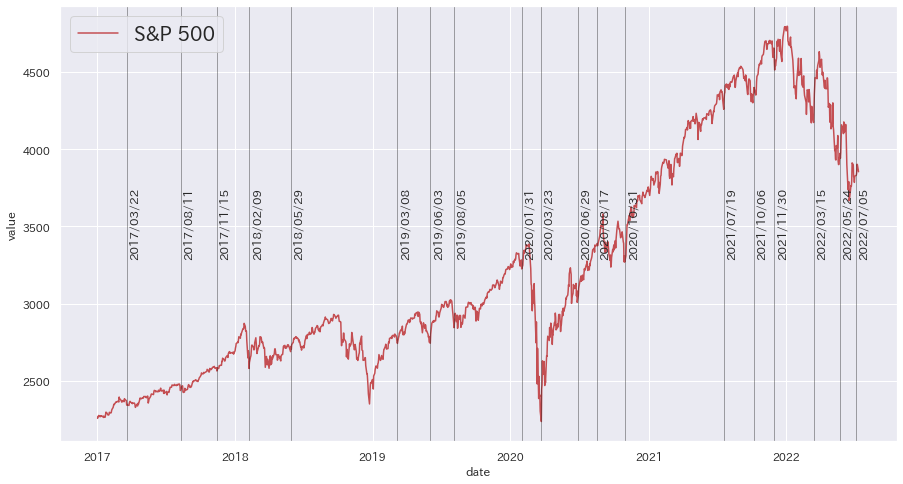
検出したピークの日付を S&P 500 の図に黒い縦線として引き、株価の底と重なるかを見ます。
| |
<matplotlib.legend.Legend at 0x136f9a020>
実行結果の読み方 #
2018/12 と 2020/03 の縦線は S&P 500 の谷底とほぼ一致しています。信用市場の不安が頂点を打った日が株価の底と重なる、という関係が 2 回の大きな下落で成り立っていることが分かります。一方で小さなピークの縦線は株価の小さな押し目に対応するだけで、スプレッドのピークがすべて買い場ではありません。
使いどころと落とし穴 #
find_peaks の distance と width は「点の数」で指定するので、日次データでの 30 は約 1.5 か月、月次データでは 2.5 年と意味が変わります。頻度を変えたら引数も見直してください。threshold は両隣との差だけを見るため、なだらかに上がって高い水準で揺れている山では弱く、「ベースラインからの高さ」で絞りたいときは prominence 引数のほうが適しています。ピークは「その後に下がった」ことが確定してから分かる後知恵の指標なので、リアルタイムの売買シグナルとして使うには、直近の点をピークと判定できない遅れがあることを前提にします。
まとめ #
ピーク検出は find_peaks(data, distance=30, threshold=0.03, width=3) の 1 行で、両隣より高い候補点を 3 つの条件で絞り込んで添字を返します。distance が近接する山を 1 つにまとめ、threshold が微小な凸を、width が 1 日だけの跳ねを除くので、ハイイールド債スプレッドの 1,300 点から数個の「不安の頂点」が残ります。その日付を axvline で S&P 500 に重ねると、2018 年 12 月と 2020 年 3 月の株価の底に縦線が立ち、信用市場のピークと株式市場の底が同時に来ることを図で確認できます。