05.1.10
季節調整
np.polyfit の 3 次曲線で長期の傾向変動を推定して引き、次に月別平均法(12 か月それぞれの平均を求め、合計が 1200 になるよう修正係数を掛ける)で季節変動を引きます。各ステップで折れ線がどう滑らかになるかを図で追い、最後に残った「季節変動調整分」を CSV に保存して 外れ値 のページで使います。読み終えると、変動を「傾向・循環・季節・不規則」の 4 つに分ける考え方と、そのうち 2 つを pandas だけで除く手順が身につきます。経済データの季節調整 #
総務省統計局の公開している「家計調査(家計収支編) 時系列データ(二人以上の世帯)」のデータを分析します。季節調整の手順は経済産業省が鉱工業指数で使っている方法の解説(季節調整手法)を参考にしています。
直感 #
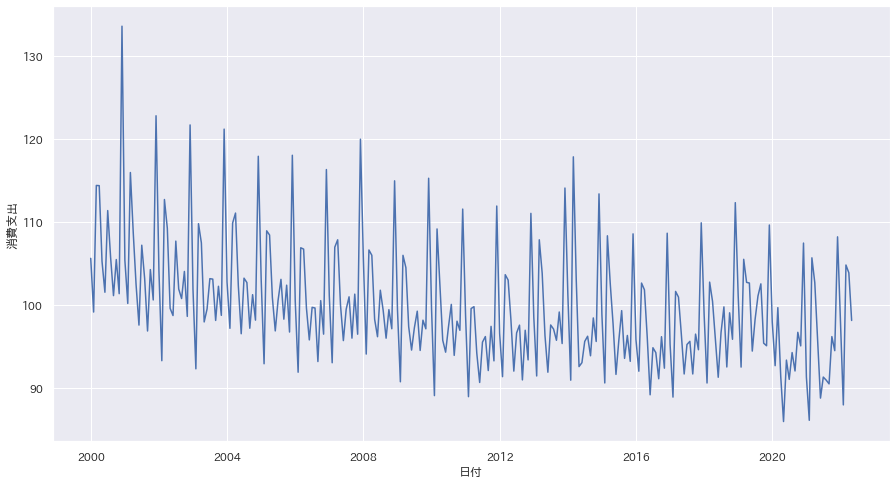
家計の消費支出は 12 月に年間平均の 15% ほど多く、2 月に 8% ほど少なくなります。これは毎年繰り返す「季節変動」で、景気が良くなったわけでも悪くなったわけでもありません。消費が本当に増えたかを見るには、この毎年のくせと、人口減少などによる長期的な「傾向変動」を引いて残りを見る必要があります。月別平均法は 22 年分のデータから「1 月の平均」「2 月の平均」…「12 月の平均」を 12 個求め、各月の値からその月の平均を引くだけの素朴な方法ですが、季節のくせがどれだけ大きいかを数値で確かめられます。
データの前処理 #
配布されている CSV は Excel の見た目を保った形で、空白のセルや複数行にまたがる見出しが含まれています。read_csv で読んだあと、14 行目の消費支出の行だけを切り取り、数値に変換した new_df を用意します。
| |
| 二人以上の世帯_支出金額[円] | Unnamed: 1 | Unnamed: 2 | Unnamed: 3 | Unnamed: 4 | Unnamed: 5 | 1 | 2 | 3 | 4 | ... | 260 | 261 | 262 | 263 | 264 | 265 | 266 | 267 | 268 | 269 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | NaN | NaN | NaN | NaN | NaN | NaN | 2000年 | NaN | NaN | NaN | ... | NaN | NaN | NaN | NaN | NaN | 2022年 | NaN | NaN | NaN | NaN |
| 1 | NaN | NaN | NaN | NaN | NaN | NaN | (平成12年) | NaN | NaN | NaN | ... | NaN | NaN | NaN | NaN | NaN | (令和4年) | NaN | NaN | NaN | NaN |
| 2 | 表側連番 | 階層 | 大分類 | 中分類 | 小分類 | 品目分類 | 1月 | 2月 | 3月 | 4月 | ... | 8月 | 9月 | 10月 | 11月 | 12月 | 1月 | 2月 | 3月 | 4月 | 5月 |
| 3 | 1 | - | - | - | - | 世帯数分布(抽出率調整) | 10000 | 10000 | 10000 | 10000 | ... | 10000 | 10000 | 10000 | 10000 | 10000 | 10000 | 10000 | 10000 | 10000 | 10000 |
| 4 | 2 | - | - | - | - | 集計世帯数 | 7887 | 7942 | 7934 | 7922 | ... | 7397 | 7378 | 7407 | 7411 | 7416 | 7353 | 7315 | 7369 | 7357 | 7391 |
| 5 | 3 | - | - | - | - | 世帯人員(人) | 3.32 | 3.32 | 3.32 | 3.32 | ... | 2.93 | 2.93 | 2.93 | 2.93 | 2.92 | 2.92 | 2.92 | 2.92 | 2.91 | 2.91 |
| 6 | 4 | - | - | - | - | 18歳未満人員(人) | 0.74 | 0.75 | 0.75 | 0.75 | ... | 0.55 | 0.56 | 0.56 | 0.55 | 0.55 | 0.55 | 0.55 | 0.54 | 0.55 | 0.55 |
| 7 | 5 | - | - | - | - | 65歳以上人員(人) | 0.52 | 0.53 | 0.53 | 0.52 | ... | 0.85 | 0.83 | 0.84 | 0.84 | 0.85 | 0.84 | 0.85 | 0.84 | 0.84 | 0.84 |
| 8 | 6 | - | - | - | - | うち無職者人員(人) | 0.41 | 0.41 | 0.41 | 0.41 | ... | 0.68 | 0.67 | 0.68 | 0.67 | 0.67 | 0.67 | 0.68 | 0.66 | 0.67 | 0.67 |
| 9 | 7 | - | - | - | - | 有業人員(人) | 1.51 | 1.51 | 1.51 | 1.52 | ... | 1.33 | 1.33 | 1.33 | 1.34 | 1.33 | 1.33 | 1.31 | 1.33 | 1.33 | 1.34 |
| 10 | 8 | - | - | - | - | 世帯主の年齢(歳) | 52.4 | 52.6 | 52.7 | 52.6 | ... | 60.1 | 59.9 | 59.9 | 59.9 | 60.2 | 60 | 60.2 | 60.1 | 60 | 60 |
| 11 | 9 | - | - | - | - | 持家率(%) | 76 | 76.3 | 76.2 | 75.8 | ... | 84.1 | 84.1 | 84.4 | 84.4 | 84.1 | 83.9 | 84 | 84.4 | 85 | 84.8 |
| 12 | 10 | - | - | - | - | 家賃・地代を支払っている世帯の割合(%) | 22.1 | 22 | 22.6 | 22.2 | ... | 14.9 | 14.6 | 13.9 | 14 | 14.8 | 14.6 | 14.9 | 13.8 | 13.4 | 13.8 |
| 13 | 11 | 1 | - | - | - | 消費支出 | 309621 | 290663 | 335341 | 335276 | ... | 266638 | 265306 | 281996 | 277029 | 317206 | 287801 | 257887 | 307261 | 304510 | 287687 |
| 14 | 12 | 2 | 1 | - | - | 食料 | 73580 | 73309 | 79726 | 77344 | ... | 81412 | 76673 | 79543 | 78490 | 99518 | 75974 | 71655 | 79982 | 77014 | 82066 |
15 rows × 275 columns
| |
| 消費支出 | |
|---|---|
| 日付 | |
| 2000-01-01 | 105.629546 |
| 2000-02-01 | 99.161881 |
| 2000-03-01 | 114.404119 |
| 2000-04-01 | 114.381944 |
| 2000-05-01 | 105.269625 |
| 2000-06-01 | 101.544867 |
| 2000-07-01 | 111.381122 |
| 2000-08-01 | 105.756457 |
| 2000-09-01 | 101.138548 |
| 2000-10-01 | 105.483531 |
データをプロットしてみる #
平均 100 に正規化した 消費支出 を lineplot で折れ線にして、季節のくせと長期の傾きを目で確かめます。
| |
傾向変動を取り除く #
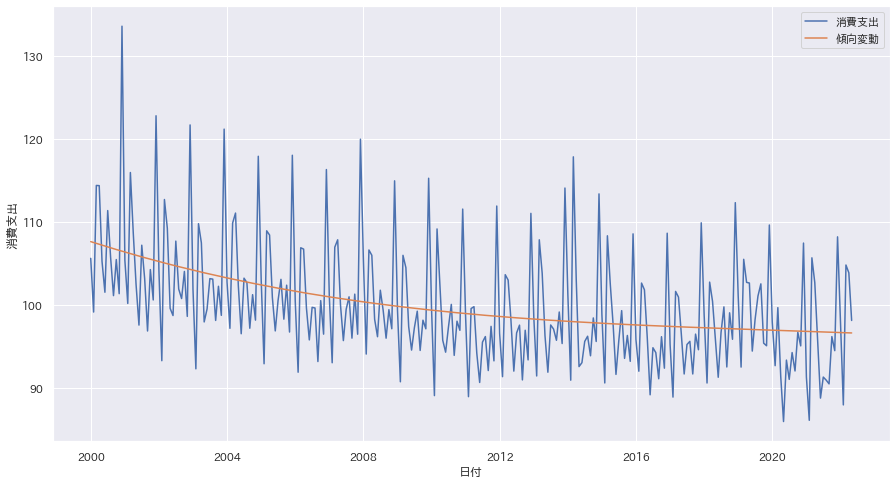
傾向変動は人口の増減や所得水準の変化による、10 年単位でゆっくり進む動きです。移動平均で滑らかにする方法と、最小二乗法で直線や曲線を当てる方法があり、ここでは np.polyfit で 3 次の多項式を当てます。
参考:numpy.polyfit — NumPy v1.23 Manual
| |
循環変動 #
在庫投資の増減で 3〜4 年周期に動く キチンサイクル など、数年周期の変動を循環変動と呼びます。このページでは取り除かず、季節変動調整分の中に残します。
季節変動を取り除く #
1 年を周期とする変動を「季節変動」と呼び、除き方には月別平均法と連環比率法があります。ここでは月別平均法を 4 つの手順で進めます。まず過去 22 年分の月別平均値を 12 個求め、次にその合計を出し、合計が 1200(= 100 × 12 か月)になるように修正係数を計算し、最後に修正係数を掛けた月別平均を各月の値から引きます。
① 過去の複数年の月別平均値を求める #
| |
月
1     100.083036
2      92.102619
3     107.280556
4     104.477264
5      97.832924
6      94.348753
7      98.973205
8      99.165835
9      95.138160
10     99.351828
11     96.230671
12    114.934402
Name: 消費支出, dtype: float64
② 月別平均値の合計を求める #
| |
月別平均値の合計 = 1199.9192545557726
③ 修正係数を計算する #
| |
修正係数 = 1.0000672923981517
④ 月別平均に修正係数を乗じる #
| |
| |
| |
実行結果の読み方 #
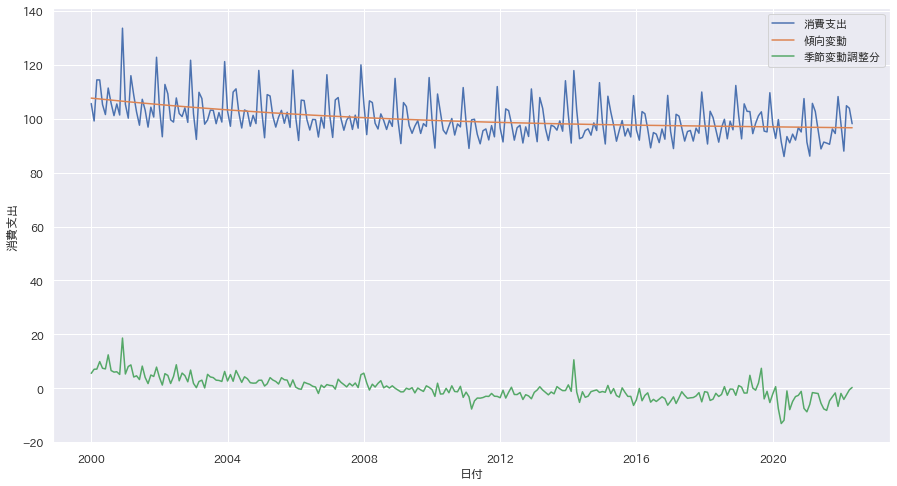
青の消費支出には毎年 12 月の山と 2 月の谷が並び、オレンジの傾向変動はその中心をゆるやかに下る 3 次曲線です。緑の季節変動調整分では毎年の山谷がほぼ消え、2014 年 3 月(消費増税前の駆け込み)と 2020 年 4〜5 月(外出自粛)の跳ねが孤立した動きとして残っています。季節のくせを引いた後に残る動きこそが「普段と違う月」であり、これを次のページで外れ値として検出します。
使いどころと落とし穴 #
月別平均法は「季節のくせが 22 年間ずっと同じ」と仮定しています。2000 年代と 2020 年代で 12 月の消費の増え方が変わっていれば、1 つの季節指数では前半か後半のどちらかで調整が過不足になります。公式統計で使われる X-12-ARIMA は季節指数を年ごとに変化させます。より正確な調整が必要なら statsmodels の x13_arima_analysis や seasonal_decompose(model="additive", period=12) に進んでください。polyfit の次数は 3 を使いましたが、new_df の期間を変えると適切な次数も変わるため、傾向線が季節の山谷を追い始めていないかを図で確認してから次数を決めてください。
まとめ #
季節調整の手順は 2 回の引き算です。消費支出を平均 100 の指数にした上で、np.polyfit(idx, y, 3) の 3 次曲線で傾向変動を、groupby("月").mean() に修正係数 1200 / 合計 を掛けた 12 個の季節指数で季節変動を、それぞれ引きました。2 月の 92 と 12 月の 115 という季節指数が「毎年のくせ」の大きさで、これを引いた季節変動調整分には消費増税やコロナ禍のような一時的な動きだけが残ります。残った系列は 支出金額_加工済みデータ.csv に保存してあり、外れ値 のページで異常検出の入力になります。