05.4.3
EDINET②
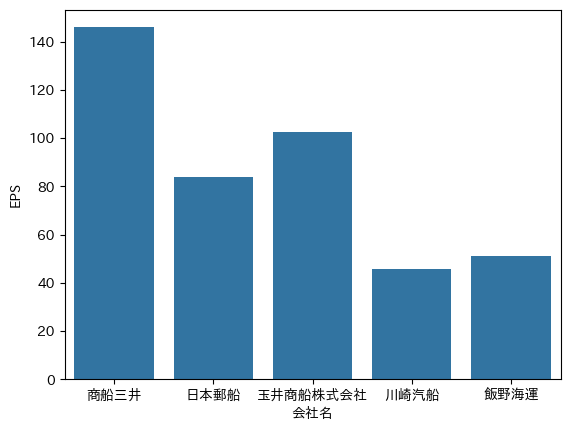
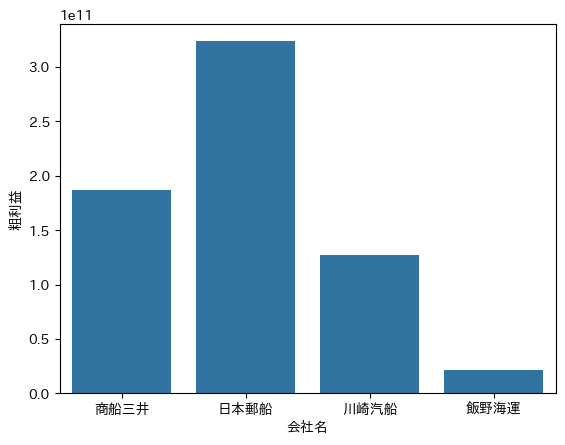
type=5 を付けて返る CSV(XBRL を表形式に変換したもの)か、type=1 の XBRL 本体を使います。このページでは商船三井・日本郵船・玉井商船・川崎汽船・飯野海運の 5 社の四半期報告書の docID を辞書にし、ZIP をダウンロードして展開する関数 save_csv() で CSV を集め、要素ID(jpcrp_cor:BasicEarningsLossPerShareSummaryOfBusinessResults など)と コンテキストID(CurrentQuarterDuration など)で絞った値を seaborn.barplot で 5 社並べます。後半では edinet_xbrl ライブラリで XBRL を直接読み、Prior4YearDuration から CurrentYearDuration までの 5 年分の 1 株配当を棒グラフにします。読み終えると、EDINET の CSV の「要素 ID × コンテキスト ID で 1 つの値が決まる」構造が分かり、欲しい財務項目を名前で取り出せるようになります。直感 #
四半期報告書の CSV は、損益計算書のような「表」ではなく、「どの項目(要素 ID)の、どの期間(コンテキスト ID)の値はいくら」という 3 つ組が 1 行ずつ縦に並んだ形で届きます。たとえば EPS なら要素 ID が jpcrp_cor:BasicEarningsLossPerShareSummaryOfBusinessResults、当四半期なら コンテキスト ID が CurrentQuarterDuration で、この 2 つを指定すると値が 1 つに決まります。5 社の CSV を縦に積んで 会社名 列を付けておけば、同じ 2 つの条件で絞るだけで 5 社分の EPS が並び、棒グラフにできます。XBRL ファイルを直接読む場合も考え方は同じで、get_data_by_context_ref(要素ID, コンテキストID) で 1 つの値を取ります。
以下のコンテンツでは EDINET閲覧サイト から取得できる情報をもとにデータを加工して作成しています。コードの実行や取得したデータの利用については EDINET の利用規約を確認し理解した上で行ってください。Version 2 の API はログイン認証と API キーの発行が必要で、キーは環境変数 EDINET_API_KEY に置いています。
| |
書類取得 API で 5 社の CSV を取る #
EDINET のページと同じ手順で調べた 5 社の四半期報告書の docID を辞書にし、save_csv で 1 社ずつ CSV の ZIP を取得して展開します。
| |
S100STH6のcsvデータを取得中
S100SS7Pのcsvデータを取得中
S100STLSのcsvデータを取得中
S100SRTIのcsvデータを取得中
S100SP9Oのcsvデータを取得中
取得したデータの確認 #
展開先の XBRL_TO_CSV フォルダには複数の CSV が入っています。企業内容等の開示に関する jpcrp で始まるファイルを読み、会社名の列を足して 5 社分を縦に積みます。
| |
| 要素ID | 項目名 | コンテキストID | 相対年度 | 連結・個別 | 期間・時点 | ユニットID | 単位 | 値 | 会社名 | |
|---|---|---|---|---|---|---|---|---|---|---|
| 0 | jpdei_cor:NumberOfSubmissionDEI | 提出回数、DEI | FilingDateInstant | 提出日時点 | その他 | 時点 | pure | NaN | 1 | 商船三井 |
| 1 | jpcrp_cor:NetSalesSummaryOfBusinessResults | 売上高、経営指標等 | Prior1YTDDuration | 前年度同四半期累計期間 | その他 | 期間 | JPY | 円 | 1257968000000 | 商船三井 |
| 2 | jpcrp_cor:NetSalesSummaryOfBusinessResults | 売上高、経営指標等 | CurrentYTDDuration | 当四半期累計期間 | その他 | 期間 | JPY | 円 | 1218664000000 | 商船三井 |
| 3 | jpcrp_cor:NetSalesSummaryOfBusinessResults | 売上高、経営指標等 | Prior1YearDuration | 前期 | その他 | 期間 | JPY | 円 | 1611984000000 | 商船三井 |
| 4 | jpcrp_cor:OrdinaryIncomeLossSummaryOfBusinessR... | 経常利益又は経常損失(△)、経営指標等 | Prior1YTDDuration | 前年度同四半期累計期間 | その他 | 期間 | JPY | 円 | 739254000000 | 商船三井 |
要素 ID で 1 項目を取り出してみる #
項目の名前(要素 ID)は EDINET タクソノミ の概要説明 に一覧があります。まず配当に関する注記 jpcrp_cor:NotesRegardingDividendTextBlock を抽出して、5 社の値がどう入っているかを見ます。
| |
          会社名                                                  値
462      商船三井  1.配当金支払額(決議)株式の種類配当金の総額(百万円)1株当たり配当額(円)基準日効力発生...
463      商船三井  1.配当金支払額(決議)株式の種類配当金の総額(百万円)1株当たり配当額(円)基準日効力発生...
431      日本郵船  配当金支払額(決議)株式の種類配当金の総額(百万円)配当の原資1株当たり配当額(円)基準日効...
432      日本郵船  配当金支払額(決議)株式の種類配当金の総額(百万円)配当の原資1株当たり配当額(円)基準日効...
334  玉井商船株式会社  前第3四半期連結累計期間(自 2022年4月1日 至 2022年12月31日)1.配当金支払...
335  玉井商船株式会社  当第3四半期連結累計期間(自 2023年4月1日 至 2023年12月31日)1.配当金支払...
380      川崎汽船  1.配当金支払額(決議)株式の種類配当金の総額(百万円)1株当たり配当額(円)基準日効力発生...
382      川崎汽船  1.配当金支払額(決議)株式の種類配当金の総額(百万円)1株当たり配当額(円)基準日効力発生...
385      飯野海運  1 配当金支払額(決議)株式の種類配当金の総額(百万円)1株当たり配当額(円)基準日効力発生...
386      飯野海運  1 配当金支払額(決議)株式の種類配当金の総額(百万円)1株当たり配当額(円)基準日効力発生...
5 社の EPS と粗利益を棒グラフで比べる #
1 株当たり当期純利益(EPS)と粗利益を、要素 ID とコンテキスト ID の 2 条件で絞って 5 社分並べます。
| |
XBRL ファイルからデータを取得する #
CSV は四半期報告書に含まれる期間しか持ちませんが、XBRL 本体には「主要な経営指標等の推移」として過去 5 年分の値が入っています。pip install edinet-xbrl でライブラリを入れ、XBRL を直接読みます。参考文献:EDINETのXBRL用のPythonライブラリを作った - Parser編
値を取るときはコンテキスト ID で時期を指定します。Duration は期間(売上や利益など)、Instant は時点(総資産など)を表し、以下の __NUM__ には 0〜9 が入ります(ドキュメント)。
Prior__NUM__YearDuration
CurrentYearDuration
Prior__NUM__YearInstant
CurrentYearInstant
CurrentQuarterDuration
CurrentQuarterInstant
Prior__NUM__QuarterDuration
Prior__NUM__QuarterInstant
CurrentYTDDuration
Prior__NUM__YTDDuration
InterimDuration
InterimInstant
Prior__NUM__InterimDuration
Prior__NUM__InterimInstant
| |
S100STH6のXBRLデータを取得中
S100SS7PのXBRLデータを取得中
S100STLSのXBRLデータを取得中
S100SRTIのXBRLデータを取得中
S100SP9OのXBRLデータを取得中
| |
c:\Users\nanja-win-ms\miniconda3\envs\py39\lib\site-packages\bs4\builder\__init__.py:545: XMLParsedAsHTMLWarning: It looks like you're parsing an XML document using an HTML parser. If this really is an HTML document (maybe it's XHTML?), you can ignore or filter this warning. If it's XML, you should know that using an XML parser will be more reliable. To parse this document as XML, make sure you have the lxml package installed, and pass the keyword argument `features="xml"` into the BeautifulSoup constructor.
  warnings.warn(


'2686701000000'
配当の推移 #
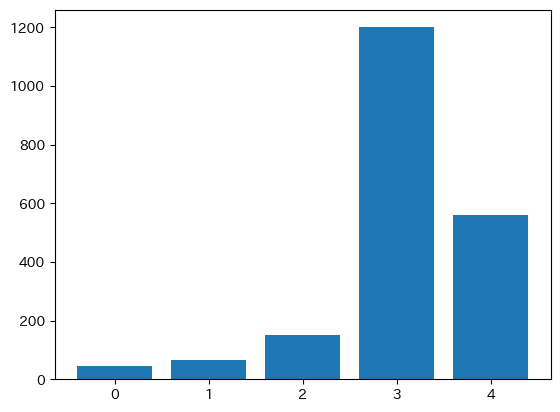
1 株当たり配当額(DividendPaidPerShareSummaryOfBusinessResults)を、4 年前から当年までの 5 つのコンテキスト ID で取り出して棒グラフにします。
| |
<BarContainer object of 5 artists>
実行結果の読み方 #
5 本の棒が左(4 年前)から右(当年)へ並び、海運市況が好転した 2021〜2022 年度に配当が大きく増えた様子が読めます。1 社の有価証券報告書 1 ファイルで 5 年分が揃うのは、XBRL に「主要な経営指標等の推移」の表が含まれているためで、CSV 版の四半期報告書では当期と前年同期の 2 期分しか取れません。
使いどころと落とし穴 #
CSV の 値 列は数値も文章もすべて文字列で、TextBlock で終わる要素は HTML を含む長文なので、数値として扱う前に pd.to_numeric が必要です。同じ要素 ID でもコンテキスト ID が違えば別の行です。query で両方を条件にしないと barplot が複数期の平均を描いてしまいます。配当のように単体で支払う項目は _NonConsolidatedMember 付きのコンテキストにしか値が無く、連結のコンテキストを指定すると None が返ります。csvFlag が 0 の古い書類には CSV が無いので、2020 年以前の書類を集めるなら XBRL(type=1)を使います。
まとめ #
EDINET の数値データは「要素 ID × コンテキスト ID → 値」の 3 つ組で届きます。CSV なら save_csv(docID, type=5) で取って query("要素ID==... and コンテキストID==...") で絞り、XBRL なら type=1 で取って get_data_by_context_ref(key, context_ref).get_value() で読む、という 2 通りの入口があり、どちらも同じ ID の組み合わせで値を指定します。5 社の EPS・粗利益の比較には会社名列を付けて concat した CSV が、1 社の 5 年分の配当推移には有価証券報告書の XBRL が向いています。