05.4.1
投資信託
pd.merge で 1 つの表にし、pypfopt の mean_historical_return で期待リターン、sample_cov で共分散行列を求め、EfficientFrontier(mu, S).max_sharpe() でシャープレシオ最大の配分を計算します。CLA と plotting.plot_efficient_frontier で曲線と各ファンドの位置を描き、最後に diff().corr() のヒートマップで純金が株式ファンドと相関が低いことを確かめます。読み終えると、過去の価格系列から「期待リターン・共分散 → 最適配分」を出す手順が 10 行程度で書けるようになります。直感 #
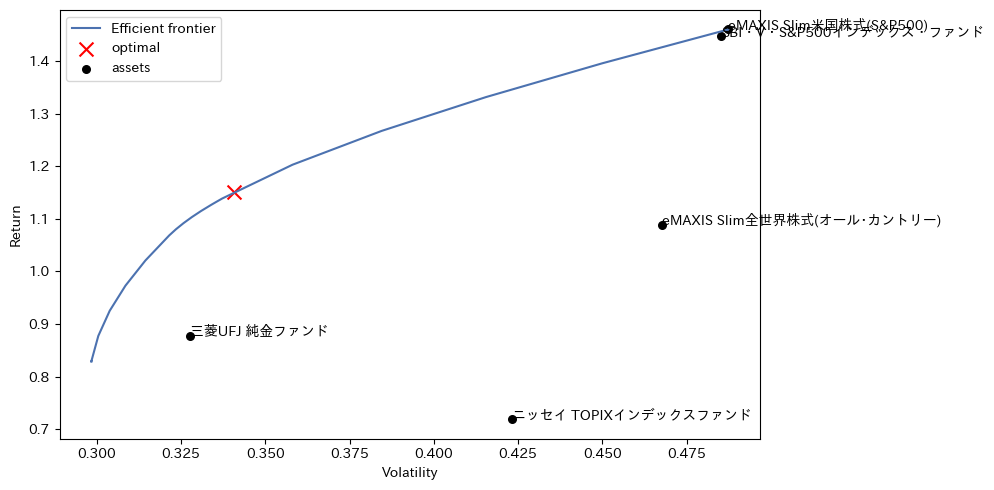
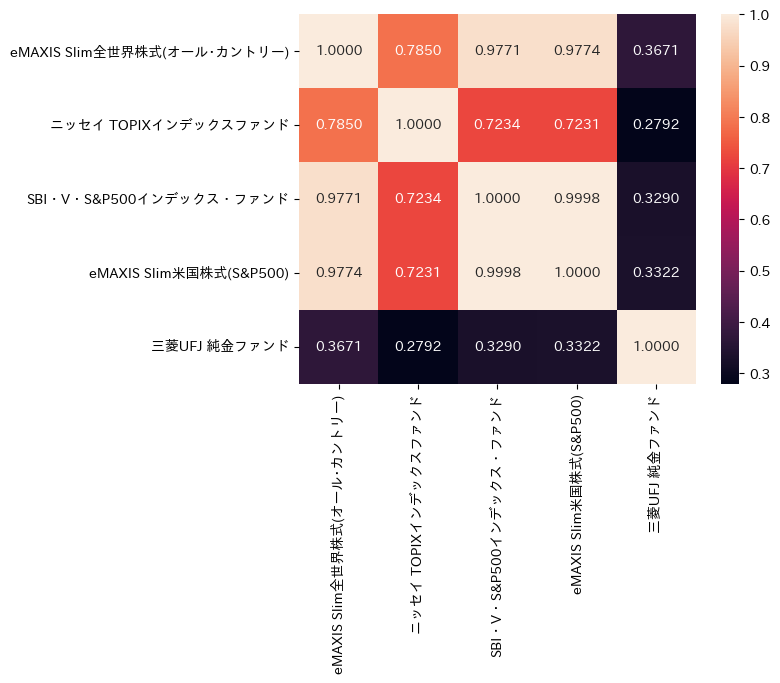
株式ファンドを 4 本持っていても、どれも世界の株価と一緒に上下するなら「分散」にはなりません。値動きの相関が低い資産(ここでは相関 0.2 前後の純金)を混ぜると、片方が下がるときに他方が支えて全体の揺れが小さくなります。効率的フロンティアは、5 本の配分比率をあらゆる組み合わせで試し、「このリスクなら最大でこのリターン」という上限を曲線にしたものです。その曲線上で、リターンをリスクで割ったシャープレシオが最大になる 1 点が max_sharpe() の答えで、pypfopt は過去の価格から期待リターンと共分散を見積もり、その最適化を凸計画問題として解きます。
投資信託で効率的フロンティアを計算してみる #
比較に使うファンドは次の 5 本(コードは WEALTH ADVISER のファンド ID)です。全世界株式 2018103105(eMAXIS Slim 全世界株式オール・カントリー)、国内株式 2015042708(ニッセイ TOPIX インデックスファンド)、米国株式 2019092601(SBI・V・S&P500 インデックス・ファンド)と 2018070301(eMAXIS Slim 米国株式 S&P500)、そして株式と値動きの異なる参考として 2011020701(三菱UFJ 純金ファンド)を加えています。各ファンドのページは https://www.wealthadvisor.co.jp/FundData/SnapShot.do?fnc=<ファンドID> で開けます。
データの読み込み #
WEALTH ADVISER から手動で保存した週次の基準価額 CSV を、ファンド ID ごとのフォルダから読み込みます。
| |
データの整形 #
行 = 日付、列 = ファンド名の 1 つの表に結合します。pypfopt はこの「価格の表」を入力にするので、投資信託でなく株式の終値でも同じ形にすれば使えます。
| |
| eMAXIS Slim全世界株式(オール・カントリー) | ニッセイ TOPIXインデックスファンド | SBI・V・S&P500インデックス・ファンド | eMAXIS Slim米国株式(S&P500) | 三菱UFJ 純金ファンド | |
|---|---|---|---|---|---|
| 日付 | |||||
| 2020-01-10 | 11828 | 11720 | 11203 | 12185 | 13827 |
| 2020-01-17 | 12036 | 11723 | 11429 | 12428 | 14063 |
| 2020-01-24 | 11932 | 11689 | 11381 | 12378 | 14008 |
| 2020-01-31 | 11667 | 11379 | 11189 | 12168 | 14085 |
| 2020-02-07 | 11987 | 11703 | 11490 | 12496 | 14242 |
| ... | ... | ... | ... | ... | ... |
| 2023-12-29 | 20899 | 17484 | 22229 | 24281 | 23054 |
| 2024-01-05 | 20972 | 17684 | 22285 | 24342 | 23270 |
| 2024-01-12 | 21283 | 18428 | 22763 | 24871 | 23226 |
| 2024-01-19 | 21536 | 18543 | 23219 | 25369 | 23562 |
| 2024-01-26 | 21916 | 18450 | 23699 | 25888 | 23437 |
212 rows × 5 columns
可視化 #
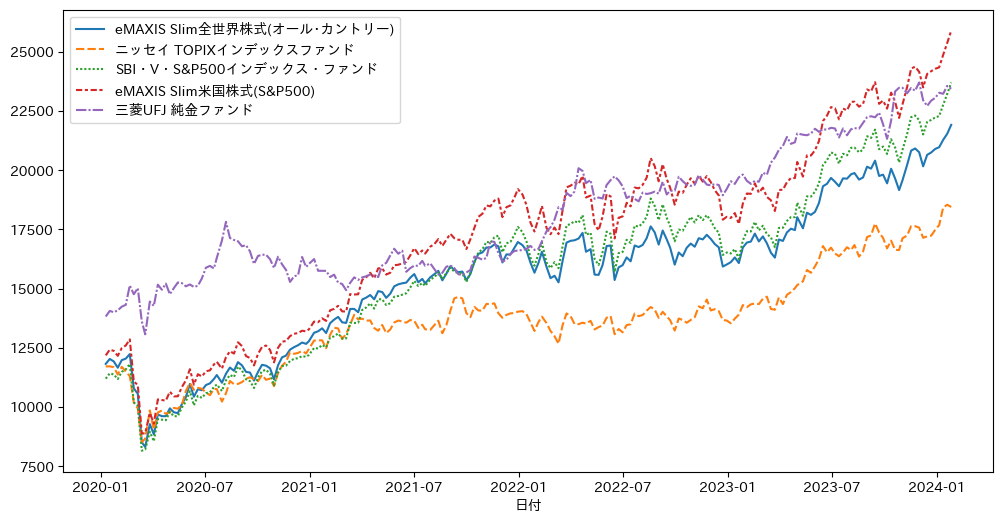
5 本の基準価額を 1 枚に重ね、値動きの向きと大きさを目で確かめます。
| |
<Axes: xlabel='日付'>
| |
Expected annual return: 115.5%
Annual volatility: 34.2%
Sharpe Ratio: 3.32


(1.1546507705298557, 0.34188826020611157, 3.318776637272708)
| |
Expected annual return: 115.1%
Annual volatility: 34.1%
Sharpe Ratio: 3.32


<Axes: xlabel='Volatility', ylabel='Return'>
実行結果の読み方 #
曲線の左下から右上へ、リスクを取るほどリターンが上がる効率的フロンティアが描かれ、各ファンドの位置が点で示されます。純金ファンドは左寄り(低リスク)、S&P 500 の 2 本は右上(高リスク・高リターン)に位置し、最大シャープの配分がこの間を結ぶ曲線上の 1 点として選ばれています。S&P 500 連動の 2 本はほぼ同じ場所に重なり、同じ指数に連動するファンドを 2 本持っても分散効果が無いことが点の重なりから分かります。
値動きの相関 #
基準価額そのものではなく週ごとの変化量 diff() で相関を計算し、どのファンド同士が一緒に動くかをヒートマップで見ます。
| |
<Axes: >
使いどころと落とし穴 #
mean_historical_return は「過去 4 年の平均リターンが将来も続く」と仮定するので、2020〜2024 年の株高だけを入力にした年率 115% やシャープ 3.32 は、そのまま将来の期待値として受け取れません。期間を 10 年以上にする、expected_returns.ema_historical_return で直近に重みを付ける、risk_models.CovarianceShrinkage(prices).ledoit_wolf() で共分散の推定誤差を抑える、といった選択肢を比べるのが実務的です。max_sharpe() は入力のわずかな違いで配分が大きく変わる(1 本に 100% 寄ることも多い)ため、ef.add_objective(objective_functions.L2_reg) で配分を分散させる正則化を加えるか、weight_bounds=(0, 0.4) で 1 本の上限を決めると安定します。pd.merge の内部結合で期間が最も短いファンドに揃うため、設定日の新しいファンドを混ぜるとデータが数年分しか残らない点にも注意してください。
まとめ #
効率的フロンティアの計算は、価格の表から mean_historical_return で期待リターン、sample_cov で共分散を求め、EfficientFrontier(mu, S).max_sharpe() に渡すだけで配分と年率リターン・ボラティリティ・シャープレシオが出ます。CLA と plotting.plot_efficient_frontier で曲線を描けば、単独のファンドがすべて曲線の内側にあること、純金のような相関の低い資産が曲線を左に押し出していることが見えます。年率 115% のような数値は入力期間の相場をそのまま反映するので、期間や ledoit_wolf などの推定方法を変えて配分がどれだけ動くかを確認してから使ってください。