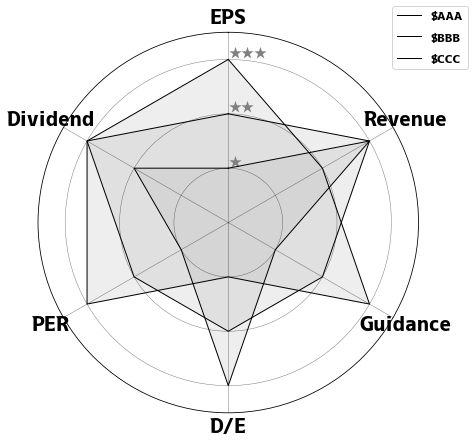
まとめ レーダーチャートは、EPS・売上・配当のような複数の指標を正多角形の頂点に 1 つずつ割り当て、各銘柄の値を結んだ多角形の形と大きさで総合力を比べる図です。このページでは 3 銘柄($AAA・$BBB・$CCC)の 6 指標を 1〜3 のスコアにした DataFrame を用意し、matplotlib の polar=True な軸に set_theta_offset(pi / 2.0) と set_theta_direction(-1) を指定して、12 時の位置から時計回りに頂点を並べます。多角形の面積を radar_area() で計算すると、「見た目で大きい」を数値のランキングに変えられます。読み終えると、D/E レシオのような「低いほど良い」指標の向きを揃える理由と、軸の始点を 0 にしないと差が誇張される仕組みが分かります。
直感
# 成績表の「国語 3・数学 2・英語 3」のように評点がいくつか並んだとき、全体のバランスを 1 枚で見るならレーダーチャートです。国語・数学・英語の 3 教科を円周上の頂点に置き、点数の分だけ中心から外に向かって打った点を線で結びます。全科目が高い人は大きな正多角形に、1 科目だけ高い人はとがった形になります。財務分析では、EPS・売上成長率・配当利回り・負債比率など異なる次元の指標を1つのグラフで俯瞰できるため、銘柄選定や競合比較のスクリーニングに活用されます。
すべての項目を「高ければ高いほど良い」状態に統一するのがポイントです。たとえばD/Eレシオ(負債比率)は低いほど良いため、逆数やランキングに変換してからプロットします。このページのサンプルでも、D/E の列は「負債が少ない銘柄ほど 3」になるようスコア化してあります。
6 指標を 1〜3 のスコアにした DataFrame →
指標ごとに角度 2πn/6 を割り当てる →
polar 軸で 12 時から時計回りに並べる →
銘柄ごとに値を結んで閉じた多角形を描く →
塗りつぶしと凡例 →
多角形の面積で総合スコア
詳細な解説
# サンプルデータの準備
# 3銘柄の財務指標をスコア化(1〜3の評価)したデータを作成します。行が銘柄、列が指標の 3 × 6 の表で、df.columns がそのまま頂点のラベルに、df.loc[銘柄] の 6 つの値が多角形の頂点の距離になります。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
import numpy as np
import matplotlib.pyplot as plt
import pandas as pd
from math import pi
df = pd . DataFrame (
index = [ "$AAA" , "$BBB" , "$CCC" ],
data = {
"EPS" : [ 1 , 2 , 3 ],
"Revenue" : [ 3 , 3 , 2 ],
"Guidance" : [ 1 , 2 , 3 ],
"D/E" : [ 3 , 2 , 1 ],
"PER" : [ 1 , 2 , 3 ],
"Dividend" : [ 2 , 3 , 3 ],
},
)
print ( df )
レーダーチャートのプロット
# matplotlibの極座標プロット(polar=True)を使い、各指標を正多角形の頂点に配置します。角度の 0 を 12 時の位置に動かし、時計回りに進むよう設定してから、3 銘柄の多角形を黒線と灰色の塗りで重ねます。matplotlib.projections と set_theta_offset(offset) の公式ドキュメントが、極座標軸の引数の一覧です。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
plt . figure ( figsize = ( 7 , 7 ))
ax = plt . subplot ( 111 , polar = True )
ax . set_theta_offset ( pi / 2.0 )
ax . set_theta_direction ( - 1 )
# 各ラベルの位置調整
angles = [ 2 * n * pi / len ( df . columns ) for n in range ( len (( df . columns )))]
plt . xticks ( angles , df . columns , size = 20 )
ax . set_rlabel_position ( 0 )
plt . yticks ([ 1 , 2 , 3 ], [ "★" , "★★" , "★★★" ], color = "grey" , size = 13 )
plt . ylim ( 0 , 3.5 )
# 指定範囲の塗りつぶし
for ticker_symbol in [ "$AAA" , "$BBB" , "$CCC" ]:
values = df . loc [ ticker_symbol ] . values . flatten () . tolist ()
ax . plot (
angles + [ 0 ],
values + [ values [ 0 ]],
linewidth = 1 ,
linestyle = "solid" ,
c = "#000" ,
label = ticker_symbol ,
)
ax . fill ( angles + [ 0 ], values + [ values [ 0 ]], "#aaa" , alpha = 0.2 )
plt . legend ( bbox_to_anchor = ( 0.9 , 1.1 ))
plt . show ()
銘柄ごとに色分けする改良版
# 銘柄ごとに青・緑・橙の 3 色で塗り分けると、$CCC が EPS と PER で、$BBB が Dividend で優位、という指標ごとの差が追えます。前のブロックで計算した angles を再利用し、df.iterrows() で 1 行ずつ色を割り当てて描き直します。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
colors = [ "#3b82f6" , "#10b981" , "#f59e0b" ]
fig , ax = plt . subplots ( figsize = ( 7 , 7 ), subplot_kw = { "polar" : True })
ax . set_theta_offset ( pi / 2.0 )
ax . set_theta_direction ( - 1 )
ax . set_rlabel_position ( 0 )
plt . xticks ( angles , df . columns , size = 16 )
plt . yticks ([ 1 , 2 , 3 ], [ "1" , "2" , "3" ], color = "grey" , size = 11 )
plt . ylim ( 0 , 3.5 )
for ( ticker , row ), color in zip ( df . iterrows (), colors ):
values = row . values . flatten () . tolist ()
ax . plot ( angles + [ 0 ], values + [ values [ 0 ]], linewidth = 2 , color = color , label = ticker )
ax . fill ( angles + [ 0 ], values + [ values [ 0 ]], color = color , alpha = 0.15 )
plt . legend ( loc = "upper right" , bbox_to_anchor = ( 1.15 , 1.1 ))
plt . title ( "銘柄別 財務スコア比較" , y = 1.08 , fontsize = 14 )
plt . show ()
総合スコアの算出
# レーダーチャートの面積に相当する総合スコアを数値化すると、ランキングの根拠を定量的に示せます。隣り合う 2 頂点と中心が作る三角形の面積 \(\frac{1}{2} r_i r_{i+1} \sin\theta\) を 6 つ足し合わせたものが多角形の面積です。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
def radar_area ( values : list ) -> float :
"""レーダーチャートの多角形面積を計算"""
n = len ( values )
theta = 2 * pi / n
area = 0.5 * sum (
values [ i ] * values [( i + 1 ) % n ] * np . sin ( theta )
for i in range ( n )
)
return abs ( area )
for ticker in df . index :
vals = df . loc [ ticker ] . values . tolist ()
print ( f " { ticker } : 総合スコア(面積) = { radar_area ( vals ) : .2f } " )
使いどころと落とし穴
# 指標のスケールが異なる場合(EPS: 0〜10、PER: 5〜30など)は、Min-Max正規化やパーセンタイルランクで0〜1に揃えてからプロットします。揃えないと PER の軸だけが外に突き出し、面積のほとんどを PER が占めてしまいます。「低いほど良い」指標(PER、D/Eレシオなど)は、値を反転させるかランキングに変換して方向を統一します。最も確実なのは、このページの D/E 列のようにスコア化の段階で「3 が最良」に揃えることです。
銘柄数が 5 を超えると線が重なってレーダーチャートが見づらくなるため、4銘柄程度までに絞るか、subplots(1, 4, subplot_kw={"polar": True}) で銘柄ごとに分割します。セクター平均を灰色の点線でベースラインとして描き加えると、「平均より外に出ている頂点」として各銘柄の相対的な強みがより明確になります。
学習ナビ
PHASE 4 · 応用・展開
読んだページに印をつけると、トップページとセクション一覧に進み具合が表示されます(ブラウザ内にのみ保存)。