Stacking mengacu pada model yang mengulangi proses “membuat beberapa model prediktif dan memasukkan outputnya ke dalam model prediktif lainnya. Pada halaman ini, kita akan menjalankan penumpukan dan melihat model mana yang valid untuk tahap pertama penumpukan.
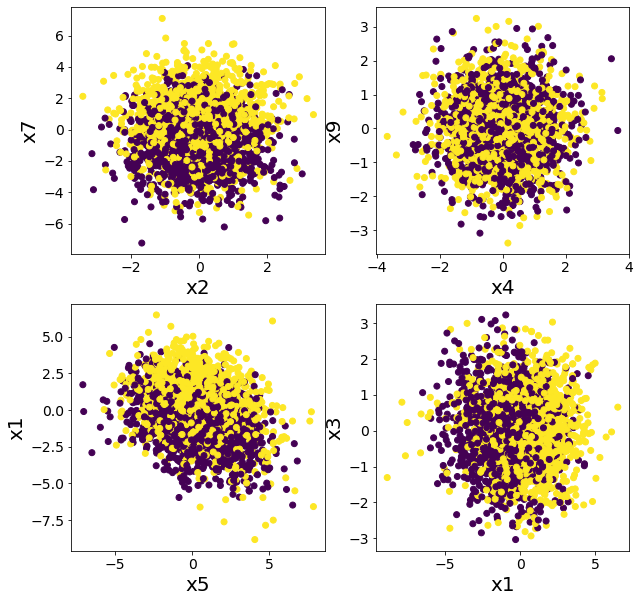
Pastikan untuk memvisualisasikan data menggunakan berbagai fitur agar mendapatkan wawasan tentang distribusi dan pola. Berikut adalah langkah-langkah untuk memplot data:
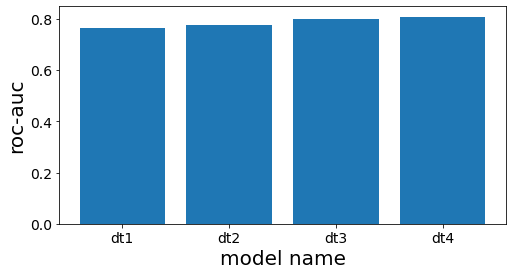
Ketika menggunakan stacking dengan hanya DecisionTreeClassifier, hasilnya sering kali tidak menunjukkan peningkatan akurasi yang signifikan. Hal ini karena beberapa keterbatasan:
# Model yang Digunakan dalam Base Learnerestimators=[("dt1",DecisionTreeClassifier(max_depth=3,random_state=777)),("dt2",DecisionTreeClassifier(max_depth=4,random_state=777)),("dt3",DecisionTreeClassifier(max_depth=5,random_state=777)),("dt4",DecisionTreeClassifier(max_depth=6,random_state=777)),]# Jumlah Model dalam Base Learnern_estimators=len(estimators)# Model Agregasifinal_estimator=DecisionTreeClassifier(max_depth=3,random_state=777)# Melatih Base Learner dan Model Agregasiclf=StackingClassifier(estimators=estimators,final_estimator=final_estimator)clf.fit(X_train,y_train)# Evaluasiy_pred=clf.predict(X_test)clf_score=roc_auc_score(y_test,y_pred)print("ROC-AUC")print(f"Decision Tree Stacking={clf_score}, Random Forest={rf_score}")
ROC-AUC
Decision Tree Stacking=0.7359716965608031, Random Forest=0.855797033310609
Analisis Feature Importance pada Pohon dalam Stacking
#
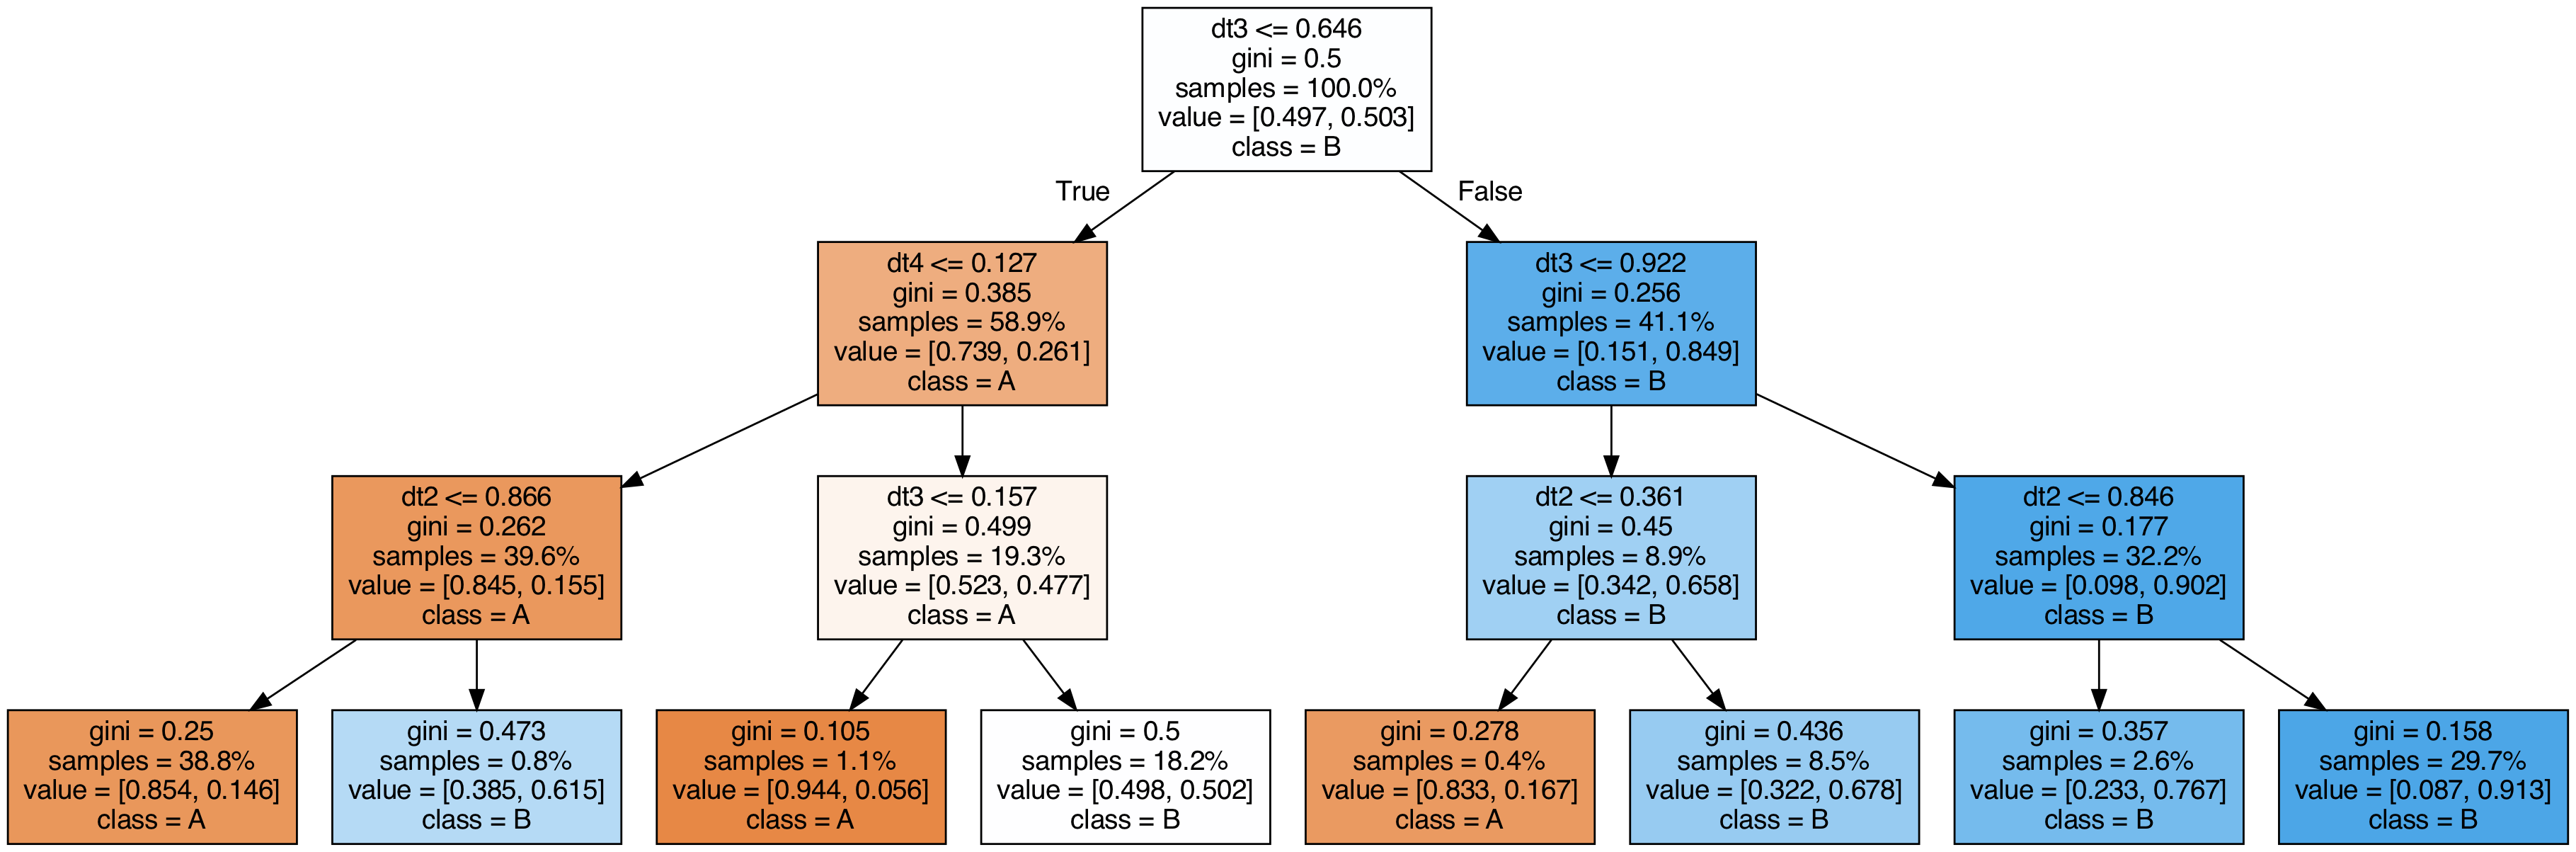
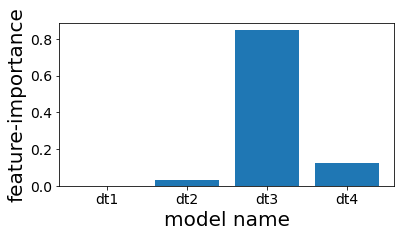
Ketika menganalisis feature importance dari pohon-pohon keputusan yang digunakan dalam stacking, kita dapat melihat bagaimana setiap pohon dasar berkontribusi pada prediksi akhir. Dalam beberapa kasus, meskipun stacking digunakan, prediksi akhir dapat sangat dipengaruhi oleh satu pohon tertentu.