01.3.2
Box-Cox変換
scipy.stats.boxcox_normmax が「変換後がいちばん正規分布らしくなる値」を最尤推定で返し、scipy.stats.boxcox(x, lmbda=...) がその値で変換します。このページでは対数正規乱数 1,000 点のヒストグラムが変換前後でどう変わるかを見て、\(\lambda\) を学習データで決めて検証データにも同じ値を使う理由を確認します。入力に 0 や負の値が含まれるときは Box-Cox が使えないので、次ページの Yeo-Johnson 変換 に切り替えます。直感 #
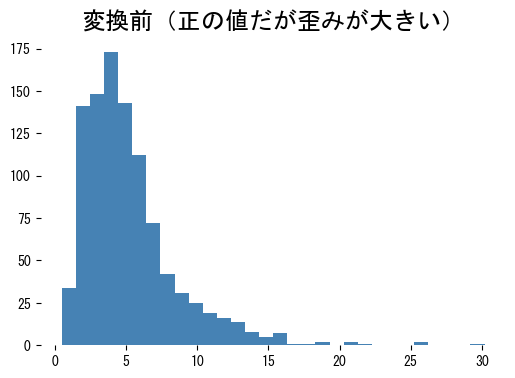
年収や商品の売上のヒストグラムを描くと、多くの人が左側に集まり、一部の大きな値が右に長い裾を作ります。平均はその少数の大きな値に引っぱられ、線形回帰や k-means のように平均と分散を前提にする手法は右端の数点に支配されます。対数を取ると 1,000 万と 100 万の差が「1 桁」という同じ幅に縮むので、山が左右対称に近づきます。Box-Cox 変換は「対数より弱く曲げる(\(\lambda = 0.5\) なら平方根)」から「対数そのもの(\(\lambda = 0\))」まで、曲げる強さを \(\lambda\) 1 つで連続的に選べるようにした手法で、boxcox_normmax がデータに合った強さを自動で探します。
式で見ると λ が何を変えているか #
正の観測値 \(x > 0\) とパラメーター \(\lambda\) に対して Box-Cox 変換 \(T_\lambda(x)\) は
$$ T_\lambda(x) = \begin{cases} \dfrac{x^\lambda - 1}{\lambda}, & \lambda \ne 0,\\\\ \log x, & \lambda = 0. \end{cases} $$です。\(\lambda = 1\) なら \(x - 1\) で形は変わらず、\(\lambda\) を 1 から 0 へ小さくするほど大きな値が強く圧縮され、\(\lambda = 0\) で自然対数になります。\(\lambda\) を負にすると対数よりさらに強く縮めます。\(-1\) を引いて \(\lambda\) で割っているのは、\(\lambda \to 0\) のときに式が \(\log x\) に滑らかにつながるようにするためです。逆変換は scipy.special.inv_boxcox に同じ lmbda を渡せば得られ、\(\lambda\) の最尤推定は scipy.stats.boxcox_normmax が返します。式に \(x^\lambda\) と \(\log x\) が含まれるため入力は正の値に限られ、0 を含むデータでは x + 1 のように小さな正の定数を足してから使います。
何が起きているか(ステップで見る) #
コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。
見るポイント:対数は大きな値ほど強く縮める。右に裾を引く分布を対称に近づける定番の変換で、Box-Cox の \(\lambda = 0\) がちょうどこの対数変換に当たる。
Python で変換前後を比べる #
次のコードは対数正規分布から 1,000 点を作り、変換前のヒストグラムを描きます。対数正規分布は「対数を取ると正規分布になる」分布なので、Box-Cox が \(\lambda \approx 0\) を選べば成功と判断できます。
| |
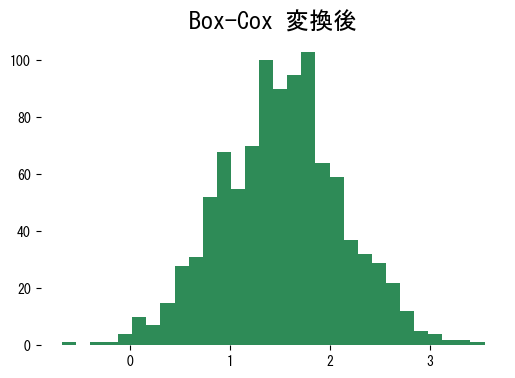
次のコードは \(\lambda\) を最尤推定してから、その値で boxcox を適用し、変換後のヒストグラムを描きます。
| |
実行結果の読み方 #
print される \(\lambda\) は 0 に近い値になり、「このデータは対数変換がほぼ最適」と読めます。変換後のヒストグラムは左右対称に近づき、右に伸びていた裾が消えています。線形回帰や k-NN のように平均・分散・距離を使う手法は、この対称化した値を入力にすると少数の大きな値に引っぱられなくなります。
使いどころと落とし穴 #
\(\lambda\) は学習データで推定し、検証・テストでも同じ値を再利用します。分割ごとに boxcox_normmax をかけ直すと、同じ値が別の数に変換されて情報漏洩と再現性の問題が同時に起きます。予測結果を元のスケールに戻したいときは scipy.special.inv_boxcox(x_trans, lmbda) を使います。モデルが平均 0・分散 1 を要求するなら、Box-Cox の後に StandardScaler を重ねると安定します。入力に 0 や負の値が含まれるときは、定数シフトで無理に正にするより Yeo-Johnson 変換 に切り替えるほうが、分割点の恣意性がなく安全です。