01.3.6
RobustScaler
RobustScaler(quantile_range=(25, 75)) で変換し、箱ひげ図の箱の中心が 0、箱の幅が 1 に揃う様子を確認します。読み終えると、quantile_range を (10, 90) に広げると何が変わるか、with_centering=False を疎行列で使う理由を説明できるようになります。標準化(StandardScaler)や Min-Max 正規化(MinMaxScaler)の概念を先に学ぶと理解がスムーズです。
直感 #
8 人の通学時間が 12, 15, 18, 20, 22, 25, 28, 150 分だとします。平均は 36 分で 7 人がそれより短く、標準偏差は 43 分に膨らみます。StandardScaler で標準化すると 25 分の人の z は −0.26 で「ふつうより少し短い」という実感に合わない値になります。中央値は 21 分で、150 分の人が 1,500 分になっても動きません。RobustScaler は「中央値を 0、箱ひげ図の箱の幅(IQR)を 1」にするものさしを作るので、7 人は −1〜1 にきれいに並び、150 分の人だけが 12.9 という遠くに残ります。外れ値を消すのではなく、外れ値のせいで残り 7 人がつぶれないようにする手法です。
式で書くと何をしているか #
観測値 \(x\)、メディアン \(m = \operatorname{median}(x)\)、IQR に対し、
$$ z = \frac{x - m}{\operatorname{IQR}} $$と変換します。分子の \(x - m\) が箱ひげ図の箱の中心を 0 に平行移動し、\(\mathrm{IQR}\) で割ることで箱の幅がちょうど 1 になります。StandardScaler の \((x - \mu)/\sigma\) と形は同じです。違いは、引く値と割る値を「順位で決まる統計量」に替えたことだけです。quantile_range=(q_1, q_3) を既定の (25, 75) から変えると、IQR の代わりに別のパーセンタイル幅で割ります。
何が起きているか(ステップで見る) #
コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。
見るポイント:箱はデータの中央 50%。ひげは箱の長さの 1.5 倍まで、その外は外れ値として個別に描く。RobustScaler はこの箱の中心を 0、箱の長さを 1 にそろえる。
Python で変換前後を比べる #
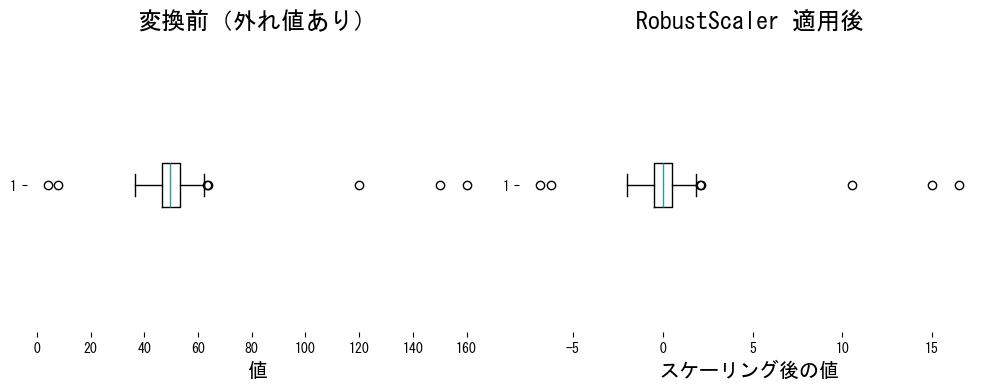
次のコードは平均 50・標準偏差 5 の 400 点に 5 個の極端な値を足し、RobustScaler で変換して箱ひげ図を左右に並べます。
| |
実行結果の読み方 #
左の図では箱が 50 付近に小さく描かれ、120〜160 と 4〜8 の外れ値が点で離れています。右の図では箱の中心(中央値)が 0、箱の幅(IQR、正規分布なら標準偏差の約 1.35 倍)が 1 になり、大多数の 400 点は −1〜1 の範囲に収まります。外れ値の点は 160 なら \((160 - 50)/6.7 \approx 16\) のあたりに残り、箱からの相対的な遠さは変換前と同じです。
他のスケーラーとの比較 #
| スケーラー | 中心化 | スケール基準 | 外れ値耐性 |
|---|---|---|---|
| StandardScaler | 平均 | 標準偏差 | 低い |
| MinMaxScaler | 最小値 | max − min | 低い |
| RobustScaler | メディアン | IQR | 高い |
外れ値が多いデータでは StandardScaler の平均と標準偏差が歪み、MinMaxScaler では 1 つの外れ値が data_max_ を決めて残りが 0 付近に押し込まれるため、RobustScaler が第一候補になります。
quantile_range の調整 #
デフォルトは (25, 75) ですが、範囲を広げると分位点が外れ値側に寄ってスケールが大きくなり、狭めるとデータの中心付近だけでスケールを決めます。次のコードは 2 つの設定を作る例です。
| |
一般に (25, 75) で十分で、外れ値が極端に多い場合に (10, 90) を試します。
使いどころと落とし穴 #
quantile_range を広げると外れ値の影響をさらに抑えられますが、分位点が裾に近づくほど外れ値そのものに引っぱられやすくなるので、データの外れ値の割合を見て決めます。with_centering=False を指定すると中心化せずにスケーリングのみ行え、疎行列でメディアンを引くと 0 が消えてスパース性が失われるケースで有効です。学習データで fit した scaler を推論時に transform するのが基本で、デプロイ時には学習済み scaler を必ず一緒に保存します。RobustScaler の後にさらに StandardScaler を重ねる必要は通常なく、外れ値を取り除きたい場合は Hotelling の T^2 や Isolation Forest で別にラベルを付けます。
まとめ #
RobustScaler は中央値を引いて IQR で割るスケーリングで、外れ値が 5 個混ざっていても大多数の 400 点が −1〜1 に収まります。StandardScaler や MinMaxScaler で箱がつぶれる場合の代替手段として最初に試す価値があり、quantile_range で頑健さの度合いを調整できます。疎行列では with_centering=False を指定してスパース性を保ちます。
- StandardScaler — 平均と標準偏差によるスケーリング
- MinMaxScaler — 最小値・最大値によるスケーリング