01.3.6 高校生向け
RobustScaler(高校生向け)
こんな場面を想像してみよう #
クラス 8 人の通学時間(分)を調べたら、次のようになりました。
| 12 | 15 | 18 | 20 | 22 | 25 | 28 | 150 |
|---|
1 人だけ、遠くから新幹線通学している生徒がいます。この 8 人の「ふつうの通学時間」を代表する数はいくつでしょう。
平均を計算すると \(290 \div 8 = 36.25\) 分。ところが 8 人のうち 7 人は 30 分以内で、平均より短い通学時間です。標準偏差も約 43 分に膨らみます。平均と標準偏差で StandardScaler のように標準化すると、25 分の人の z スコアは \((25 - 36.25)/43.3 \approx -0.26\)。「ふつうより少し短い」という、実感と合わない値になります。
一方、中央値は \((20 + 22)/2 = 21\) 分。150 分の生徒が 1500 分でも中央値は 21 のままです。「順位で決まる値は、端の値がどれだけ極端でも動かない」。これが RobustScaler の土台です。
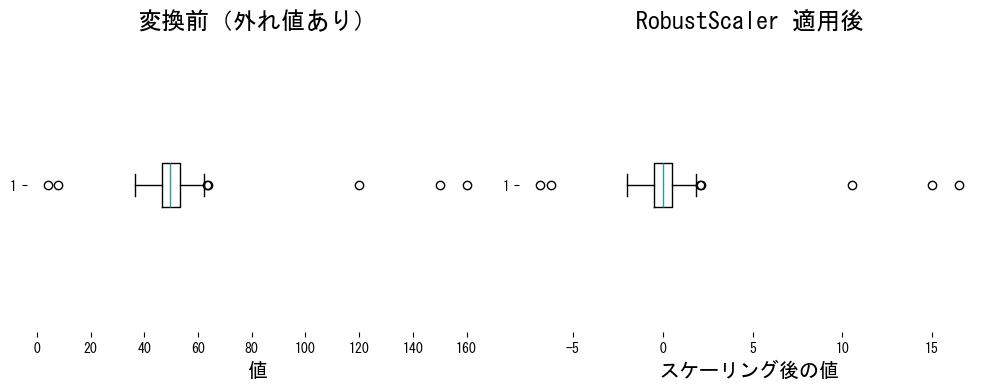
上の図の左は変換前の箱ひげ図です。大多数のデータは 50 のまわりに集まって小さな箱を作り、右のほうに 120〜160 の外れ値が点で散っています。右が変換後。箱の中心(中央値)が 0 に、箱の横幅(四分位範囲)が 1 にそろいました。外れ値の点は消えずに、やはり箱から 10 目盛り以上遠く離れたところに残っています。
仕組み:中央値を引いて、四分位範囲で割る #
まず、データを小さい順に並べて中央値 \(m\) を見つけます。箱ひげ図の箱の中の線です。次に、第 1 四分位数 \(Q_1\) と第 3 四分位数 \(Q_3\) を求め、四分位範囲 \(\mathrm{IQR} = Q_3 - Q_1\) を出します。箱ひげ図では箱の左端と右端、そして箱の横幅に当たります。続けて、すべての値から \(m\) を引くと、箱ひげ図がまるごと平行移動して箱の中の線が 0 に来ます。最後に \(\mathrm{IQR}\) で割ると、箱の横幅がちょうど 1 になるように全体が伸び縮みします。
通学時間 8 人の例で計算してみましょう。四分位数は教科書の方法で求めているので、Python の numpy.percentile とは少し値がずれることがあります。
| |
7 人は −1〜1 の中にきれいに並び、150 分の生徒だけが 12.9 という「箱の幅の 13 倍遠く」にいることがはっきり分かります。
動かして見てみよう #
下の図で「再生」を押すと、説明した手順が 1 つずつ進みます。手順ごとの説明は図の下に出ます。
気をつけたいこと #
最初の注意は、外れ値(150 分の生徒)はなくならないことです。変換後も 12.9 のような大きい値はそのまま残るので、外れ値を取り除きたいなら別に判定の手順が必要です。二つ目は、変換後の範囲が 0〜1 のように決まっていないことです。MinMaxScaler のように 0〜1 に収まるわけではなく、箱の中(中央 50 % のデータ)がおおよそ −0.5〜0.5 に入る、という目安だけです。
やってみよう #
最初の課題は、自分のクラスの通学時間(または 1 日の睡眠時間)を 8〜10 人分集め、平均と中央値、標準偏差と四分位範囲を計算して、どのくらい差があるか比べることです。二つ目は、その中の 1 人の値を 10 倍に書き換えて、平均・標準偏差・中央値・四分位範囲のうち何が動き、何が動かないかを確かめることです。三つ目は、「外れ値が 1 つではなく全体の 3 割もある」データを作ってみることです。四分位数まで引っぱられて RobustScaler が効きにくくなることを観察しましょう。
つぎに読む #
定義と scikit-learn の quantile_range の調整、ほかのスケーラーとの比較表は 標準版の RobustScaler で扱っています。平均と標準偏差でそろえる基本形は StandardScaler(高校生向け)、0〜1 に収める方法は MinMaxScaler(高校生向け) へ進んでください。箱ひげ図の読み方から復習したいときは RobustScaler(中学生向け) が入口になります。