01.3.3
StandardScaler で平均0・分散1に正規化する
StandardScaler().fit_transform で原点中心に移し、点の並び(相関の形)は変わらず目盛りだけが変わることを確認します。読み終えると、scaler.mean_・scaler.scale_ を本番で使い回す理由と、SVM・k-NN・ロジスティック回帰・PCA のように距離や内積を使う手法でなぜ必須になるかを説明できるようになります。直感 #
数学 80 点(クラス平均 60、標準偏差 20)と英語 80 点(平均 70、標準偏差 5)は同じ 80 点でも価値が違います。数学は「標準偏差 1 個分上」、英語は「2 個分上」で、偏差値に直すと 60 と 70 です。StandardScaler はこの偏差値の計算 \((x - \mu)/\sigma\) を全列にいっせいに行います。身長(170 cm 前後、ばらつき 8)と体重(65 kg 前後、ばらつき 12)を k-NN に渡すとき、標準化しないと体重の差ばかりが距離に効きますが、両方を z スコアにすれば「平均から 1σ 離れた」という同じ意味の数どうしで距離を測れます。
式で書くと何をしているか #
特徴量 \(x\) を平均 \(\mu\)、標準偏差 \(\sigma\) で正規化すると
$$ z = \frac{x - \mu}{\sigma} $$となります。分子の \(x - \mu\) が「散布図のかたまりを原点まで平行移動する」操作、分母の \(\sigma\) で割るのが「かたまりの広がりを縦横ともに 1 に伸び縮みさせる」操作です。with_mean=False を指定すると中心化を飛ばしてスケーリングだけ、with_std=False なら中心化だけになります。\(\mu\) と \(\sigma\) は列ごとに学習データから求め、scaler.mean_ と scaler.scale_ に保存されます。
何が起きているか(ステップで見る) #
コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。
見るポイント:単位が違うと距離は大きい軸に支配される。揃えてから距離ベースの手法(k-means・k-NN)を使う。3 手順目の標準化では多くの点が −2〜2 に収まる。
Python で変換前後を比べる #
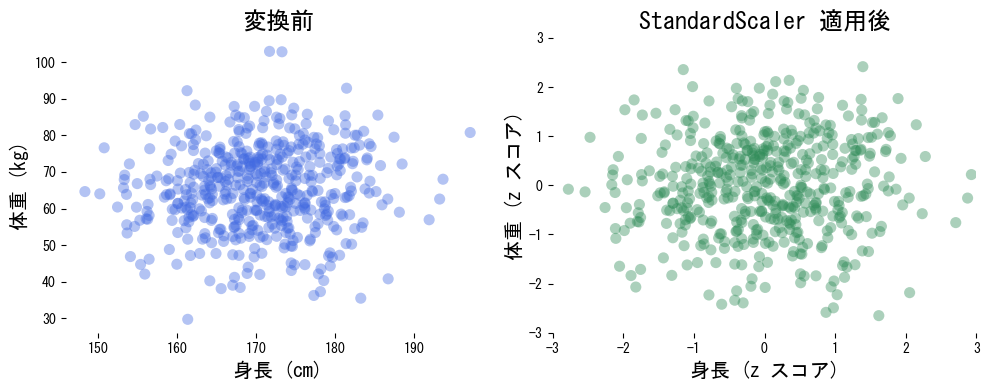
次のコードは身長(平均 170 cm・標準偏差 8)と体重(平均 65 kg・標準偏差 12)の 500 人分を作り、StandardScaler で両列を z スコアに変換して散布図を左右に並べます。
| |
実行結果の読み方 #
左の図ではかたまりが横軸 170・縦軸 65 のあたりに浮いていて、横と縦で目盛りの意味が違います。右の図ではかたまりがそのまま原点 (0, 0) に移り、横も縦も −3〜3 の同じ目盛りに収まっています。z = 1 の点は「平均より標準偏差 1 個分だけ大きい」と読み、身長なら 178 cm、体重なら 77 kg に当たります。点の並び方は左右で同じなので、相関係数 \(r\) は標準化の前後で変わりません。
使いどころと落とし穴 #
scaler.mean_ と scaler.scale_ を保存し、推論時も同じ scaler インスタンスで transform することで、テストデータの統計量が学習に漏れるのを防ぎます。元のスケールに戻したいときは scaler.inverse_transform(scaled) を使います。疎行列を扱う場合は with_mean=False を指定し、計算コストとスパース性を維持します。平均と標準偏差は外れ値 1 つで大きく動くため、外れ値の多いデータでは中央値と IQR を使う RobustScaler に替えるか、先に外れ値を処理してから StandardScaler を適用すると安定します。決定木やランダムフォレストは分割点の大小関係しか見ないので、標準化しても結果は変わりません。