01.3.3 高校生向け
StandardScaler で平均0・分散1に正規化する(高校生向け)
こんな場面を想像してみよう #
数学と英語のテストが返ってきました。どちらも 80 点です。素直に喜んでいいでしょうか。
| 自分の点 | クラス平均 | 標準偏差 | |
|---|---|---|---|
| 数学 | 80 | 60 | 20 |
| 英語 | 80 | 70 | 5 |
数学は平均より 20 点上ですが、クラス全体が 20 点幅でばらついているので「標準偏差 1 個分だけ上」。英語は平均より 10 点上なだけですが、全員が 70 点前後に固まっている中での 10 点差なので「標準偏差 2 個分も上」。同じ 80 点でも、英語のほうがはるかに目立つ成績です。
「平均からの差を、散らばりの大きさで割る」と、科目ごとの難しさや点数の散らばりのちがいを消して比べられます。StandardScaler がやっているのは、この偏差値の計算をデータの全項目にいっせいに行うことです。
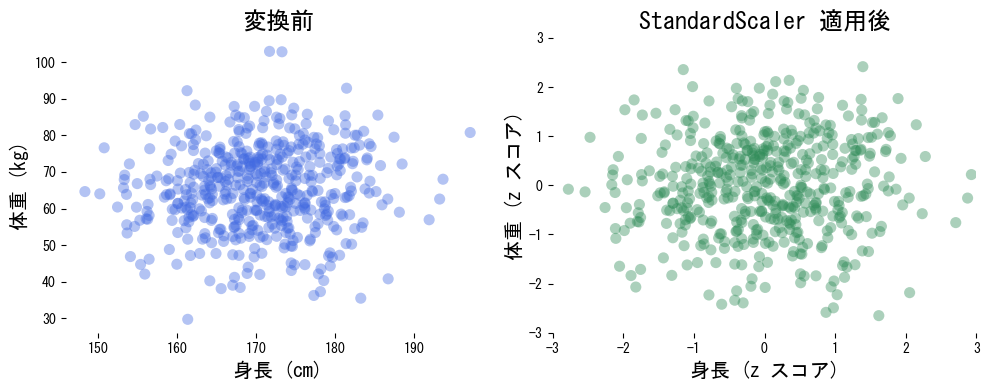
上の図の左は、身長(cm)と体重(kg)の散布図です。点のかたまりは横軸 170・縦軸 65 のあたりに浮いていて、横軸と縦軸の目盛りの意味もちがいます。右が変換後。かたまりがそのまま原点 (0, 0) に引っ越し、横も縦も「−3〜3」の同じ目盛りになりました。点の並び方(かたまりの形)は左右でまったく同じで、変わったのは目盛りが cm・kg から z スコアになったことだけです。
仕組み:平均を引いて、標準偏差で割る #
まず、項目ごとに平均 \(\mu\) を求めます。散布図では、かたまりの中心の位置です。次に、すべての点から \(\mu\) を引きます。かたまりがまるごと平行移動して中心が 0 に来る操作で、これを中心化といい、形は変わりません。続けて、標準偏差 \(\sigma\) を求めてそれで割ります。かたまりの広がりが横方向・縦方向ともに 1 に伸び縮みし、広がりの大きかった項目は縮み、小さかった項目は引き伸ばされます。最後に、できた値を z スコアと呼びます。\(z = 1\) なら「平均より標準偏差 1 個分だけ上」、\(z = -2\) なら「2 個分下」と読みます。
さきほどのテストなら、数学は \(z = (80-60)/20 = 1\)、英語は \(z = (80-70)/5 = 2\)。偏差値に直すと 60 と 70 です。5 人の点数で、この式をそのまま計算してみます。
| |
動かして見てみよう #
下の図で「再生」を押すと、説明した手順が 1 つずつ進みます。手順ごとの説明は図の下に出ます。
気をつけたいこと #
最初の注意は、外れ値(極端に離れた 1 点)に引っぱられることです。平均も標準偏差も 1 つの極端な値で大きく動き、すると外れ値以外の点の z がぜんぶ 0 の近くに縮んでしまいます。外れ値が多いなら中央値と四分位範囲を使う RobustScaler が安全です。二つ目は、形がゆがんだ分布は z スコアにしてもゆがんだままだということです。平均 0・標準偏差 1 にそろえても、山の片側に長い裾があればそのままで、「標準化すれば正規分布になる」は誤解です。三つ目は、平均と標準偏差は訓練データで決めて使い回すことです。テストのたびに平均を取り直すと、同じ z = 1 が別の意味になります。機械学習では学習に使ったデータの \(\mu, \sigma\) を保存して、新しいデータにも同じ値を当てます。
やってみよう #
最初の課題は、最近の定期テスト 2 科目について、自分の点・クラス平均・標準偏差(先生に聞くか、公開されていれば)から z を計算し、どちらが「クラス内では良い成績」か比べることです。二つ目は、上のコードの scores を自分の身近な数(友だち 5 人の通学時間など)に変えて、z の合計が 0 になることを確かめることです。三つ目は、5 人の点数に 1 人だけ 0 点を混ぜたら、ほかの 4 人の z がどう変わるか予想して計算で確かめることです。外れ値に弱い理由が見えてきます。
つぎに読む #
定義の一般形と scikit-learn での実装、逆変換の方法は 標準版の StandardScaler で扱っています。「0〜1 に収める」別のそろえ方は MinMaxScaler(高校生向け)、外れ値に強い方法は RobustScaler(高校生向け) へ進んでください。単位のちがいが「距離」をゆがめる実例は k 近傍法(高校生向け) で確かめられます。