01.3.5
Yeo-Johnson変換
scipy.stats.yeojohnson_normmax が \(\lambda\) を最尤推定し、scipy.stats.yeojohnson(x, lmbda=...) がその値で変換します。このページでは負の値を含む loggamma 乱数 1,000 点を例に変換前後のヒストグラムを比べ、学習データで決めた \(\lambda\) を検証データにも同じ値で適用する書き方を確認します。直感 #
気温の変化量や株価のリターンのように、0 をまたいで負の値も取る量は Box-Cox 変換 にそのまま渡せません。\(\log x\) や \(x^{0.5}\) が負の値で定義できないからです。「全体に 100 を足して正にする」という回避策もありますが、足す定数しだいで変換の形が変わってしまいます。Yeo-Johnson 変換は正の側と負の側で別の式を使い、0 でなめらかにつながるように設計されているので、定数を足す判断をせずにそのまま歪みを直せます。右に裾を引いたデータでは \(\lambda < 1\) が選ばれて大きな値が縮み、左に裾を引いたデータでは \(\lambda > 1\) が選ばれて小さな値側が縮みます。
式で見ると正と負でどう分かれているか #
観測値 \(y\) とパラメーター \(\lambda\) に対して、Yeo-Johnson 変換 \(T_\lambda(y)\) は次のように定義されます。
$$ T_\lambda(y)= \begin{cases} \dfrac{(y + 1)^\lambda - 1}{\lambda}, & y \ge 0,\ \lambda \ne 0,\\\\ \log(y + 1), & y \ge 0,\ \lambda = 0,\\\\ -\dfrac{(1 - y)^{2 - \lambda} - 1}{2 - \lambda}, & y < 0,\ \lambda \ne 2,\\\\ -\log(1 - y), & y < 0,\ \lambda = 2. \end{cases} $$上の 2 行が正の側で、\(y + 1\) に対する Box-Cox 変換と同じ形です。下の 2 行が負の側で、\(1 - y\) という正の量に \(2 - \lambda\) のべきをかけてから符号を戻しています。\(\lambda = 1\) のときはどの行も \(y\) そのものになり、変換しないのと同じです。正の側で \(\lambda\) を小さくすると大きな値が縮む一方、負の側のべきは \(2 - \lambda\) で大きくなるので、負の側は逆に引き伸ばされます。べきを正の側 \(\lambda\)・負の側 \(2 - \lambda\) と分けているおかげで、変換後も値の大小関係(単調性)が崩れません。逆変換は同じ場合分けを \(y\) について解けば得られ、SciPy では scipy.stats.yeojohnson_inverse が実装されています。\(\lambda\) は変換後のデータが正規分布に従うと仮定した対数尤度を最大化して決め、yeojohnson_normmax がその推定値を返します。
I. Yeo and R.A. Johnson, “A New Family of Power Transformations to Improve Normality or Symmetry”, Biometrika 87(4), 2000.
何が起きているか(ステップで見る) #
コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。
見るポイント:対数は大きな値ほど強く縮める。右に裾を引く分布を対称に近づける定番の変換で、Yeo-Johnson は 0 や負の値でも同じ効果を出せるように対数を拡張したもの。
Python で変換前後を比べる #
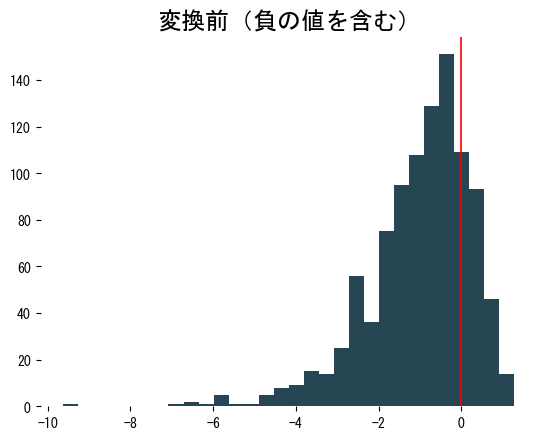
次のコードは負の値を含む歪んだ分布を 1,000 点作り、0 の位置に赤い線を引いたヒストグラムを描きます。赤い線の左側に点があることが、Box-Cox では扱えない理由です。
| |
次のコードは \(\lambda\) を最尤推定してから yeojohnson を適用し、変換後のヒストグラムを描きます。
| |
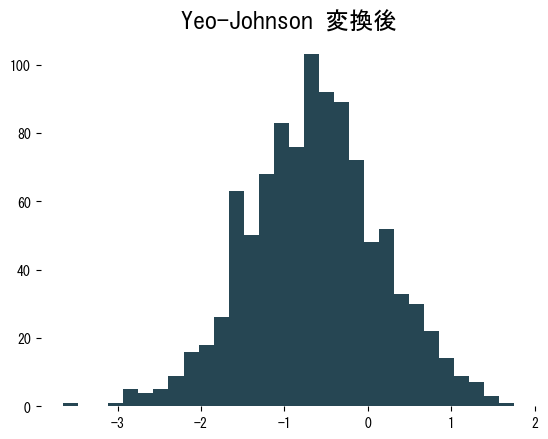
変換後のヒストグラムは左右対称に近づき、分散も安定します。次のコードは、学習データで得た \(\lambda\) を検証データにそのまま使う書き方です。
| |
使いどころと落とし穴 #
変換後に平均 0・分散 1 を要求するモデルでは、Yeo-Johnson の後に StandardScaler を重ねると安定します(PowerTransformer は既定の standardize=True でこれを自動で行います)。\(\lambda\) の推定は学習用データのみで行い、検証・テストには同じ値を渡して情報漏洩を防ぎます。変換しても極端な外れ値の影響が残る場合は、RobustScaler のように中央値と IQR を使うスケーリングと組み合わせます。Yeo-Johnson 変換は正の値に限定される Box-Cox の代わりとして、0 や負の値を含む特徴量にそのまま使える前処理です。