01.6.2
EDGARのデータを取得
sec_edgar_downloader で Microsoft(ティッカー MSFT)の 2021 年の 10-K をダウンロードし、pandas.read_html で HTML 内のすべての表を DataFrame にしてから、“Cash and cash equivalents, end of period” という文言を含む表だけをキャッシュフロー計算書として選びます。そのあと replace(regex=True) で “(”, “)”, “,” を消し、NaN が 8 割を超える列を落として、Net income など 10 項目の 2019〜2021 年の推移を折れ線で描きます。読み終えると、HTML から取った表が「文字列の表」であること、数値に使える形まで掃除する手順がなぜ必要かを説明できるようになります。直感 #
企業の財務データは、有料のデータベースを使わなくても SEC の EDGAR から無料で手に入ります。ただし 10-K は人が読むための HTML なので、そのままでは「表」として扱えません。pd.read_html は HTML 内の <table> をすべて DataFrame のリストとして返してくれますが、1 つの 10-K には数十〜数百の表が含まれ、セルには “$” や “(” のような記号と大量の空セルが混ざっています。このページの流れは「取得(Downloader)→ 表の一括抽出(read_html)→ 目的の表の選択(文言で検索)→ 掃除(記号・NaN の除去)→ 数値化してプロット」の 5 段階で、後半の掃除の部分がコードの大半を占めます。
10-K をダウンロードする #
最初のブロックは、Microsoft の 2021 年の 10-K を ./data/ 以下にダウンロードします。既にダウンロード済みなら通信せずに済むように分岐しています。
| |
ダウンロード済みです。
10-K に含まれる表を抜き出す #
次のブロックは、ダウンロードした HTML(filing-details.html)を pandas.read_html に渡し、ページ内のすべての表を DataFrame のリストとして受け取ります。
| |
CASH FLOWS STATEMENTS のテーブルを抽出 #
数十個の表の中からキャッシュフロー計算書(CASH FLOWS STATEMENTS)を選びます。表番号で指定する方法もありますが、ここではキャッシュフロー計算書の最終行に必ず現れる「Cash and cash equivalents, end of period」という文言を含む表を探す方法にしています。
| |
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | (In millions) | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN |
| 1 | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN |
| 2 | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN |
| 3 | Year Ended June 30, | NaN | 2021 | 2021 | NaN | NaN | 2020 | 2020 | NaN | NaN | 2019 | 2019 | NaN |
| 4 | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN |
| 5 | Operations | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN |
| 6 | Net income | NaN | $ | 61271 | NaN | NaN | $ | 44281 | NaN | NaN | $ | 39240 | NaN |
| 7 | Adjustments to reconcile net income to net cas... | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN |
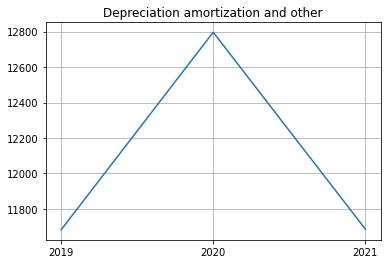
| 8 | Depreciation, amortization, and other | NaN | NaN | 11686 | NaN | NaN | NaN | 12796 | NaN | NaN | NaN | 11682 | NaN |
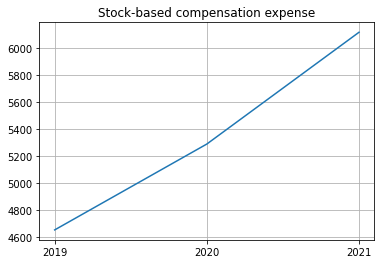
| 9 | Stock-based compensation expense | NaN | NaN | 6118 | NaN | NaN | NaN | 5289 | NaN | NaN | NaN | 4652 | NaN |
データの前処理 #
上の出力を見ると、13 列のうち金額が入っているのは 3 列だけで、残りは NaN か “$” だけの列です。しかも “61271” は文字列で、"(In millions)" のように括弧やカンマも混ざっています。次の 3 ブロックで、記号の削除 → NaN の多い列の削除 → 列名の付け替えの順に掃除して、数値として読める 4 列の表にします。
| |
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | In millions | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN |
| 1 | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN |
| 2 | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN |
| 3 | Year Ended June 30 | NaN | 2021 | 2021 | NaN | NaN | 2020 | 2020 | NaN | NaN | 2019 | 2019 | NaN |
| 4 | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN |
| 5 | Operations | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN |
| 6 | Net income | NaN | $ | 61271 | NaN | NaN | $ | 44281 | NaN | NaN | $ | 39240 | NaN |
| 7 | Adjustments to reconcile net income to net cas... | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN | NaN |
| 8 | Depreciation amortization and other | NaN | NaN | 11686 | NaN | NaN | NaN | 12796 | NaN | NaN | NaN | 11682 | NaN |
| 9 | Stock-based compensation expense | NaN | NaN | 6118 | NaN | NaN | NaN | 5289 | NaN | NaN | NaN | 4652 | NaN |
| |
| 0 | 3 | 7 | 11 | |
|---|---|---|---|---|
| 0 | In millions | NaN | NaN | NaN |
| 1 | NaN | NaN | NaN | NaN |
| 2 | NaN | NaN | NaN | NaN |
| 3 | Year Ended June 30 | 2021 | 2020 | 2019 |
| 4 | NaN | NaN | NaN | NaN |
| 5 | Operations | NaN | NaN | NaN |
| 6 | Net income | 61271 | 44281 | 39240 |
| 7 | Adjustments to reconcile net income to net cas... | NaN | NaN | NaN |
| 8 | Depreciation amortization and other | 11686 | 12796 | 11682 |
| 9 | Stock-based compensation expense | 6118 | 5289 | 4652 |
| |
データをプロットする #
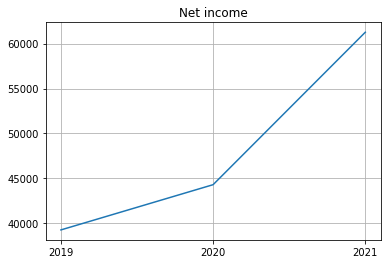
最後のブロックは、掃除した表の先頭 10 項目について、2019〜2021 年の値を float に変換して 1 項目 1 枚の折れ線グラフにします。
| |
実行結果の読み方 #
Net income の図は 39,240 → 44,281 → 61,271(百万ドル)と右上がりで、Microsoft の純利益が 3 年で 1.5 倍以上になったことが読めます。Depreciation, amortization, and other は 11,682 → 12,796 → 11,686 とほぼ横ばい、Stock-based compensation expense は 4,652 → 5,289 → 6,118 と毎年増えています。項目名が NaN の行は IndexError で飛ばされるので、図の枚数は 10 枚より少なくなります。
使いどころと落とし穴 #
財務諸表の “(1,234)” は負の値の表記なので、このページのように括弧を単に消すと符号が失われます。本番で使うなら str.replace(r"\((.*)\)", r"-\1", regex=True) で先にマイナスに変換してください。表の選択を文言で行っているため、“Cash and cash equivalents, end of period” の表記が違う企業(“end of year” など)では cs_table が None のまま head を呼んで AttributeError になります。列名の ["item", "2021", "2020", "2019"] も Microsoft の 2021 年の 10-K に合わせた手書きなので、他社や他年度では head(10) の出力を見て付け直します。EDGAR はアクセス頻度の制限があり、sec_edgar_downloader の新しい版では Downloader に会社名とメールアドレスの指定が必須になっているので、ライブラリの版に合わせて最初のブロックを読み替えてください。