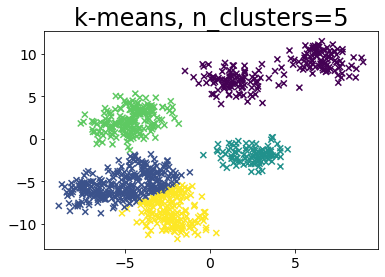
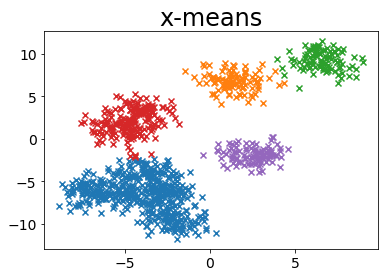
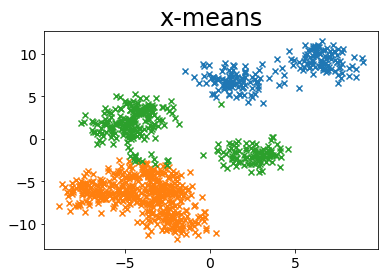
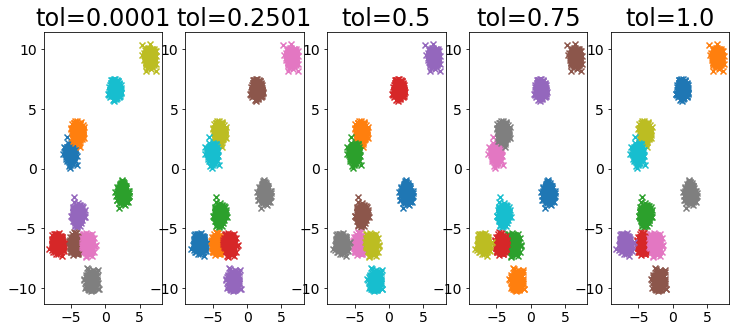
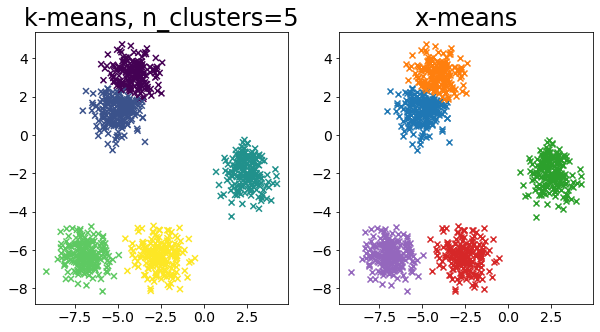
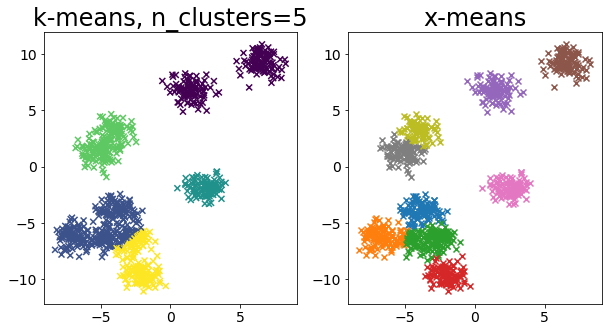
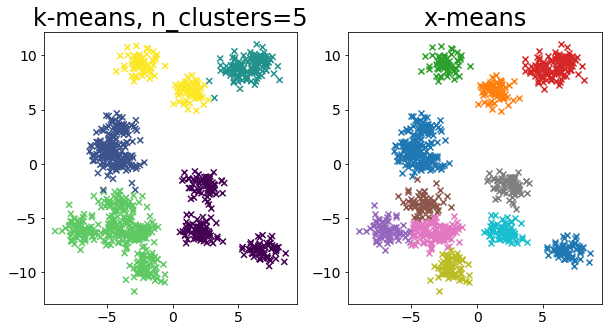
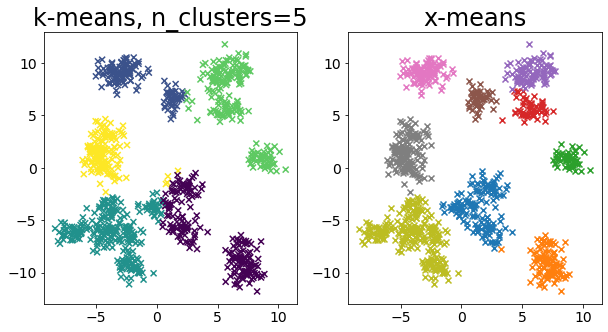
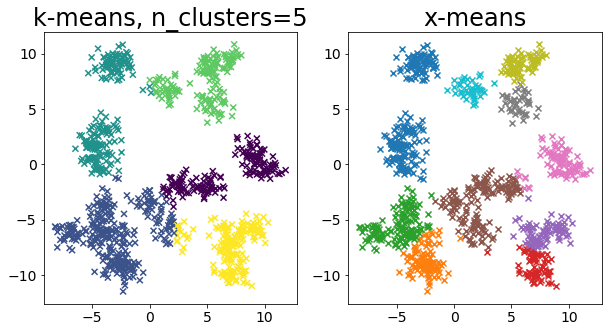
O X-means segue uma estratégia de dividir e testar: começa com clusters grosseiros e depois divide apenas quando um critério estatístico indica melhoria. Isso reduz a tentativa e erro manual sobre k, mantendo a otimização tratável.
<p>O X-means é um tipo de algoritmo de agrupamento que determina automaticamente o número de clusters conforme o agrupamento avança. Esta página compara os resultados do k-means++ e do X-means.</p>
frompyclustering.cluster.xmeansimportxmeansfrompyclustering.cluster.center_initializerimportkmeans_plusplus_initializerBAYESIAN_INFORMATION_CRITERION=0MINIMUM_NOISELESS_DESCRIPTION_LENGTH=1defplot_by_xmeans(X,c_min=3,c_max=10,criterion=BAYESIAN_INFORMATION_CRITERION,tolerance=0.025):initial_centers=kmeans_plusplus_initializer(X,c_min).initialize()xmeans_instance=xmeans(X,initial_centers,c_max,criterion=criterion,tolerance=tolerance)xmeans_instance.process()# Create data for plotsclusters=xmeans_instance.get_clusters()n_samples=X.shape[0]c=[]fori,cluster_iinenumerate(clusters):X_ci=X[cluster_i]color_ci=[ifor_incluster_i]plt.scatter(X_ci[:,0],X_ci[:,1],marker="x")plt.title("x-means")# Run x-meansplot_by_xmeans(X,c_min=3,c_max=10,criterion=BAYESIAN_INFORMATION_CRITERION)