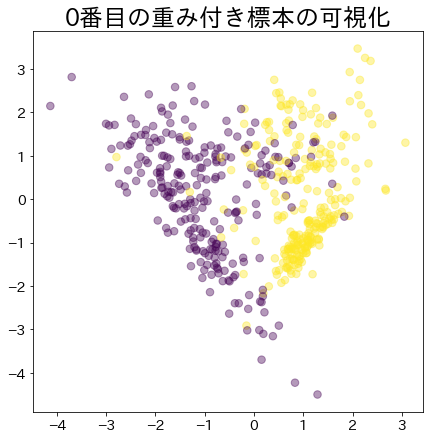
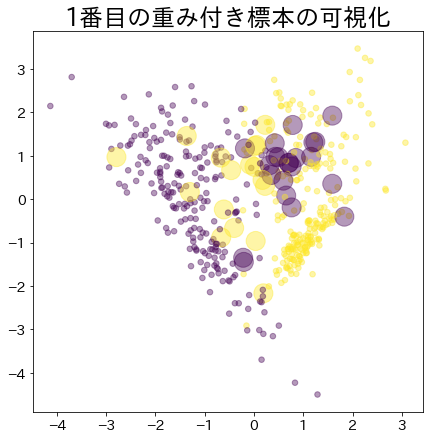
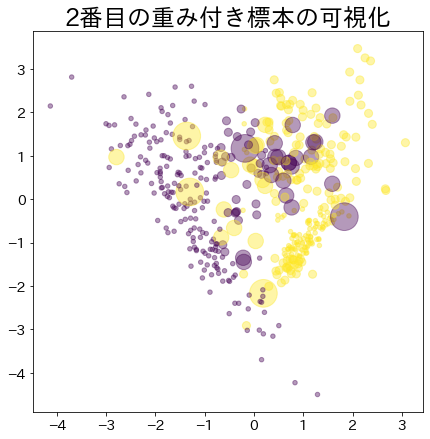
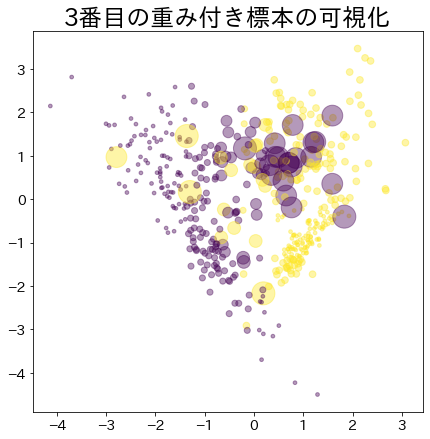
O AdaBoost funciona focando repetidamente nos erros da rodada anterior. Cada aprendiz fraco é limitado, mas o conjunto ponderado acumula correções complementares, produzindo um classificador forte a partir de componentes simples.
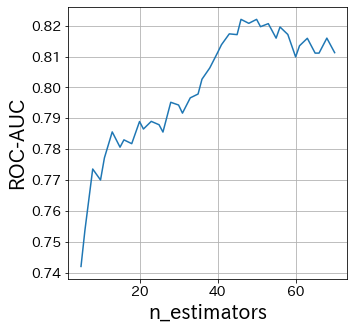
O n_estimators especifica o número de aprendizes fracos.
Normalmente, não há necessidade de aumentar ou diminuir este parâmetro.
Fixe o n_estimators em algum número grande e depois ajuste os outros parâmetros.
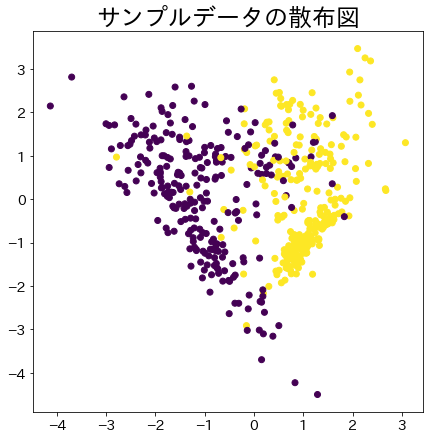
# NOTA: Modelo criado para verificar o sample_weight passado ao modelo# Este DummyClassifier não altera os parâmetros do AdaboostclassDummyClassifier:def__init__(self):self.model=DecisionTreeClassifier(max_depth=3)self.n_classes_=2self.classes_=["A","B"]self.sample_weight=None## sample_weightdeffit(self,X,y,sample_weight=None):self.sample_weight=sample_weightself.model.fit(X,y,sample_weight=sample_weight)returnself.modeldefpredict(self,X,check_input=True):proba=self.model.predict(X)returnprobadefget_params(self,deep=False):return{}defset_params(self,deep=False):return{}n_samples=500X_2,y_2=make_classification(n_samples=n_samples,n_features=2,n_informative=2,n_redundant=0,n_repeated=0,random_state=117,n_clusters_per_class=2,)plt.figure(figsize=(7,7,))plt.title(f"Scatter plots of sample data")plt.scatter(X_2[:,0],X_2[:,1],c=y_2)plt.show()
clf=AdaBoostClassifier(n_estimators=4,random_state=0,algorithm="SAMME",base_estimator=DummyClassifier())clf.fit(X_2,y_2)fori,estimators_iinenumerate(clf.estimators_):plt.figure(figsize=(7,7,))plt.title(f"Visualization of the {i}-th weighted sample")plt.scatter(X_2[:,0],X_2[:,1],marker="o",c=y_2,alpha=0.4,s=estimators_i.sample_weight*n_samples**1.65,)plt.show()