Em vez de escolher um único melhor modelo, o stacking aprende um modelo de segundo nível que decide quando cada modelo base deve ser confiável. Funciona bem quando os aprendizes base cometem diferentes tipos de erros.
# Criar dados com 20 característicasn_features=20X,y=make_classification(n_samples=2500,n_features=n_features,n_informative=10,n_classes=2,n_redundant=0,n_clusters_per_class=4,random_state=777,)X_train,X_test,y_train,y_test=train_test_split(X,y,test_size=0.33,random_state=777)
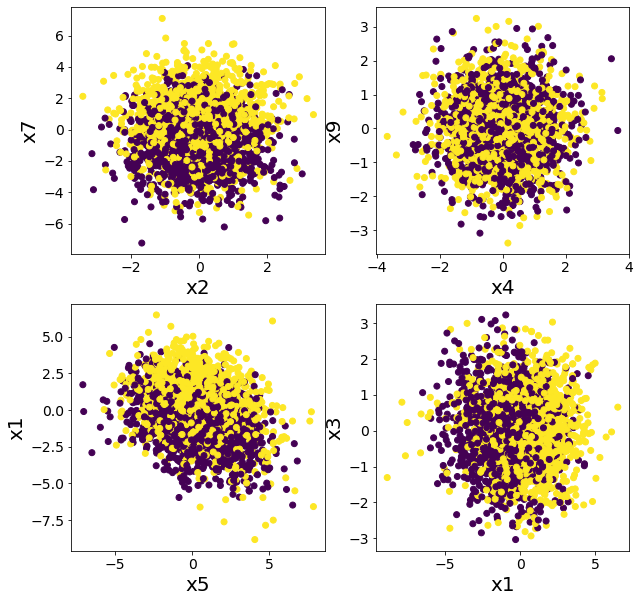
Plotar os dados em relação a múltiplas características
#
Confirme que não parece ser classificável por regras simples.
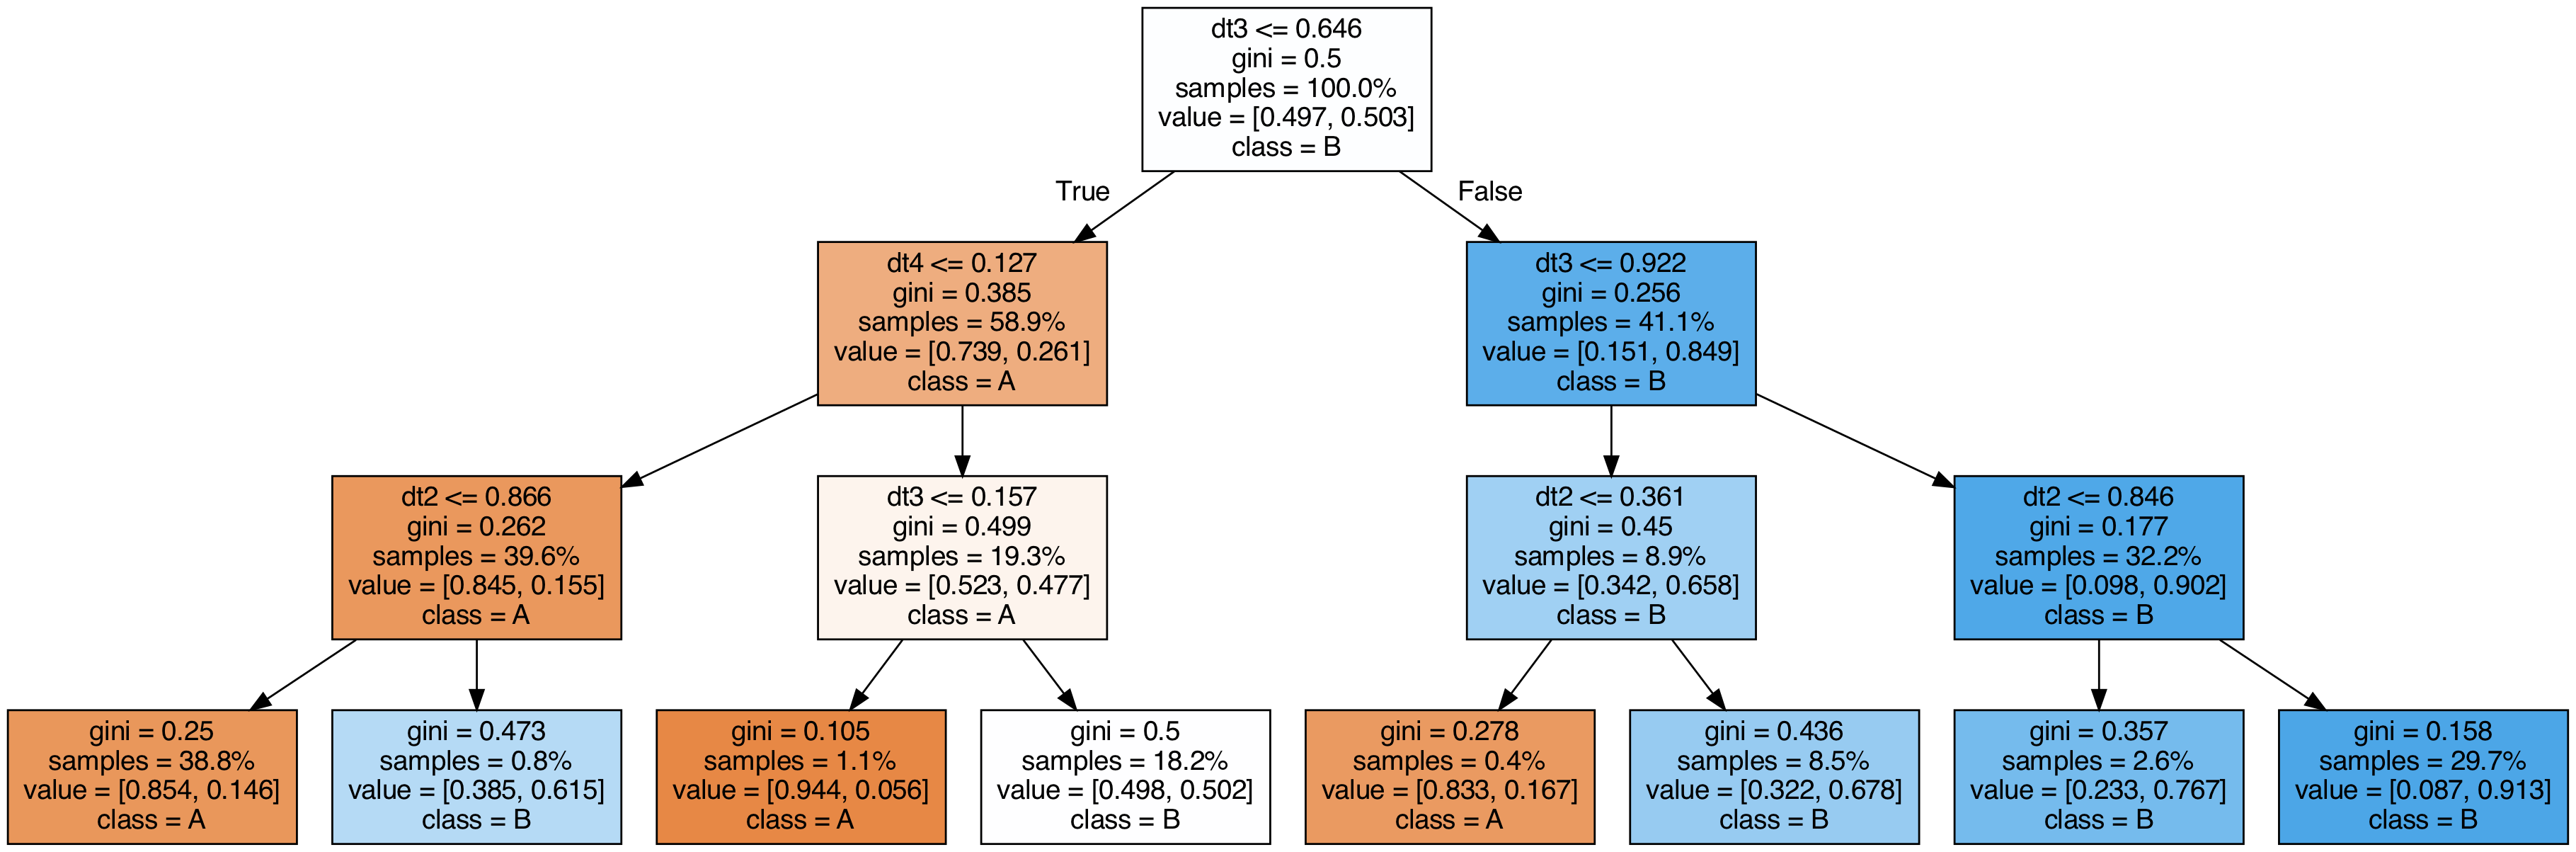
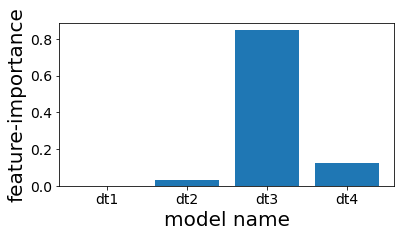
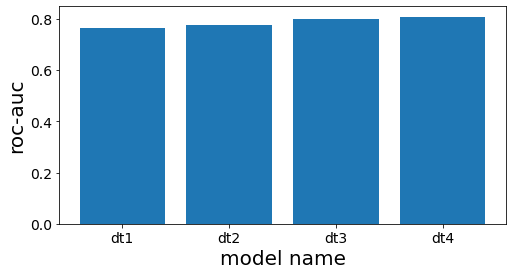
# Modelos usados no aprendiz baseestimators=[("dt1",DecisionTreeClassifier(max_depth=3,random_state=777)),("dt2",DecisionTreeClassifier(max_depth=4,random_state=777)),("dt3",DecisionTreeClassifier(max_depth=5,random_state=777)),("dt4",DecisionTreeClassifier(max_depth=6,random_state=777)),]# Número de modelos incluídos no aprendiz basen_estimators=len(estimators)# Modelo de agregaçãofinal_estimator=DecisionTreeClassifier(max_depth=3,random_state=777)# Treinar aprendiz base e modelo de agregaçãoclf=StackingClassifier(estimators=estimators,final_estimator=final_estimator)clf.fit(X_train,y_train)# Avaliary_pred=clf.predict(X_test)clf_score=roc_auc_score(y_test,y_pred)print("ROC-AUC")print(f"Decision Tree Stacking={clf_score}, Random Forest={rf_score}")
ROC-AUC
Decision Tree Stacking=0.7359716965608031, Random Forest=0.855797033310609