04.16.1
階層的時系列
ExponentialSmoothing(trend="add") で末端を 6 か月先まで予測して足し上げるボトムアップ予測を実装し、np.allclose で「全社 = 事業部 A + 事業部 B」が成り立つことを確認します。ARIMA モデル など単一系列の予測手法を 1 つ知っていれば十分で、このページではその予測を「複数の系列に当てて合計を合わせる」部分に焦点を当てます。
階層的時系列とは #
時系列データが複数あるとき、そのデータが「下位の合計が上位になる」階層的な構造を持つことがあります。47 都道府県の売上を足すと全国の売上になり、商品別の売上を足すと店舗の売上になる、という関係です。
例:地域・カテゴリごとの販売データ #
経済産業省のサイトでは『商業動態統計』が定期的に公開されています。これは日本の商業を営む企業の販売活動の動向をチェックすることを目的として集められているデータで、たとえば 2022 年 1 月の 付表3 百貨店・スーパー販売 都道府県別、商品別販売額等 には以下のようなデータが含まれています。
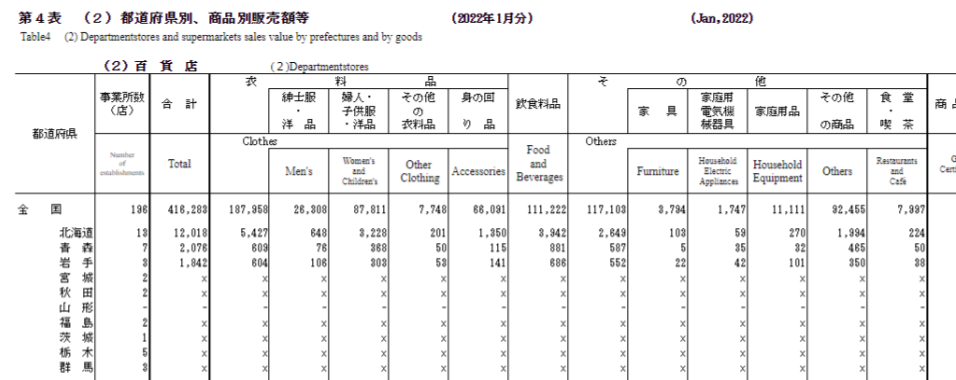
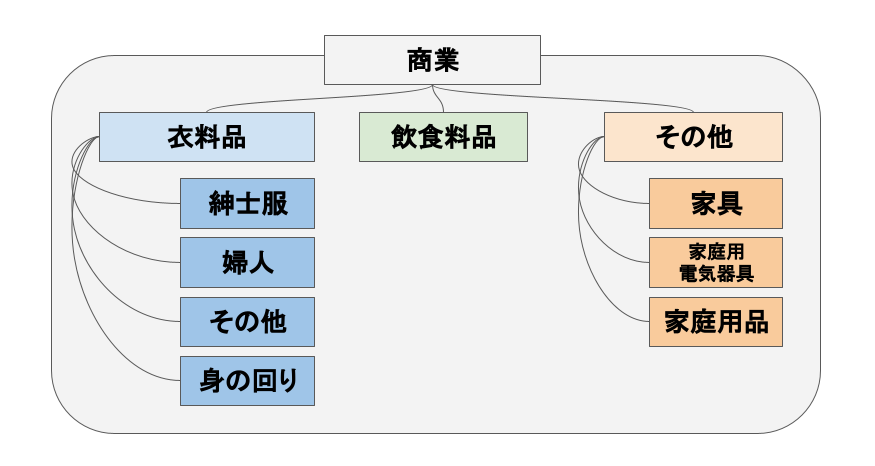
このデータには以下のような階層構造が含まれています。全国の販売額は 47 都道府県の合計であり、各都道府県の販売額は衣料品・飲食料品などの商品別の合計でもあるので、地域の軸と商品の軸という 2 つの階層が交差しています。
階層構造の具体例 #
企業の売上データを例にすると、次のような 3 層の階層が考えられます。
全社売上
├── 事業部A
│   ├── 製品A-1
│   └── 製品A-2
└── 事業部B
    ├── 製品B-1
    └── 製品B-2
このとき、各レベルの時系列には整合性の制約があり、全社売上は事業部 A と事業部 B の売上の和、事業部 A の売上は製品 A-1 と A-2 の売上の和でなければなりません。観測値では定義上この等式が成り立ちますが、7 本の系列を別々に ARIMA や ExponentialSmoothing で予測すると、製品 A-1 と A-2 の予測の合計が事業部 A の予測と一致せず、この整合性が崩れます。
予測の調整手法 #
階層的時系列の予測には、整合性を保つために 3 つの代表的なアプローチがあります。
ボトムアップ(Bottom-Up) #
もっとも細かいレベル(製品単位など)で個別に予測し、上位レベルはその合算で求めます。製品 A-1 の季節性や新製品の立ち上がりといった個別の特性を予測に反映しやすいのが利点で、合計が定義上一致するので調整の計算も要りません。欠点は、末端の系列ほどノイズが大きいことで、製品 1 つの売上が月 10 件程度しかないような系列では個別の予測が不安定になり、集約しても精度が出にくくなります。
トップダウン(Top-Down) #
全社レベルで予測し、過去の構成比率(たとえば直近 12 か月の平均シェア)で下位レベルに配分します。全社売上のような上位の系列はノイズが打ち消し合って安定していることが多く、1 本の予測に集中できるので予測精度が出やすいのが利点です。欠点は、構成比率が変わる場面に弱いことで、新製品の投入や既存製品の販売終了でシェアが月ごとに動くと、過去の比率で配分した下位の予測は実態からずれます。
最適調整(Optimal Reconciliation) #
全レベルで独立に予測し、最小分散基準などで整合性を満たすように事後調整します。MinT(Minimum Trace)と呼ばれる方法では、各レベルの予測誤差の共分散行列 \(W\) と集約行列 \(S\) を使って、整合した予測 \(\tilde{y} = S (S^\top W^{-1} S)^{-1} S^\top W^{-1} \hat{y}\) を求めます。各レベルの情報を最大限に使えるので、ボトムアップとトップダウンの中間で精度と整合性を両立できるのが利点です。欠点は、共分散行列 \(W\) の推定が必要で、系列数が 100 を超えると実装も計算も複雑になることです。
Pythonでの実装例 #
scikit-hts や hierarchicalforecast などのライブラリで階層的予測を実装できます。ここではライブラリを使わず、階層の定義・データ生成・ボトムアップ予測の 3 ステップを素の pandas と statsmodels で書いて仕組みを確かめます。
| |
次のコードは、末端の製品 4 系列をランダムウォークで 24 か月分作り、hierarchy の定義どおりに足し上げて事業部と全社の系列を作ります。観測の段階では「合計が一致する」ことが定義上保証されています。
| |
ボトムアップ予測の簡易例 #
末端の 4 系列だけを ExponentialSmoothing(trend="add") で 6 か月先まで予測し、上位は hierarchy に沿って足し上げます。最後に全社の予測が事業部 A と B の予測の和と一致するかを np.allclose で検証します。
| |
ボトムアップでは定義上、整合性が常に保たれ、np.allclose は True を返します。トップダウンや各レベルの独立予測では、全社の予測と事業部の予測の和がずれるので、構成比での配分や MinT のような事後調整が必要です。
使いどころと落とし穴 #
ボトムアップが向くのは、製品や店舗ごとの個別の動き(新製品の立ち上がりや特定店舗の改装)を予測に反映したい場面で、末端の系列がある程度の量(月数十件以上)を持っているときです。末端が月数件のまばらな系列ばかりなら、ノイズが積み上がって全社の予測が暴れるので、安定した全社の予測を構成比で配分するトップダウンの方が精度が出ます。両者の欠点を避けたいときは MinT を使いますが、共分散行列 \(W\) の推定に全系列の学習期間内残差が必要で、系列数が 100 を超えると hierarchicalforecast のようなライブラリに任せた方が確実です。もう一つの落とし穴は、負の予測値です。末端で trend="add" の予測が下がり続けて 0 を割ると、合算した上位の予測も実態からずれるので、売上のような非負の系列では対数変換や damped_trend=True で予測が発散しないようにします。
- ARIMA モデル — 階層各レベルで使える古典的予測モデル
- Prophetを使ってみる — Prophetで時系列を分解して予測
- STL 分解とフォーキャスト — STL分解後の残差にARIMAを適用して予測