04.13.1
AR過程
create_ARdata で \(\phi = 0.1, 1, 1.04\) の 3 系列を 500 点ずつ生成してこの違いを図で確かめ、AR(2) に拡張したあと statsmodels の AutoReg(lags=1) で係数を推定して真の値 0.1 と見比べます。直感 #
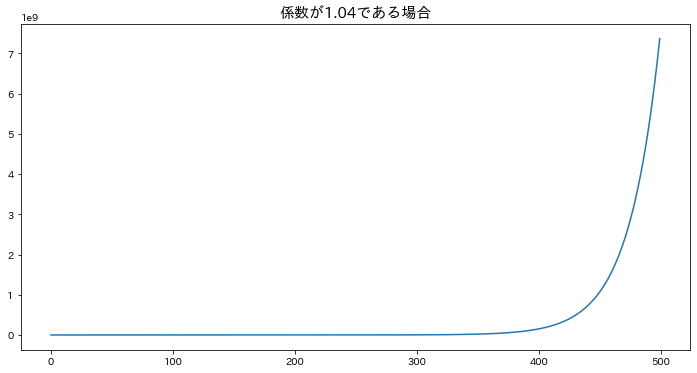
今日の最高気温は昨日の最高気温と 2〜3 ℃ しか違わず、昨日は一昨日に近い。けれど昨日の気温を「そのまま」引きずるのではなく、平年値に向かって少し戻る。この「昨日の値 × 1 未満の係数 + 揺らぎ」が AR(1) 過程で、係数 \(\phi\) が「昨日をどれだけ引きずるか」を表します。\(\phi\) が 1 だと戻る力がゼロになって株価のようにどこへでも行き、1.04 のようにわずかでも 1 を超えると雪だるま式に膨らんで 500 点のうちに桁が変わります。
式で書くと何を引きずっているか #
AR(p) 過程は、過去 \(p\) 期の自分自身の値に係数 \(\phi_1, \dots, \phi_p\) を掛けて足し、定数 \(c\) とノイズ \(\epsilon_t\) を加えたものです。
$$ y_t = c + \phi_1 y_{t-1} + \phi_2 y_{t-2} + \cdots + \phi_p y_{t-p} + \epsilon_t $$AR(1) なら \(y_t = c + \phi_1 y_{t-1} + \epsilon_t\) で、\(|\phi_1| < 1\) のとき平均は \(c / (1 - \phi_1)\) に落ち着きます。下のコードでは \(c = 1\)、\(\phi_1 = 0.1\) なので、系列は \(1 / 0.9 \approx 1.11\) の周りで揺れることになります。MA過程 との違いは、引きずる相手が過去の値 \(y_{t-1}\) か過去のノイズ \(\epsilon_{t-1}\) かという点です。
使うライブラリ #
| |
AR過程のデータを作成する #
次の関数は上の式を for ループで書き下したものです。phis の長さが次数 \(p\) になり、c が定数項、sigma がノイズの標準偏差を決めます。
| |
係数が1より小さい場合(定常) #
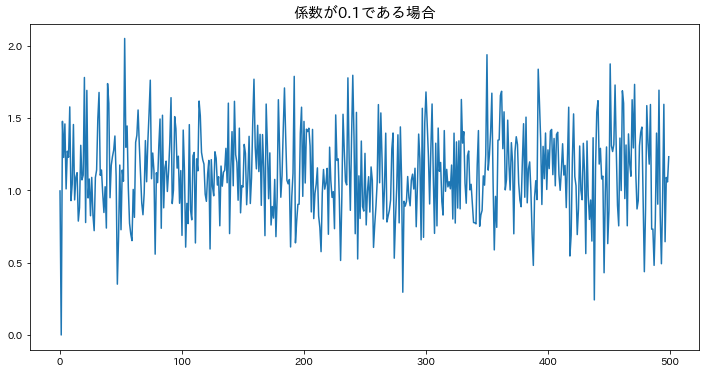
\(\phi_1 = 0.1\) で 500 点を生成します。平均 \(1/0.9 \approx 1.11\) の周りを離れない、定常な系列になります。
| |
==AR(1)過程の長さ500のデータを作成==
係数が1である場合(ランダムウォーク) #
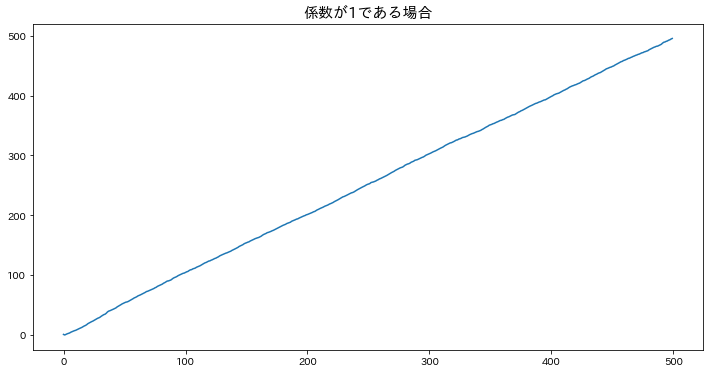
\(\phi_1 = 1\) にすると「昨日の値 + 1 + ノイズ」になり、平均に戻る力が消えます。
| |
==AR(1)過程の長さ500のデータを作成==
係数が1より大きい場合(発散) #
\(\phi_1 = 1.04\) と、1 をわずかに超えただけで系列は指数的に膨らみます。
| |
==AR(1)過程の長さ500のデータを作成==
何が起きているか(ステップで見る) #
コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。
見るポイント:φ が 1 に近いほど前の値を引きずり、波がゆっくりになる。負なら 1 期ごとに符号が反転しやすい。
AR(2) #
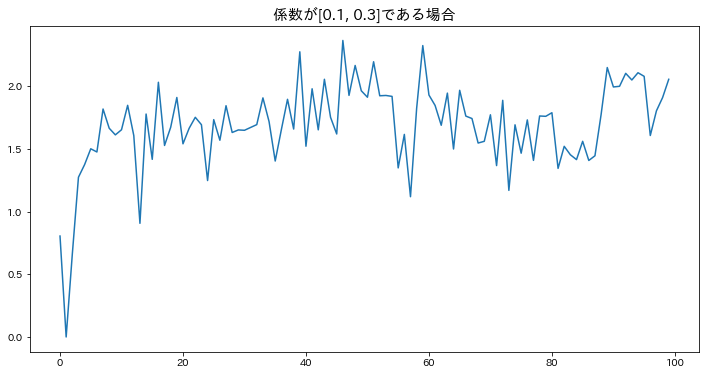
係数を 2 個にすると、2 期前の値も今日に影響します。まず \(\phi = (0.1, 0.3)\) の定常な例を 100 点だけ描きます。
| |
==AR(2)過程の長さ100のデータを作成==
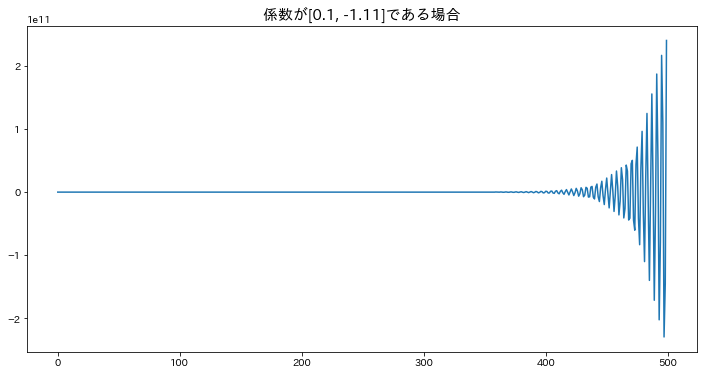
次に \(\phi_2 = -1.11\) と、定常条件 \(|\phi_2| < 1\) を破る係数にしてみます。
| |
==AR(2)過程の長さ500のデータを作成==
モデルの推定 #
生成した ar1_1(真の係数 0.1)に AutoReg を当て、係数が復元できるかを確かめます。情報量規準 AIC・HQIC・BIC は次数選びの比較に使う値です。
| |
AIC: 231.486, HQIC: 236.445, BIC: 244.124
| |
[1.03832755 0.07236388]
0.09199676371696269
| Dep. Variable: | y | No. Observations: | 500 |
|---|---|---|---|
| Model: | AutoReg(1) | Log Likelihood | -112.743 |
| Method: | Conditional MLE | S.D. of innovations | 0.303 |
| Date: | Sat, 13 Aug 2022 | AIC | 231.486 |
| Time: | 01:55:17 | BIC | 244.124 |
| Sample: | 1 | HQIC | 236.445 |
| 500 |
| coef | std err | z | P>|z| | [0.025 | 0.975] | |
|---|---|---|---|---|---|---|
| const | 1.0383 | 0.052 | 20.059 | 0.000 | 0.937 | 1.140 |
| y.L1 | 0.0724 | 0.045 | 1.621 | 0.105 | -0.015 | 0.160 |
| Real | Imaginary | Modulus | Frequency | |
|---|---|---|---|---|
| AR.1 | 13.8190 | +0.0000j | 13.8190 | 0.0000 |
使いどころと落とし穴 #
AR 過程を実データに当てる前に、まず図と ADF 検定で定常かどうかを確かめます。\(\phi = 1\) の例のように単位根があると AutoReg の係数は信頼できず、差分を取って定常にしてから当てる必要があります。次数 \(p\) は PACF がどのラグで途切れるかを目安にし、迷ったら lags を変えて AIC か BIC が最小になるものを選びます。AR は「過去の値を引きずる」成分しか表せないので、ショックが数期だけ尾を引く構造は MA過程、両方が混ざるなら ARMA を検討してください。
- MA過程 — 誤差項の線形結合で現在の値を表す確率過程
- 自己回帰 (AR) モデル — AR過程に基づく実用的な予測モデル
- 自己相関関数 (ACF) — AR過程の次数特定に使うラグ相関