04.14.4
tsfresh
extract_features(X, column_id="id", column_sort="time") の 1 行で済みます。このページでは id と time と 4 本の値列(fx1〜fx4)を持つ長い形式の DataFrame を人工的に作り、100 本の系列から 3,156 列の特徴量が生成されることを確かめます。できた表は scikit-learn のモデルにそのまま渡せ、tsfresh.feature_selection で目的変数と関係のある列だけに絞ることもできます。直感 #
100 台のセンサーから 10 日分ずつの温度が届いたとして、「どのセンサーが故障しかけているか」を分類したいとします。10 日分の数値 10 個をそのまま特徴量にすると、1 日ずれただけで別の値になり、長さの違う系列も扱えません。代わりに「平均 23.1、最大 27.5、1 日前との自己相関 0.8、変化の絶対値の平均 0.4」のように要約すれば、長さに関係なく 1 行で表せます。tsfresh はこの要約を人手で考えません。統計量・周波数・エントロピーなど数百種類の計算式を全列に当て、後で select_features で選別する前提で「とりあえず全部」作ります。
時系列データを扱うとき、タイムスタンプと数値の列をもとにさまざまな特徴量を計算することがあります。このページでは tsfresh を用いて時系列データから特徴量を計算してみます。
tsfresh #
Overview on extracted featuresを参考に、どんな特徴量が作成されるか確認してみます。まず、tsfresh が要求する「長い形式」(1 行が 1 時点、id 列で系列を区別、time 列で順序を示す)の DataFrame を人工的に作ります。
| |
| id | time | fx1 | fx2 | fx3 | fx4 | |
|---|---|---|---|---|---|---|
| 0 | 0 | 0 | 0.099833 | 0.995004 | 0.100335 | -2.302585 |
| 1 | 0 | 1 | 1.099833 | 1.995004 | 1.100335 | 0.095310 |
| 2 | 0 | 2 | 2.099833 | 0.995004 | 2.100335 | 0.741937 |
| 3 | 0 | 3 | 3.099833 | 1.995004 | 0.100335 | 1.131402 |
| 4 | 0 | 4 | 4.099833 | 0.995004 | 1.100335 | 1.410987 |
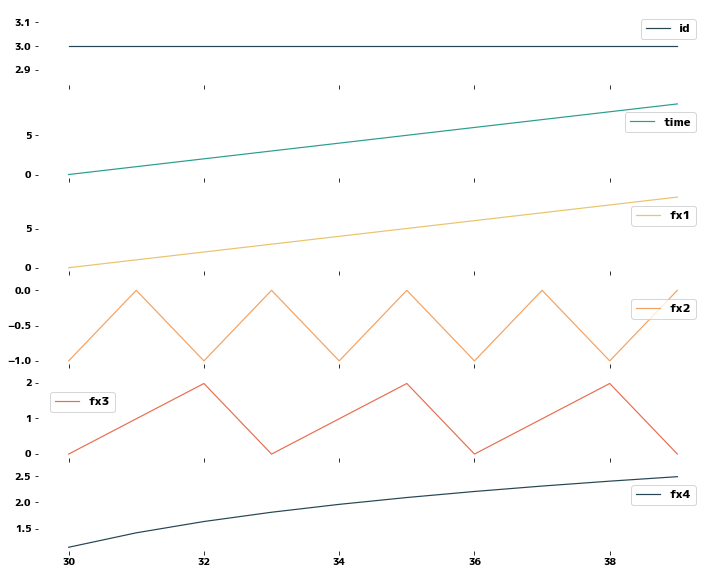
id == 3 の系列だけを取り出し、4 本の値列を縦に並べて形を確かめます。
| |
何が起きているか(ステップで見る) #
コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。
見るポイント:DTW は時間を伸び縮みさせて形を合わせる。タイミングがずれた似た波形を「近い」と判定できる。
特徴量を計算する #
extract_features を使って、一気にすべての特徴量を計算することができます。1,000 行の入力が 100 行 × 3,156 列の表になり、1 行が 1 本の系列に対応します。tsfresh.feature_selection 以下の関数を用いることで、目的変数と統計的に関係のある列だけに絞る特徴選択も実行できます。
| |
Feature Extraction: 100%|█
| fx1__variance_larger_than_standard_deviation | fx1__has_duplicate_max | fx1__has_duplicate_min | fx1__has_duplicate | fx1__sum_values | fx1__abs_energy | fx1__mean_abs_change | fx1__mean_change | fx1__mean_second_derivative_central | fx1__median | ... | fx4__permutation_entropy__dimension_6__tau_1 | fx4__permutation_entropy__dimension_7__tau_1 | fx4__query_similarity_count__query_None__threshold_0.0 | fx4__matrix_profile__feature_"min"__threshold_0.98 | fx4__matrix_profile__feature_"max"__threshold_0.98 | fx4__matrix_profile__feature_"mean"__threshold_0.98 | fx4__matrix_profile__feature_"median"__threshold_0.98 | fx4__matrix_profile__feature_"25"__threshold_0.98 | fx4__matrix_profile__feature_"75"__threshold_0.98 | fx4__mean_n_absolute_max__number_of_maxima_7 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1.0 | 0.0 | 0.0 | 0.0 | 45.998334 | 294.084675 | 1.0 | 1.0 | -3.469447e-18 | 4.599833 | ... | -0.0 | -0.0 | NaN | NaN | NaN | NaN | NaN | NaN | NaN | 1.915905 |
| 1 | 1.0 | 0.0 | 0.0 | 0.0 | 53.952941 | 373.591982 | 1.0 | 1.0 | -6.938894e-18 | 5.395294 | ... | -0.0 | -0.0 | NaN | NaN | NaN | NaN | NaN | NaN | NaN | 1.918724 |
| 2 | 1.0 | 0.0 | 0.0 | 0.0 | 53.538882 | 369.141186 | 1.0 | 1.0 | 0.000000e+00 | 5.353888 | ... | -0.0 | -0.0 | NaN | NaN | NaN | NaN | NaN | NaN | NaN | 2.062001 |
| 3 | 1.0 | 0.0 | 0.0 | 0.0 | 45.143194 | 286.290800 | 1.0 | 1.0 | -8.673617e-19 | 4.514319 | ... | -0.0 | -0.0 | NaN | NaN | NaN | NaN | NaN | NaN | NaN | 2.186180 |
| 4 | 1.0 | 0.0 | 0.0 | 0.0 | 36.613658 | 216.555992 | 1.0 | 1.0 | 0.000000e+00 | 3.661366 | ... | -0.0 | -0.0 | NaN | NaN | NaN | NaN | NaN | NaN | NaN | 2.295964 |
5 rows × 3156 columns
使いどころと落とし穴 #
3,156 列のうち大半は目的変数と無関係か、互いにほぼ同じ情報を持つ列です。分類や回帰に使う前に select_features(extracted_features, y) で仮説検定に基づく選別をかけるか、extract_relevant_features(X, y, column_id="id", column_sort="time") で抽出と選別を一度に済ませます。列数が系列数(この例では 100)を大きく超える状態でそのまま木モデルや線形モデルに渡すと過学習しやすいので、選別後の列数を確認してから学習に進みます。計算時間は値列数 × 系列数 × 特徴量数に比例するため、最初は MinimalFCParameters() で流れを確認し、効果が見えたら既定の設定に広げるのが安全です。長さが 10 程度の短い系列では、表の右側のように NaN になる特徴量が多く出るので、impute で埋めてから使います。
- 動的時間伸縮 (DTW) — 時間軸のずれを許容して距離を最小化
- DTWとDDTW — 微分値を使ってDTWの弱点を補う手法
- 移動平均と移動標準偏差 — トレンドとばらつきの変化を同時に確認