04.14.5
Soft-DTW(Differentiable Dynamic Time Warping)
soft_dtw を 20 行で実装し、\(\gamma\) を 0.01 から 5.0 まで 4 段階に変えて DTW と比べたあと、tslearn.metrics.soft_dtw_gradient で入力系列に対する勾配を取り出します。動的時間伸縮(DTW) で累積コスト行列と \(\min\) による遷移式を先に見ておくと、このページで置き換える箇所が 1 行だけだと分かります。
Cuturi, Marco, and Mathieu Blondel. “Soft-DTW: a Differentiable Loss Function for Time-Series.” ICML 2017. (PDF)
直感 #
迷路で最短経路を 1 本だけ選ぶのが DTW です。壁を 1 mm 動かしても最短経路は同じか、別の経路に突然切り替わるかのどちらかで、「経路の長さが壁の位置に対してどう変わるか」という傾きが定義できません。Soft-DTW は「すべての経路を、短いものほど大きな重みで足し合わせる」と考え直します。\(\gamma\) が小さいと最短経路だけが残って DTW と同じ値になり、\(\gamma\) が大きいと遠回りの経路の寄与も混ざって、1 本の経路の長さとは別の値になります。この足し合わせは壁の位置をわずかに動かすと滑らかに変わるので、勾配が定義でき、「予測した波形を正解の波形に近づける」学習に使えます。
Soft-DTW とは #
Dynamic Time Warping(DTW)は最小コスト経路を厳格に選ぶため、距離関数は非凸であり、ワーピングパスも 1 通りに決まります。一方で、ニューラルネットの損失関数として DTW をそのまま使おうとすると、\(\min\) が微分できないため勾配を求められません。
Soft-DTW はこの「最小」を soft-min(滑らかな最小演算)に置き換えることで、なめらかな距離関数を定義します。スムージング係数 \(\gamma > 0\) を導入し、累積コスト更新式を
$$ R_{i,j} = D_{i,j} + \text{softmin}\bigl(R_{i-1,j},\ R_{i,j-1},\ R_{i-1,j-1}\bigr) $$とします。ここで
$$ \text{softmin}(a,b,c) = -\gamma \log\bigl(\exp(-a/\gamma) + \exp(-b/\gamma) + \exp(-c/\gamma)\bigr) $$と定義すると、\(\gamma\) を小さくすると DTW に漸近し、\(\gamma\) が大きいほど平均化された距離になります。\(a\) が他より 10 以上小さければ \(\exp(-a/\gamma)\) だけが残って \(\min\) と同じ値を返し、3 つが近い値のときだけ \(\min\) より少し小さい値になるのが soft-min の性質です。Soft-DTW は勾配を解析的に求められるため、ニューラルネットワークなどで時系列の形状を意識した損失関数として用いられます。
何が起きているか(ステップで見る) #
コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。
見るポイント:DTW は時間を伸び縮みさせて形を合わせる。タイミングがずれた似た波形を「近い」と判定できる。
アルゴリズムの流れ #
まず通常の DTW と同様に、\(D_{i,j} = |x_i - y_j|^2\) などで局所距離の行列を作ります。次に累積コスト行列 \(R\) を初期化し、上の soft-min を使って動的計画法で左上から右下へ埋めていきます。\(\exp(-a/\gamma)\) は \(a\) が大きいと 0 にアンダーフローするため、実装では最小値を先に引いてから指数を取る log-sum-exp の技巧を使います。最後に Soft-DTW の値を \(R_{n,m}\)(必要に応じて正規化)として取り出します。\(\gamma\) が 0 に近づくほど経路が鋭くなり、DTW に収束します。計算量は DTW と同じ \(O(nm)\) ですが、各マスで exp と log を呼ぶ分だけ定数倍だけ重くなります。
Python で Soft-DTW を実装する #
以下は NumPy だけで Soft-DTW を計算する簡易実装です。DTW の実装と比べると、min(...) が softmin_three(...) に替わり、局所距離が絶対値から二乗になった 2 点だけが違います。
| |
Soft-DTW を正確に微分したい場合は、上記論文に示された後方パスを実装するか、tslearn.metrics.soft_dtw(tslearn 0.5 以降)など既存ライブラリを利用します。
DTW と Soft-DTW を比較する #
Soft-DTW が \(\gamma\) によって DTW とユークリッド距離の間を補間する様子を、sin 波(A)、位相を 0.4 ずらして振幅を 5% 増やした B、cos 波の C の 3 本で確認します。
| |
| |
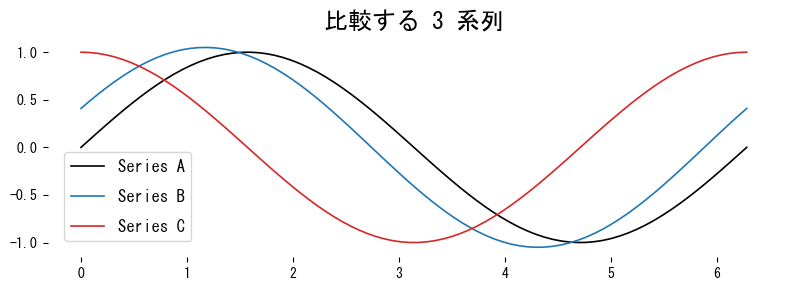
比較用に通常の DTW を定義し、gamma を 0.01 から 5.0 まで 4 段階に変えて Soft-DTW の値を並べます。
| |
| |
上の出力は元のノートブック環境で得たもので、\(\gamma\) が小さいうちは Soft-DTW が DTW に近い値を取り、\(\gamma\) を大きくするほど DTW から離れていく傾向を示しています。Soft-DTW の値は局所距離の定義(絶対値か二乗か)と gamma に強く依存し、上の soft_dtw 実装では \(-\gamma \log 3\) の項が積み重なるため gamma が大きいと負の値も取ります。数値そのものより、「\(\gamma \to 0\) で DTW に一致し、\(\gamma\) が大きいほど 1 本の経路の長さから離れる」という向きを押さえてください。
勾配が欲しい場合 #
Soft-DTW の利点は微分可能性にあります。自分で後方パスを実装しない場合は、tslearn の soft_dtw_gradient で入力系列に対する勾配をそのまま取り出せます。
| |
| |
図の再生成は python scripts/generate_timeseries_assets.py --pattern shape/005_soft_dtw を利用してください。
soft_dtw_gradient は入力系列に対する損失の勾配を返すので、ニューラルネットワークの学習ループに組み込むことができます。
まとめ #
Soft-DTW は DTW の遷移式にある \(\min\) を、\(\gamma\) つきの log-sum-exp(soft-min)に置き換えただけの距離で、実装上の違いも min の 1 行です。soft-min は \(\min\) を超えないので、\(\gamma = 0.01\) では DTW とほぼ同じ値になり、\(\gamma\) を 5.0 まで上げると \(-\gamma \log 3\) の項が積み重なって 1 本の経路の長さとは別の値(負にもなり得る)に変わります。損失関数に使う \(\gamma\) は、形の近い組の方が小さいという順序が保たれる範囲から選びます。微分できるので tslearn.metrics.soft_dtw_gradient や SoftDTWLossPyTorch を通してニューラルネットの損失関数にでき、「タイミングが少しずれても形が合っていれば損失が小さい」学習が可能になります。
- 動的時間伸縮 (DTW) — 時間軸のずれを許容して距離を最小化
- DTWとDDTW — 微分値を使ってDTWの弱点を補う手法
- tsfreshで特徴量を抽出 — 時系列から自動的に大量の特徴量を生成