04.17.2
Isolation Forest
pd.get_dummies で曜日などのカテゴリ列をダミー化してから IsolationForest(n_estimators=100, contamination=0.01) で検出します。最後に plot_tree で 1 本目の木を描き、異常点が「特徴1 が大きい」という分岐で孤立していることを確かめます。直感 #
教室の 30 人を「身長 165 cm 以上か」「誕生月が 6 月より前か」のように、適当な質問でランダムに 2 つに分けていくとします。大半の生徒は似た答えになるので、1 人だけに絞るには質問を 5〜6 回繰り返す必要があります。ところが身長 200 cm の生徒がいれば、「身長 190 cm 以上か」の 1 問で孤立します。Isolation Forest はこの「孤立するまでの質問数」をたくさんの木で平均し、少ない質問で孤立する点を異常と判定します。ラベルは要らず、距離や密度の計算もしないので、列が 25 本あっても 365 行なら 1 秒で終わります。
何が起きているか(ステップで見る) #
コードを読む前に、この手法が図の上で何をしているかを追ってみましょう。「再生」を押すか、スライダーを動かすと 1 手順ずつ進みます。
見るポイント:少ない回数で孤立する点ほど異常。外れ値は 2〜3 回、密集した点は何度切っても仲間が残る。
Isolation Forest #
Isolation Forest を使って異常値を検出してみます。時系列データの中に異常値を混ぜ、それが検出できるかどうか検証します。最後に異常値と判定したルールを可視化します。
| |
人工データの作成 #
[11, 49, 149, 240, 300, 310] の日付に異常値を混ぜておきます。月や曜日のカテゴリ変数、天気の記号など数値でない特徴も含むデータで、数値の 3 列だけをプロットします。
| |
<Axes: >
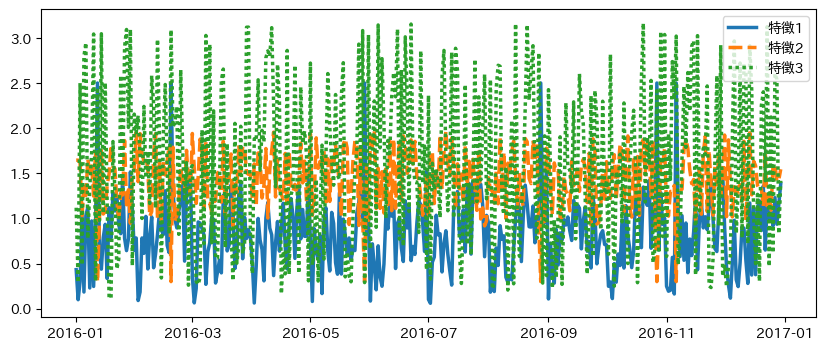
表の中身を確認します。
| |
| 月 | 曜日 | 特徴1 | 特徴2 | 特徴3 | 特徴4 | |
|---|---|---|---|---|---|---|
| 2016-01-01 | 01 | Friday | 0.432678 | 1.645027 | 1.118289 | ☀ |
| 2016-01-02 | 01 | Saturday | 0.099463 | 1.645734 | 0.289383 | ☀ |
| 2016-01-03 | 01 | Sunday | 0.297490 | 1.613958 | 2.499115 | ☀ |
| 2016-01-04 | 01 | Monday | 1.043077 | 1.029947 | 0.484240 | ☀ |
| 2016-01-05 | 01 | Tuesday | 0.184797 | 1.355265 | 2.795718 | ☁ |
| ... | ... | ... | ... | ... | ... | ... |
| 2016-12-26 | 12 | Monday | 0.914207 | 1.580330 | 0.617349 | ☂ |
| 2016-12-27 | 12 | Tuesday | 1.229753 | 1.599599 | 2.605319 | ☀ |
| 2016-12-28 | 12 | Wednesday | 0.936100 | 1.408378 | 2.540507 | ☀ |
| 2016-12-29 | 12 | Thursday | 1.156575 | 1.428601 | 0.831889 | ☀ |
| 2016-12-30 | 12 | Friday | 1.383185 | 1.544629 | 1.416885 | ☁ |
365 rows × 6 columns
カテゴリ変数の変換 #
「曜日」のような特徴を Isolation Forest で扱うために、pd.get_dummies で 0/1 のダミー変数に変換します。
| |
| 特徴1 | 特徴2 | 特徴3 | 月_01 | 月_02 | ... | 曜日_Thursday | 曜日_Tuesday | 曜日_Wednesday | 特徴4_☀ | 特徴4_☁ | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 2016-01-01 | 0.432678 | 1.645027 | 1.118289 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | ... |
| 2016-01-02 | 0.099463 | 1.645734 | 0.289383 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | ... |
| 2016-01-03 | 0.297490 | 1.613958 | 2.499115 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | ... |
| 2016-01-04 | 1.043077 | 1.029947 | 0.484240 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | ... |
| 2016-01-05 | 0.184797 | 1.355265 | 2.795718 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | ... |
| ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... |
| 2016-12-26 | 0.914207 | 1.580330 | 0.617349 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... |
| 2016-12-27 | 1.229753 | 1.599599 | 2.605319 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... |
| 2016-12-28 | 0.936100 | 1.408378 | 2.540507 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... |
| 2016-12-29 | 1.156575 | 1.428601 | 0.831889 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... |
| 2016-12-30 | 1.383185 | 1.544629 | 1.416885 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... |
365 rows × 25 columns
Isolation Forestの作成 #
100 本の木を作り、全 365 行のスコアを計算して「異常かどうか」の真偽値と連続値のスコアを data に書き戻します。
| |
検出した日付と正解の比較 #
異常値として検出したタイミングと、仕込んだ正解の位置を縦線で比べます。
| |
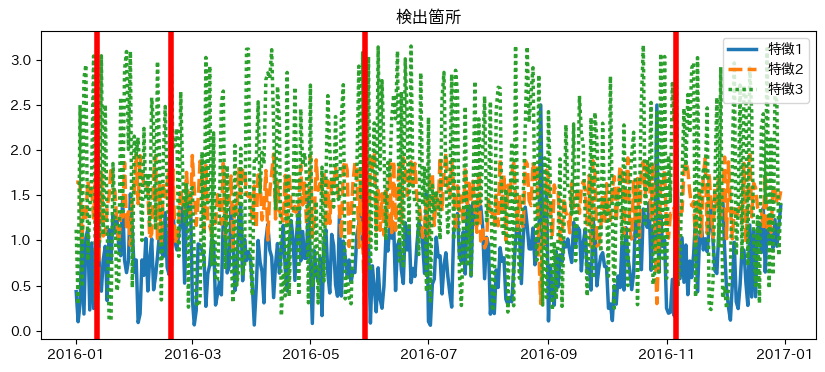
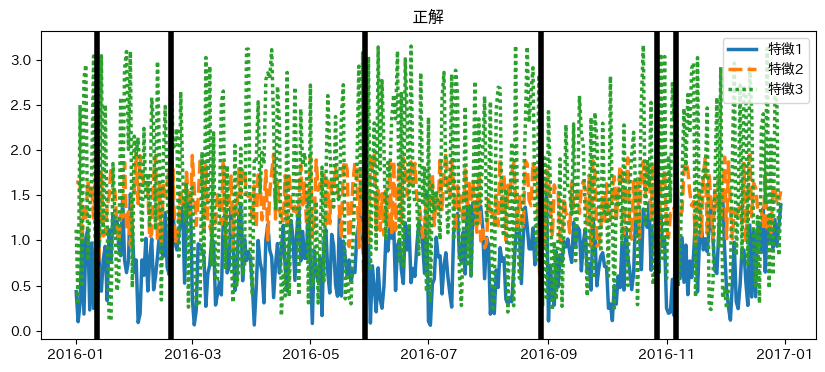
異常値のルール #
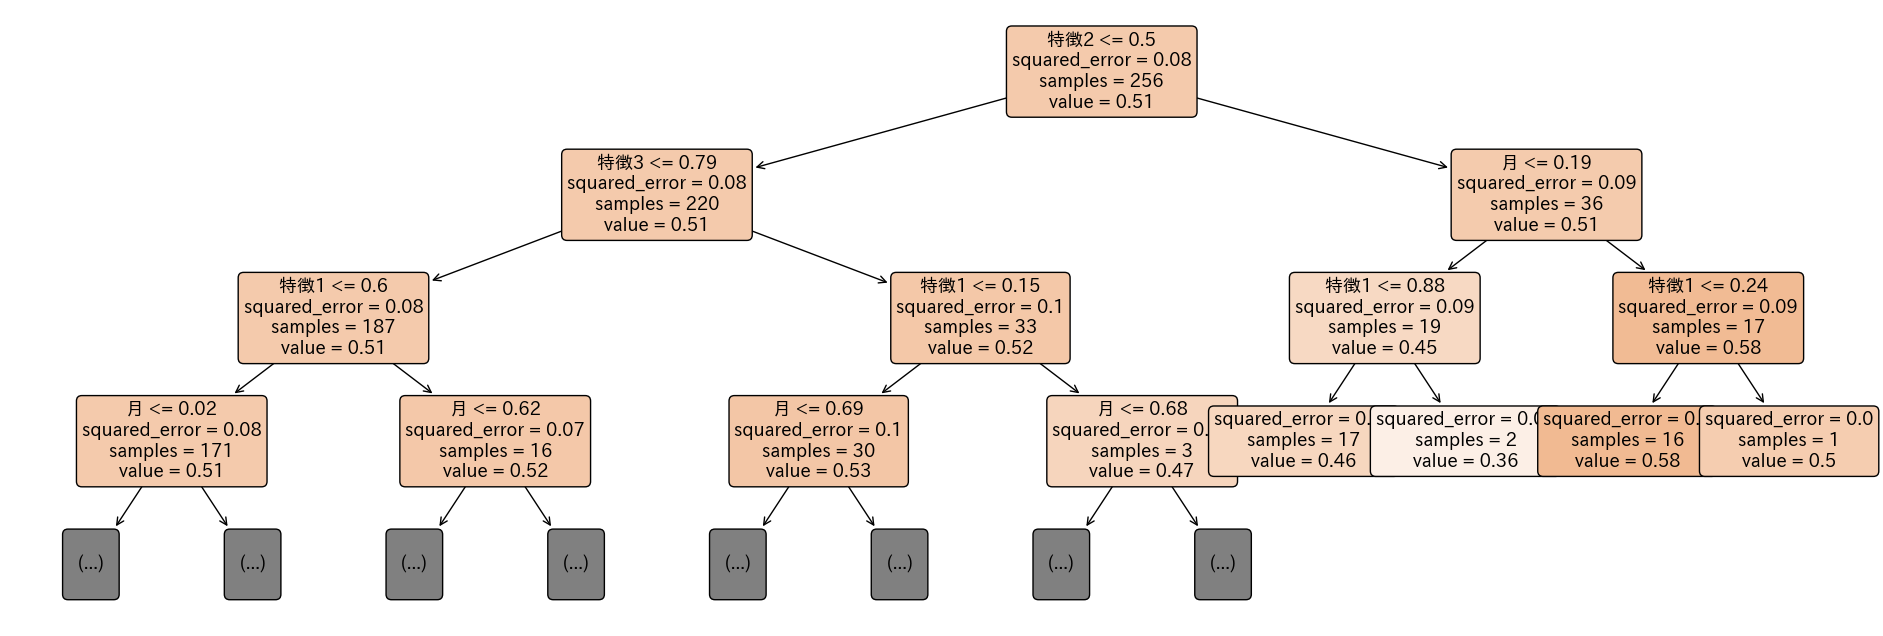
100 本のうち 1 本目の木を深さ 3 まで描きます。サンプル数(samples)が 1 の葉が一番右にあり、それが特徴1 による分岐の先にあることが分かります。実際、今回の異常値は特徴1 が 2.5 と大きすぎる値のときに孤立しています。
| |
使いどころと落とし穴 #
Isolation Forest は距離を計算しないので列数が増えても速く、スケールの違う列を混ぜても動きますが、このページのように 0/1 のダミー列が 22 本もあると、分割に選ばれる列の大半がダミーになって異常が埋もれます。カテゴリ列は本当に必要なものだけ残すか、max_features を全列にして特徴1・2 が毎回候補に入るようにします。contamination は「何割を異常と呼ぶか」を決めるだけで検出力は変えないので、異常の割合が分からないときは decision_function のスコアを見てヒストグラムの切れ目で閾値を決めます。時系列に使うときは、このページのように各時点を独立な行として扱うため、「前日との差」や「移動平均からのずれ」を列に足さないと、季節的に高い値を異常と誤判定しがちです。
- rupturesで変化点検出 — rupturesライブラリで変化点を自動検出
- Zスコアで異常値検出 — 閾値超えの観測点を異常値として検出
- Isolation Forest (基本) — 機械学習アルゴリズムとしてのIsolation Forest